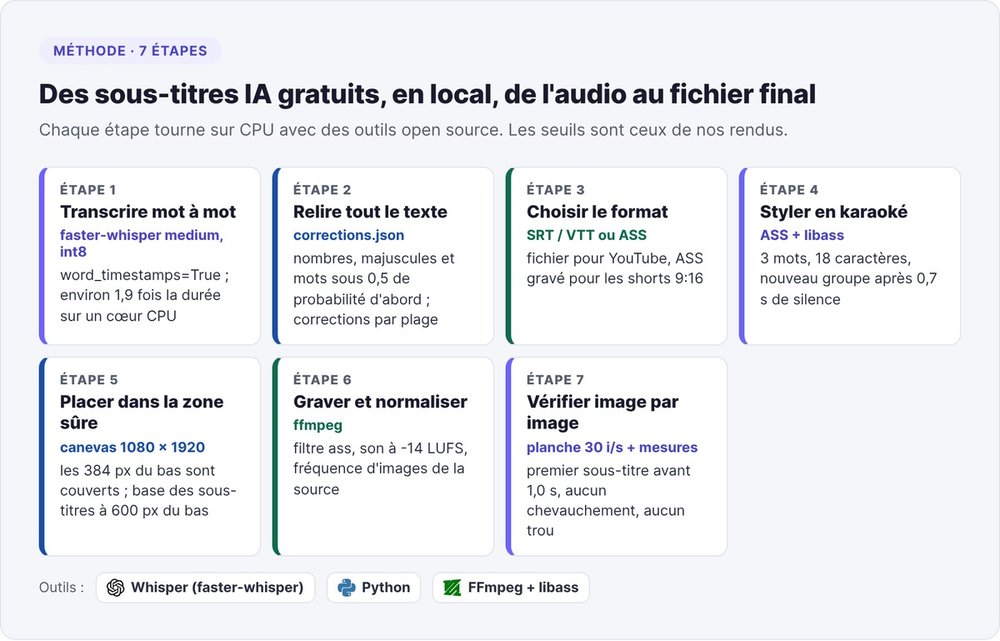
Pour obtenir des sous-titres IA gratuits sans quota ni filigrane, faites tourner la reconnaissance vocale sur votre machine. Cinq opérations suffisent : transcrire l'audio mot à mot avec faster-whisper, relire toute la transcription, choisir le format (fichier SRT ou sous-titres incrustés), styler les sous-titres en karaoké, puis les graver avec ffmpeg et vérifier le rendu image par image. Chaque brique est open source et tourne sur CPU, sans carte graphique ni abonnement.
Nous appliquons cette méthode à des talks et des pitchs filmés, recadrés en 9:16 pour les réseaux. Sur un seul cœur de processeur, le modèle medium de Whisper transcrit un clip en 1,9 fois sa durée environ, et il se trompe encore assez souvent pour qu'on relise chaque mot avant de l'afficher. Ce tuto donne nos commandes, nos seuils (3 mots par groupe, coupure après 0,7 seconde de silence, son à -14 LUFS) et les pièges qui nous ont coûté le plus de versions. Pour découper une vidéo longue en plusieurs clips, voyez notre guide pour créer des shorts avec l'IA.
Sous-titres IA gratuits : outil en ligne ou chaîne locale
Les générateurs de sous-titres gratuits en ligne (YouTube Studio, CapCut, VEED, Submagic) suivent tous le même parcours : import, transcription, correction dans un éditeur, export.
Les limites des offres gratuites en ligne
Les formules gratuites se paient en minutes par jour ou par mois, en filigrane, en export limité en définition ou en nombre de vidéos. Les sous-titres IA automatiques de YouTube Studio restent gratuits sans limite, mais ils vivent sur YouTube et leur style se règle peu. Avec un extrait par semaine, vous atteignez vite ces plafonds.
En local, vous ne payez que du temps de calcul, vous réglez tout (modèle, relecture, police, couleur, position) et vos vidéos restent sur votre machine.
L'installation locale
- Python 3.9 ou plus et faster-whisper, la réimplémentation de Whisper qui annonce une vitesse jusqu'à 4 fois supérieure à openai/whisper pour la même précision, avec une quantification int8 utilisable sur CPU, sous licence MIT.
- ffmpeg compilé avec libass, la bibliothèque qui dessine les sous-titres ASS dans l'image. Vérifiez avec
ffmpeg -h filter=ass. - Les polices de vos sous-titres, installées dans le système (
fc-list | grep Inter).
pip install faster-whisper
# si pip répond "externally-managed-environment" :
pip install --break-system-packages faster-whisper
Ce second cas nous a bloqués au premier essai : sur les distributions récentes, pip install échoue hors environnement virtuel.
Étape 1 : transcrire mot à mot avec faster-whisper
Un karaoké demande un horodatage par mot. Demandez-le avec word_timestamps=True, après avoir extrait l'audio en mono 16 kHz :
ffmpeg -i video.mp4 -vn -ac 1 -ar 16000 audio.wav
import json
from faster_whisper import WhisperModel

model = WhisperModel("medium", device="cpu", compute_type="int8")
segments, info = model.transcribe(
    "audio.wav", language="fr", word_timestamps=True,
    initial_prompt="Prénom Nom, NomDeLaSociété, SaaS, ARR, onboarding.",
    vad_filter=True, vad_parameters=dict(min_silence_duration_ms=400))

words = [{"word": w.word.strip(), "start": round(w.start, 3),
          "end": round(w.end, 3), "prob": round(w.probability, 2)}
         for s in segments for w in (s.words or []) if w.word.strip()]
json.dump(words, open("words.json", "w"), ensure_ascii=False, indent=1)
Gardez la probabilité de chaque mot, vous en aurez besoin à la relecture.
Choisir medium pour le français
| Modèle | Temps sur un cœur CPU | Usage |
|---|---|---|
small |
plus rapide | repérer les passages, jamais pour l'affichage |
medium |
environ 1,9 fois la durée de l'audio | sous-titres en français, notre défaut |
large-v3 |
environ 6 fois la durée, plus de mémoire | un passage difficile, recoupé seul |
Avec small, nous avons lu « le vélamin » pour « levez la main » sur un pitch. Avec large-v3, vous attendez trois fois plus longtemps qu'avec medium pour un gain rare : on le réserve aux fenêtres ambiguës de l'étape 2. La transcription dure plus longtemps que la vidéo : lancez-la en tâche de fond.
Amorcer les noms propres
En français, Whisper écrase les noms anglais. Sur un pitch, nous avons vu le nom d'une startup, trois mots anglais, sortir en un seul mot inventé, dans la vidéo de promotion de cette même startup. Deux protections :
- L'amorce. Passez dans
initial_promptune phrase courte qui épelle l'orateur, la société, le produit et les sigles du métier. Restez bref : un prompt long peut fuiter dans la transcription. - La table de remplacement. Un dictionnaire
{"mot fautif en minuscules": "Bonne Orthographe"}, appliqué après la transcription. Le remplacement reprend le début et la fin du jeton d'origine : le karaoké reste calé, et un nom de plusieurs mots s'allume en bloc.
Pour les fautes imprévues, il faut relire.
Étape 2 : relire toute la transcription
Nous lisons chaque mot de la transcription avant de graver le moindre sous-titre, et nous ne livrons aucun clip non relu : un mot absurde à l'écran coûte autant qu'un nom de marque écorché.
Les fautes de Whisper sur du français courant
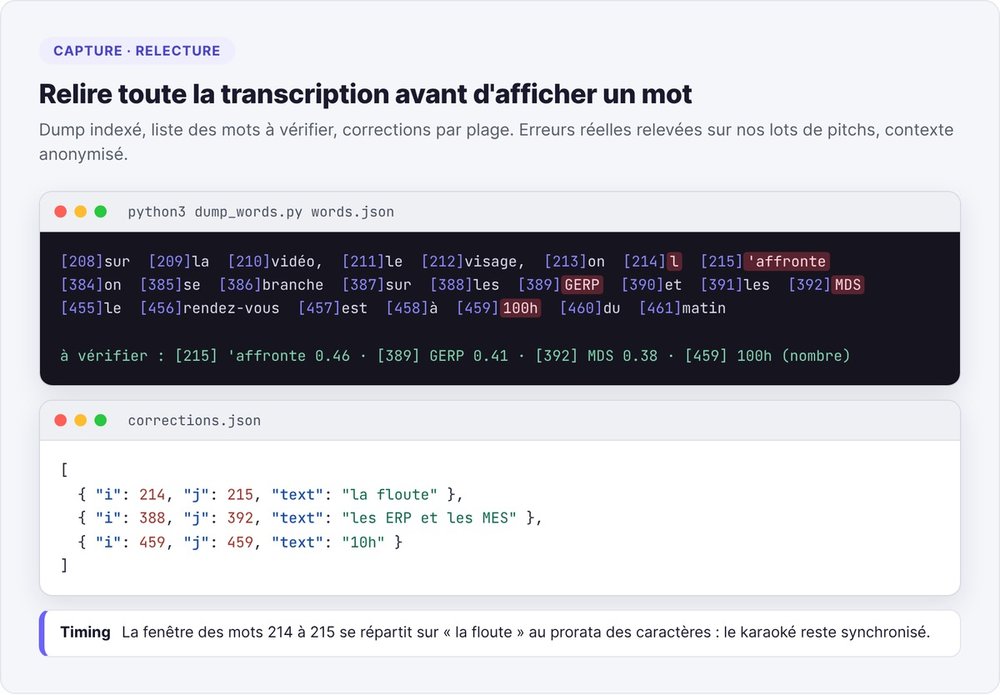
Sur nos lots de pitchs, nous avons relevé ces fautes, toutes hors noms propres :
- avec
medium: « on la floute » devient « on l'affronte », « les ERP et les MES » devient « les GERP et les MDS », « le numéro de l'EAN » devient « le numéro de l'eau » ; - avec
small: « 10h du matin » devient « 100h du matin », « cofondatrice » devient « confonatrice », « fonds américains » devient « fois américains », « travaillé » devient « trahi », « joueurs actifs mensuels » devient « joueurs actifs mondes suels ».
Le jour où nous avons relu seulement les noms de startups, « le vélamin » est arrivé chez l'orateur.
Pour lire vite, affichez chaque mot avec son index et commencez par les mots à risque : les nombres, les mots en majuscules (noms et sigles) et ceux dont la probabilité tombe sous 0,5.
import json
w = json.load(open("words.json"))
for i in range(0, len(w), 8):
    print("  ".join(f"[{i+k}]{x['word']}" for k, x in enumerate(w[i:i+8])))
print("à vérifier :", [(i, x["word"], x["prob"]) for i, x in enumerate(w)
       if x["prob"] < 0.5 or any(c.isdigit() for c in x["word"]) or x["word"][:1].isupper()])
Corriger par plage sans casser le timing
Chaque correction remplace une plage de mots, de l'index i à l'index j inclus :
[
  {"i": 214, "j": 215, "text": "la floute"},
  {"i": 388, "j": 392, "text": "les ERP et les MES"},
  {"i": 507, "j": 507, "text": ""}
]
Le nombre de mots change souvent : « le vélamin » en compte deux, « levez la main » trois. On répartit alors la fenêtre de temps de la plage sur les nouveaux mots, au prorata de leur longueur en caractères, et le surlignage reste synchronisé. Un text vide supprime la plage, pour un faux départ ou des applaudissements transcrits en mots.
def apply_span(words, i, j, text):
    t0, t1 = words[i]["start"], words[j]["end"]
    new = text.split()
    total = sum(len(x) for x in new) or 1
    out, t = [], t0
    for x in new:
        d = (t1 - t0) * len(x) / total
        out.append({"word": x, "start": round(t, 3), "end": round(t + d, 3)})
        t += d
    return words[:i] + out + words[j + 1:]
Trois règles contre les doubles corrections :
- Gardez une copie brute (
words.raw.json) et réappliquez toujours les corrections depuis elle : relancer le script ne corrige jamais deux fois. - Appliquez les plages de la dernière à la première, sans chevauchement, pour garder des index valides.
- Restaurez ce que l'orateur a dit, sans réécrire sa phrase en meilleur français.
Dans notre agent de rendu, on calcule ensuite l'empreinte sha256 du fichier corrigé : sans signature valide, ou après une modification, on refuse de graver.
Trancher un passage ambigu
Quand medium sort un non-mot et que vous n'arrivez pas à reconstituer la phrase, ne devinez pas un nom propre. Recoupez la fenêtre audio et re-transcrivez-la seule avec large-v3, amorcé par le vocabulaire métier :
ffmpeg -ss 41.2 -to 44.0 -i video.mp4 -ar 16000 -ac 1 win.wav
big = WhisperModel("large-v3", device="cpu", compute_type="int8")
seg, _ = big.transcribe("win.wav", language="fr",
                        initial_prompt="KYC, onboarding, fintech, conformité")
print(" ".join(s.text for s in seg))
Sur une démo de fintech, cette passe a donné « petit KYC » là où medium entendait « petit kawaii ». Chargez le gros modèle une seule fois pour toutes les fenêtres. Si le doute demeure, coupez le passage du clip plutôt que d'afficher une supposition.
Étape 3 : choisir entre fichier SRT et sous-titres incrustés
Deux familles de sous-titres coexistent ; vous choisissez selon la plateforme de diffusion.
SRT ou VTT pour YouTube et LinkedIn
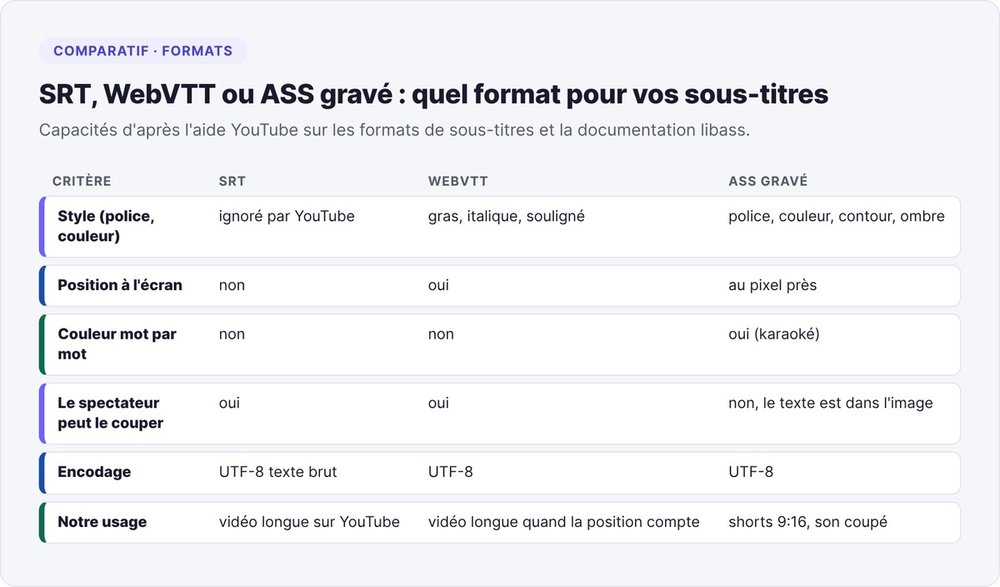
Un fichier SRT (SubRip) liste des blocs numérotés : un horodatage de début, un de fin, une ou deux lignes de texte. Le spectateur l'active ou le coupe, et la plateforme peut l'indexer. YouTube accepte le SRT en texte brut UTF-8 et ignore toute information de style ; le WebVTT y garde le positionnement, plus le gras, l'italique et le souligné.
Le SRT s'écrit à partir des segments de faster-whisper :
def ts(s):
    ms = int(round(s * 1000)); h, ms = divmod(ms, 3600000)
    m, ms = divmod(ms, 60000); sec, ms = divmod(ms, 1000)
    return f"{h:02}:{m:02}:{sec:02},{ms:03}"

segments, _ = model.transcribe("audio.wav", language="fr")
with open("video.srt", "w", encoding="utf-8") as f:
    for n, s in enumerate(segments, 1):
        f.write(f"{n}\n{ts(s.start)} --> {ts(s.end)}\n{s.text.strip()}\n\n")
Relisez ce fichier avec la même rigueur que words.json : la plateforme affichera vos fautes telles quelles.
Dans l'autre sens, un SRT existant (export de YouTube Studio ou d'un outil de sous-titrage) peut servir de base à un karaoké. On estime alors les temps par mot au prorata des caractères de chaque bloc : relisez le rendu avec plus d'attention.
ASS incrusté pour les shorts
Sur Reels, TikTok et Shorts, une partie des spectateurs regarde son coupé, et vous ne contrôlez pas l'affichage des sous-titres de la plateforme. On grave donc le texte dans l'image, au format ASS (Advanced SubStation Alpha), rendu par libass. En ASS, vous réglez la police, la couleur, le contour, l'ombre, la position au pixel près et la couleur de chaque mot.
Étape 4 : écrire des sous-titres karaoké en ASS
Un fichier ASS commence par un en-tête (taille du canevas, styles) puis liste des événements Dialogue. Pour un short 1080 × 1920, déclarez PlayResX: 1080 et PlayResY: 1920 : tailles et positions s'expriment alors en pixels de sortie. Chacune de nos règles corrige un défaut vu sur un clip livré.
Trois mots, 18 caractères, une coupure à 0,7 seconde
On regroupe les mots par trois au plus, et on ouvre un nouveau groupe après tout silence de plus de 0,7 seconde ou en fin de phrase. Notre version publique plafonne aussi la ligne à 18 caractères pour une police de 84 pixels et réduit la taille d'un mot de plus de 13 caractères.
MAXW, GAP, MAXC = 3, 0.7, 18
groups, cur = [], []
for w in items:
    if cur:
        chars = sum(len(x["t"]) for x in cur) + len(cur) + len(w["t"])
        if len(cur) >= MAXW or chars > MAXC or w["start"] - cur[-1]["end"] > GAP:
            groups.append(cur); cur = []
    cur.append(w)
if cur: groups.append(cur)
Un mot actif en couleur, à taille constante
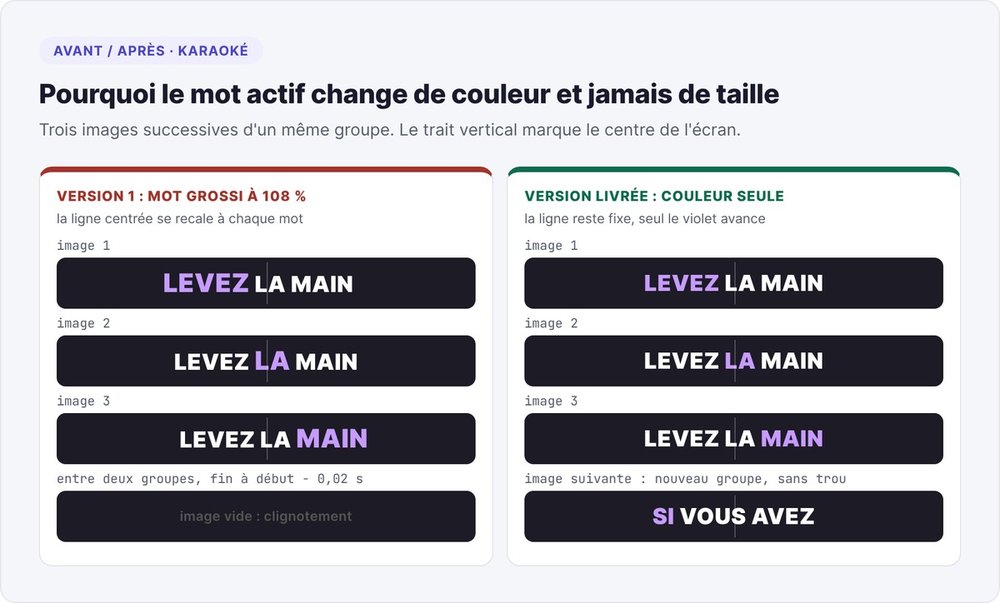
Pour chaque mot du groupe, on écrit un événement qui affiche tout le groupe, avec le mot prononcé dans la couleur d'accent :
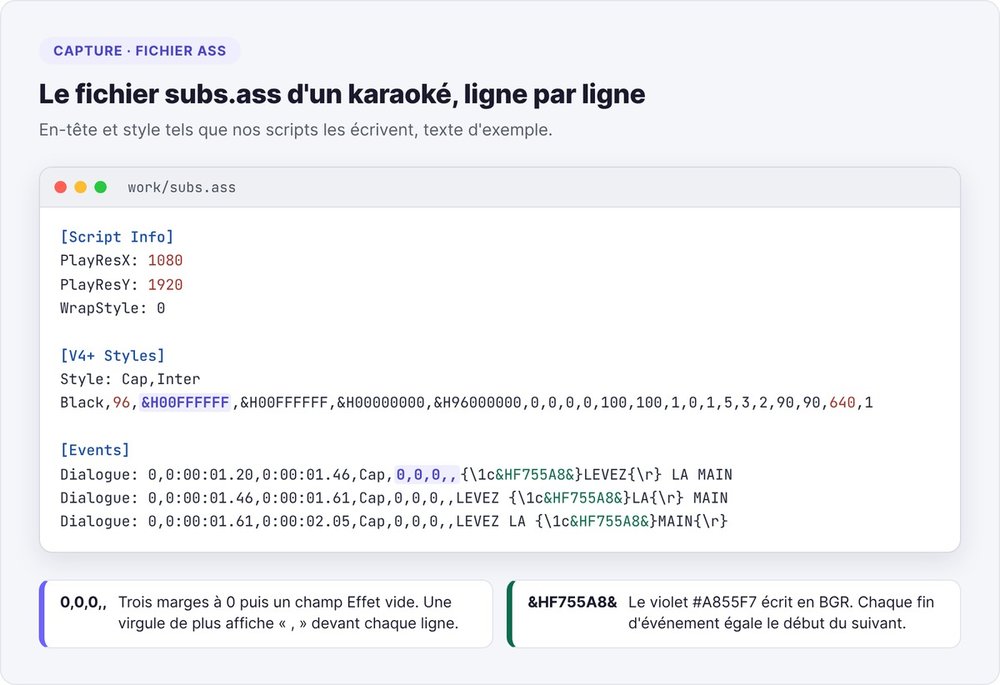
Dialogue: 0,0:00:01.20,0:00:01.46,Cap,0,0,0,,{\1c&HF755A8&}LEVEZ{\r} LA MAIN
Dialogue: 0,0:00:01.46,0:00:01.61,Cap,0,0,0,,LEVEZ {\1c&HF755A8&}LA{\r} MAIN
Dialogue: 0,0:00:01.61,0:00:02.05,Cap,0,0,0,,LEVEZ LA {\1c&HF755A8&}MAIN{\r}
Notre première version grossissait aussi le mot actif de 8 % (\fscx108\fscy108). Comme nous centrons la ligne, chaque agrandissement la décalait : à l'écran, les sous-titres tremblaient. Depuis, seule la couleur change.
Des événements jointifs et des élisions recollées
Deux défauts de timing provoquent un clignotement :
- le trou : si un événement finit un centième avant le suivant, une image tombe dans le vide. Faites finir chaque mot exactement au début du suivant, et chaque groupe au plus 0,35 seconde après son dernier mot, sans dépasser le début du groupe suivant (
min(fin + 0.35, debut_suivant)) ; - le chevauchement : n'allongez jamais un mot court « pour qu'il se voie », vous le pousseriez sur le mot suivant et deux lignes s'afficheraient ensemble.
Le français ajoute un piège : faster-whisper découpe les élisions en deux jetons, « l » et « 'IA », « c » et « 'est », « aujourd » et « 'hui ». Avant de regrouper, collez au précédent tout jeton qui commence par une apostrophe, en reprenant sa fin. Sans cette étape, un groupe finit sur « L » et le suivant commence par « 'IA ».
merged = []
for w in words:
    if merged and w["word"].lstrip().startswith("'"):
        merged[-1]["word"] += w["word"].lstrip(); merged[-1]["end"] = w["end"]
    else:
        merged.append(dict(w))
Deux pièges de syntaxe ASS
La virgule fantôme. Un jour, tous nos sous-titres se sont affichés précédés d'une virgule (« ,MERCI »). Nous avons testé six variantes de police et de contour avant de trouver la cause : une virgule de trop dans la ligne Dialogue. Le format exact compte neuf champs, Dialogue: <couche>,<début>,<fin>,<Style>,0,0,0,,<texte> : trois marges à 0, un champ Effet vide, puis le texte.
La couleur à l'envers. Côté ffmpeg, notre violet s'écrit en RGB (0xA855F7) ; en ASS, il s'écrit en BGR inversé : &HF755A8& dans le texte, &H00F755A8 dans la ligne Style, où 00 règle l'opacité. Copiez le code hexadécimal tel quel et votre violet sort rose vif.
Étape 5 : placer les sous-titres dans la zone sûre du 9:16
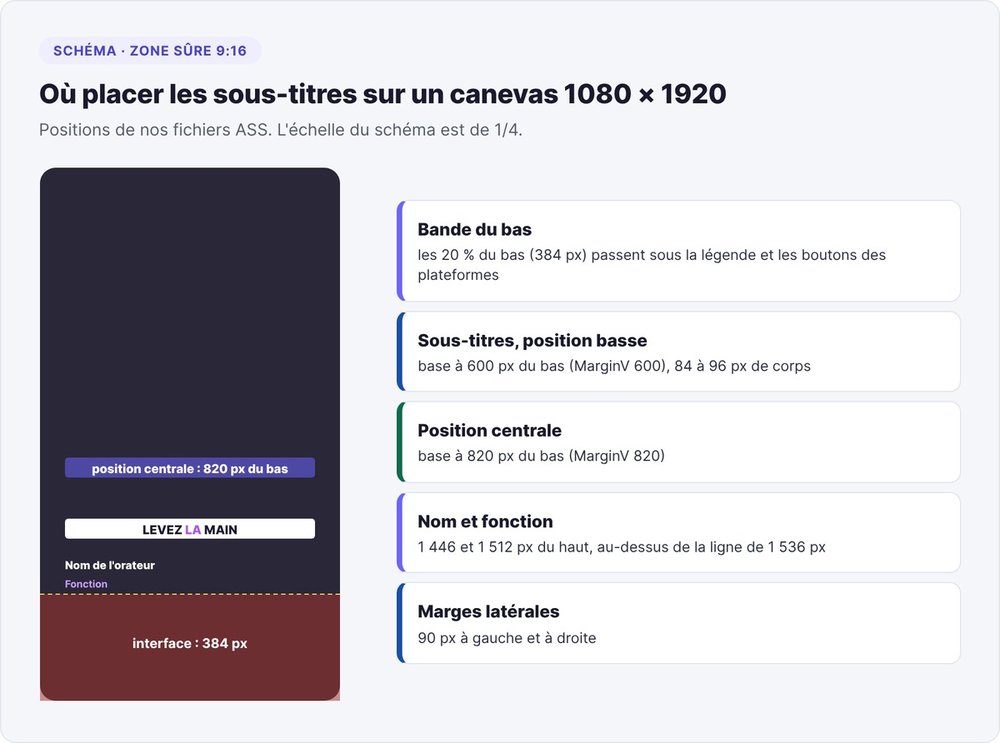
Sur un écran vertical de 1 920 pixels, l'interface des plateformes (légende, boutons, nom du compte) couvre environ les 20 % du bas, soit 384 pixels.
Nos réglages, sur un canevas ASS de 1080 × 1920 :
- la ligne de sous-titres a sa base à 600 pixels du bas (
MarginV: 600) en position basse, à 820 en position centrale ; - le nom de l'orateur, affiché les premières secondes, se place à 1 446 pixels du haut, sa fonction à 1 512, au-dessus de la ligne de sécurité de 1 536 pixels ;
- les marges gauche et droite restent à 90 pixels.
Vérifiez aussi la police : si elle manque, libass en prend une autre sans message d'erreur. On compare donc son nom à la sortie de fc-list et, en cas d'absence, on bascule sur DejaVu Sans avec un avertissement font-fallback.
Étape 6 : graver les sous-titres et normaliser le son
La commande ffmpeg
Avec un fichier ASS, le filtre ass suffit. Avec un SRT, le filtre subtitles accepte une option force_style pour imposer police et taille. Les deux passent par libass, comme l'indique la documentation du filtre subtitles de ffmpeg.
# karaoké ASS sur un clip déjà au format 1080x1920
ffmpeg -i clip_9x16.mp4 -vf "ass=subs.ass" \
  -c:v libx264 -crf 20 -preset medium -pix_fmt yuv420p \
  -af "aresample=48000,highpass=f=85,afftdn=nr=10:nf=-25,loudnorm=I=-14:TP=-1.5:LRA=11" \
  -ar 48000 -c:a aac -b:a 192k clip_sous-titre.mp4

# SRT simple sur une vidéo horizontale
ffmpeg -i video.mp4 -vf "subtitles=video.srt:force_style='Fontname=Inter,Fontsize=20'" \
  -c:a copy video_sous-titree.mp4
Ne fixez aucune fréquence d'images (-r) dans ces commandes. Pour le recadrage vertical sur l'orateur, avant la gravure, suivez le guide créer des shorts avec l'IA. Retenez-en une règle : la sortie garde la fréquence de la source. Un rendu forcé à 30 images par seconde sur une source à 50 supprime deux images sur cinq selon une cadence irrégulière, et le cadre saccade à chaque panoramique.
Le son à -14 LUFS
Notre chaîne audio, dans l'ordre :
aresample=48000: nos pitchs filmés en salle arrivent souvent en 96 kHz, et vous publiez en 48 kHz, le format standard des plateformes ;highpass=f=85contre le grondement de la salle ;afftdn=nr=10pour un débruitage léger, car un réglage plus fort rend le son « aquatique » ;loudnorm=I=-14:TP=-1.5:LRA=11, la normalisation EBU R128 à -14 LUFS, crête vraie à -1,5 dB.
Notre version publique mesure d'abord le niveau puis normalise en deux passes, plus précis sur un extrait court. Notre pipeline de shorts complet est depuis passé à -12 LUFS avec un compresseur ; le guide voisin explique pourquoi.
Étape 7 : vérifier les sous-titres image par image
À vitesse normale, un clignotement d'une image ou un mot coupé passe inaperçu. On découpe donc la bande des sous-titres image par image, et on la lit comme une planche :
ffmpeg -ss 9.3 -t 1.8 -i clip_sous-titre.mp4 \
  -vf "fps=30,crop=1080:170:0:1180,scale=540:85" cap/c_%03d.png
montage cap/c_*.png -tile 6x -geometry +1+1 -background black cap_grid.png
Lisez la planche de gauche à droite : la ligne reste à la même place, seul le mot violet avance, aucune case ne reste vide au milieu d'une phrase, chaque mot reste entier. Adaptez le crop à la position de vos sous-titres.
Dans la version publique de notre agent de shorts, on bloque la livraison sur un premier sous-titre après 1,0 seconde, un chevauchement, une fréquence d'images différente de la source, un son à plus de 2 LU de la cible ou une transcription non signée. On avertit sur un trou de moins de 20 millisecondes ou une police de remplacement.
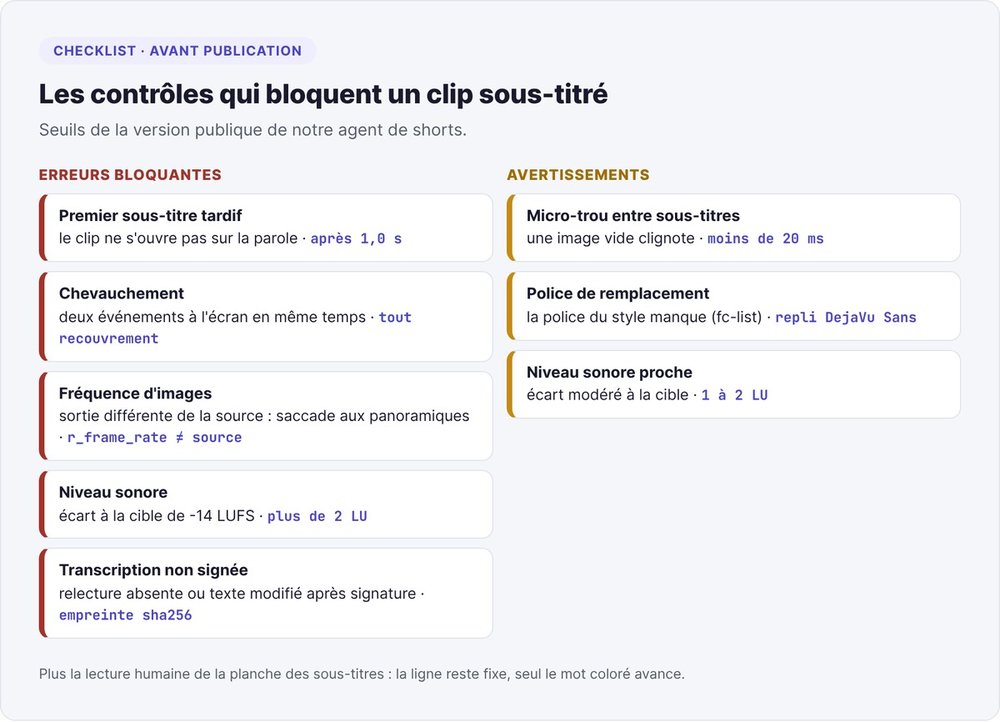
Le son et la fréquence d'images se vérifient en deux commandes ; les deux valeurs de r_frame_rate doivent être identiques :
ffmpeg -i clip_sous-titre.mp4 -af ebur128=peak=true -f null - 2>&1 | grep -A3 Summary
ffprobe -v error -select_streams v:0 -show_entries stream=r_frame_rate \
  -of csv=p=0 video.mp4 clip_sous-titre.mp4
Confier la chaîne à Claude Code
Si vous utilisez déjà Claude Code, répartissez le travail comme dans notre agent de shorts :
- le modèle lit et juge : il relit toute la transcription page par page, écrit
corrections.json, choisit la position et la couleur ; - des scripts exécutent la transcription, le regroupement, l'écriture de l'ASS, la gravure et les mesures ;
- une boucle de vérification : le modèle lit la planche des sous-titres et les mesures, puis corrige la transcription ou le style (jamais la vidéo), trois tours au plus.
Extrait de notre consigne de relecture pour le modèle :
Read every page of the transcript, not only the names. For each sentence,
check that it makes sense and that a person would say it here.
Check first: numbers, capitalised words, words with probability under 0.5.
Write corrections as {"i", "j", "text"} spans over the raw word indexes.
Never rewrite what the speaker said into better prose.
If a word stays ambiguous, re-transcribe the window with large-v3;
if it is still unclear, cut the span. Never guess a proper noun.
Vous recevez les fichiers et un rapport, et vous publiez vous-même. Pour la ligne éditoriale de ces vidéos, voyez notre guide du contenu porté par le fondateur.
Avec des sous-titres IA gratuits en local, vous gagnez surtout le temps de relire : un modèle gratuit relu mot à mot vaut mieux qu'un outil payant que personne ne relit.
FAQ
Quelle IA gratuite utiliser pour sous-titrer une vidéo ?
Whisper, dans sa version faster-whisper, est gratuit, open source (licence MIT) et tourne en local sur CPU. En français, le modèle medium offre le meilleur compromis : environ 1,9 fois la durée de l'audio sur un cœur, avec une relecture complète obligatoire. YouTube Studio reste l'option gratuite la plus simple si vos sous-titres restent sur YouTube.
Peut-on générer des sous-titres sans connexion internet ?
Oui. Une fois le modèle téléchargé au premier lancement, faster-whisper et ffmpeg fonctionnent hors ligne. La vidéo reste sur votre machine, sans quota de minutes ni filigrane.
Qu'est-ce qu'un fichier SRT ?
Un fichier texte qui liste des blocs numérotés : un horodatage de début et de fin au format 00:00:01,200 --> 00:00:03,100, puis le texte. YouTube l'accepte en UTF-8 et en ignore tout style. Pour une couleur mot par mot, il faut un fichier ASS gravé dans l'image.
Comment incruster des sous-titres dans une vidéo de façon permanente ?
Avec ffmpeg compilé avec libass : ffmpeg -i video.mp4 -vf "ass=subs.ass" sortie.mp4 pour un fichier ASS, ou le filtre subtitles=video.srt pour un SRT. Le texte fait alors partie de l'image et s'affiche sur toutes les plateformes, son coupé compris.
Comment corriger un décalage de sous-titres ?
Partez d'un horodatage par mot (word_timestamps=True) et corrigez le texte par plage, en répartissant la durée de la plage sur les nouveaux mots au prorata de leur longueur. Faites finir chaque sous-titre exactement au début du suivant. Un SRT importé n'a que des temps par bloc : on y estime les temps par mot, et le rendu demande une relecture attentive.
Peut-on sous-titrer un fichier audio MP3 ?
Oui : faster-whisper transcrit un MP3 ou un WAV comme une vidéo, et vous écrivez le SRT à partir des segments. Pour graver des sous-titres, il vous faut ensuite une image, par exemple un fond fixe assemblé avec ffmpeg.