Pour créer des shorts avec l'IA à partir d'une vidéo longue (talk, interview, démo produit, podcast), vous enchaînez cinq opérations. Une transcription mot à mot, le choix des passages par un modèle de langage, une coupe au mot près, un recadrage vertical 9:16 qui suit l'orateur, puis des sous-titres karaoké et l'export. Chaque brique existe en open source : faster-whisper transcrit, un LLM comme Claude choisit, ffmpeg coupe et rend, OpenCV suit le visage, libass grave les sous-titres.
Chez swanbase, on fait tourner ce pipeline en local, sur CPU, depuis juillet 2026. Notre pipeline a rendu 40 shorts à partir de 6 vidéos sources, d'un clip de recrutement d'une minute à des talks de près d'une heure et demie. Ce guide donne nos commandes, nos réglages et les pièges qui nous ont coûté le plus de temps. Côté format, YouTube accepte des Shorts jusqu'à trois minutes depuis le 15 octobre 2024. Nos clips durent 38,9 secondes en valeur médiane.
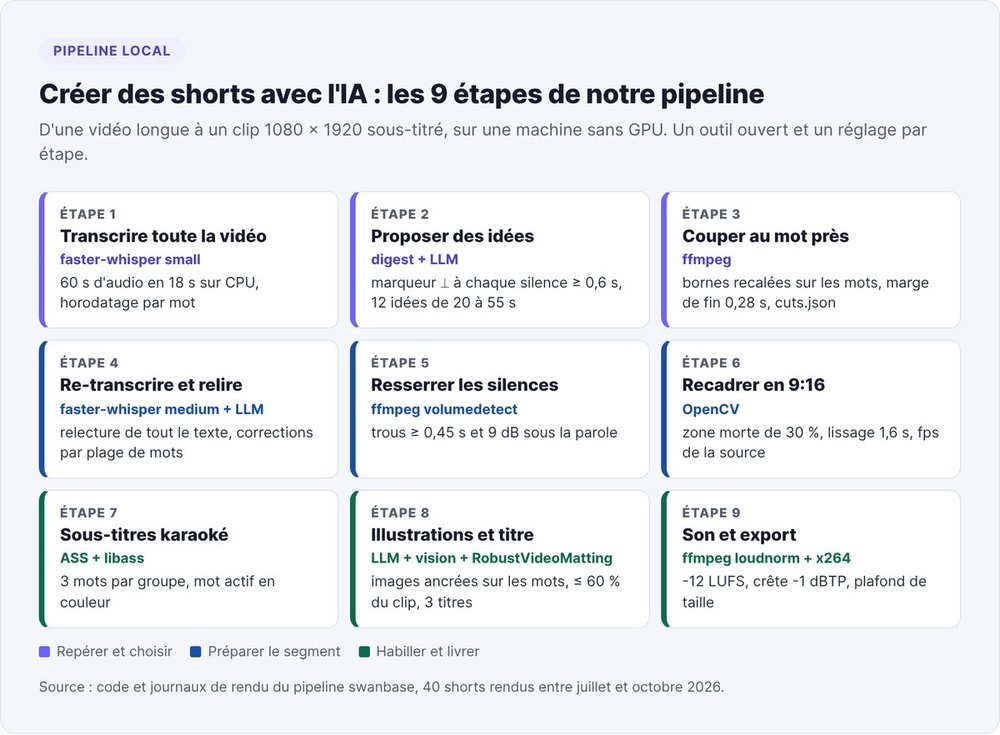
Créer des shorts avec l'IA : le pipeline en 9 étapes
Les outils en ligne cités en première page Google (Vizard, Opus Clip, Vmaker, Braiv) résument la méthode en trois boutons : importer, laisser l'IA travailler, exporter. Derrière ces boutons tournent les mêmes étapes, avec des réglages que vous ne voyez pas.
Les outils ouverts du pipeline
- faster-whisper transcrit l'audio avec un horodatage par mot. Cette réimplémentation de Whisper annonce une vitesse jusqu'à 4 fois supérieure à openai/whisper à précision égale, avec une quantification int8 utilisable sur CPU.
- Un LLM (Claude chez nous, tout modèle compatible OpenAI convient) propose les passages.
- ffmpeg coupe, recadre, grave les sous-titres et masterise le son.
- OpenCV détecte le visage pour le recadrage, RobustVideoMatting détoure l'orateur.
Tout tourne sans GPU, avec Python 3.10 ou plus et ffmpeg compilé avec libass.
Scripts pour le mécanique, modèle pour le choix
Notre première tentative a calé parce qu'elle mélangeait les deux. Depuis, les scripts font l'extraction, la transcription et le rendu ; le modèle choisit les moments et ne devine jamais un horodatage, il cite la transcription. Si vous travaillez déjà avec Claude Code, l'agent peut tenir ce rôle : il lit la transcription, écrit les idées en JSON et lance les rendus.
Étape 1 : transcrire toute la vidéo mot à mot avec Whisper
On ne ré-encode pas la vidéo longue (6 Go sur un seul cœur, des heures perdues) : on extrait l'audio, et on coupera les segments à la demande.
JOB=runs/$(date +%Y%m%d-%H%M)-montalk
ffmpeg -i talk.mp4 -vn -ac 1 -ar 16000 -c:a pcm_s16le "$JOB/audio.wav"
python3 pipeline/transcribe.py --job "$JOB" --model small --lang fr \
  --prompt "Nom de l'orateur, nom de la société, noms de produits"
Deux passes, small puis medium
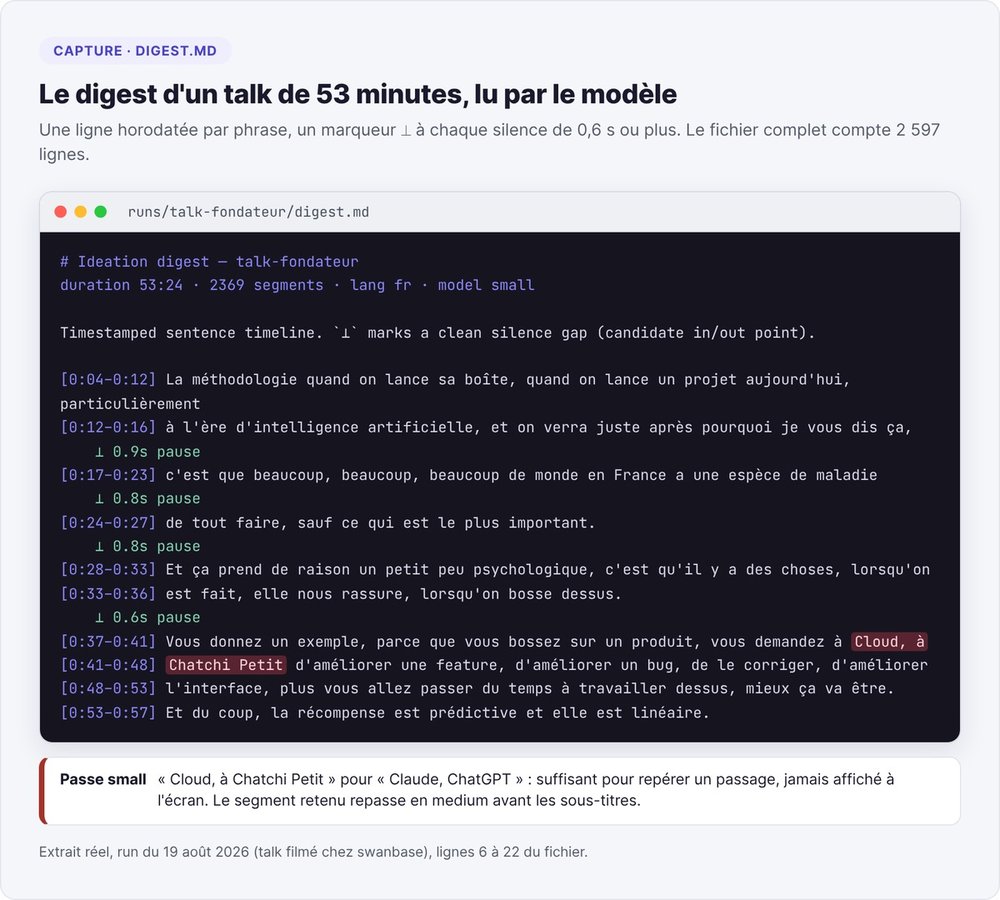
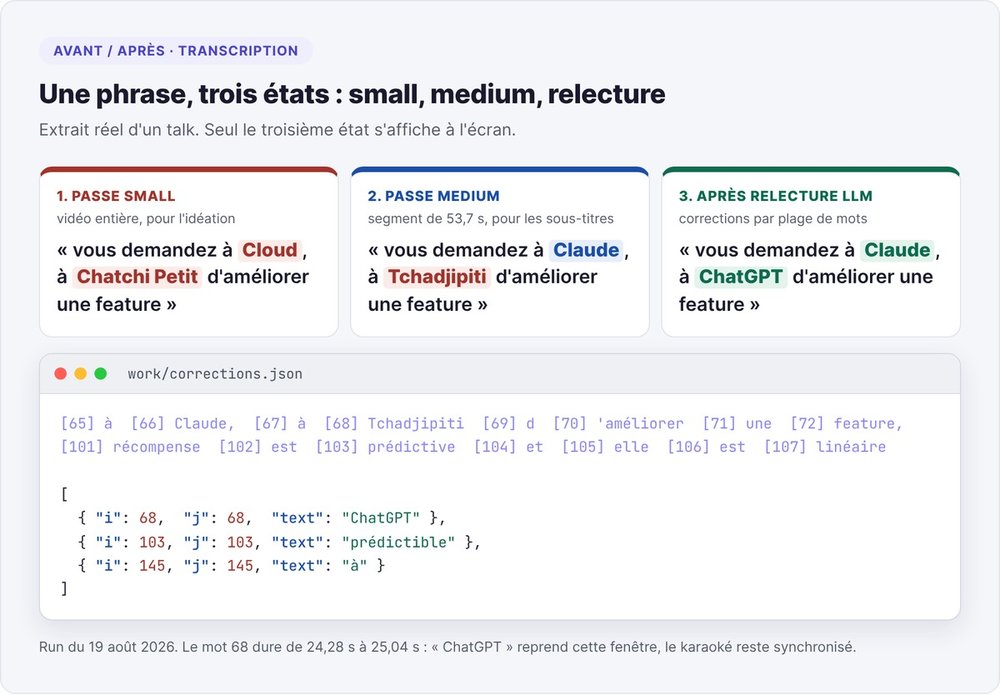
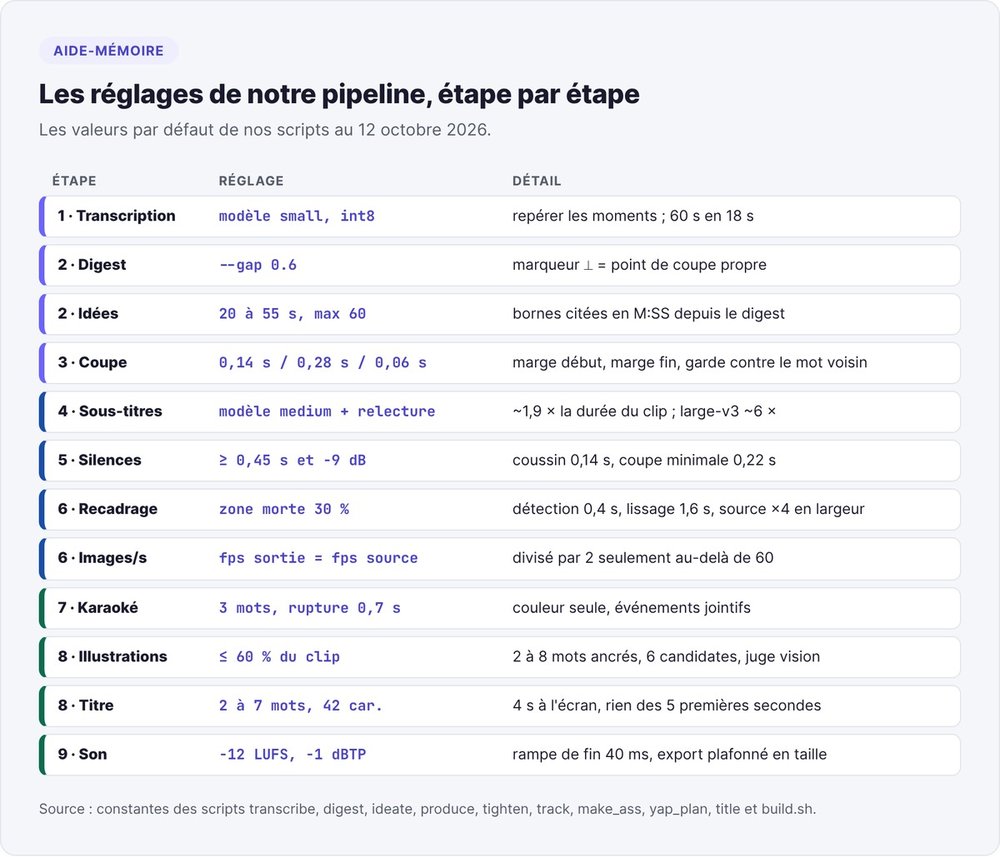
Cette passe sert à repérer les moments, avec le modèle small : sur notre machine, small transcrit 60 secondes d'audio en 18 secondes. Une vidéo de 88 minutes nous a demandé environ 40 minutes de CPU. small suffit pour choisir, pas pour afficher : sur un talk, il a entendu « à Cloud, à Chatchi Petit » pour « Claude, ChatGPT ». Chaque passage retenu repasse en medium à l'étape 4.
Trois réglages faster-whisper pour le français
Configuration de la passe de rendu :
model = WhisperModel("medium", device="cpu", compute_type="int8",
                     cpu_threads=len(os.sched_getaffinity(0)))
segments, info = model.transcribe(
    src, language="fr", word_timestamps=True, initial_prompt=prompt,
    beam_size=5, vad_filter=True,
    vad_parameters=dict(threshold=0.2, min_silence_duration_ms=700,
                        speech_pad_ms=400))
- Le seuil du VAD à 0,2 au lieu de 0,5. Le filtre de silence par défaut avale les mots peu sonores en bord de pause (liaisons, fins de syllabes). À 0,2, on récupère environ 7 % de mots perdus sur du français face caméra, sans perte de vitesse.
- Les threads. Dans un service,
cpu_threads=0suitOMP_NUM_THREADS, souvent fixé à 1. En demandant le nombre réel de cœurs (4 chez nous), la transcription d'un clip de 30 secondes passe de 44 à 34 secondes. - L'amorce des noms.
initial_promptreçoit le nom de l'orateur, de la société et des produits. Sans amorce, Whisper écrase les marques anglaises prononcées en français en un seul mot faux.
Quand un segment finit au milieu d'un mot, Whisper nomme quand même le fragment, avec une durée nulle, à la toute fin. Supprimez ce dernier jeton s'il dure moins de 0,02 seconde et tombe à moins de 0,10 seconde de la fin, sinon le sous-titre affiche un mot absent de l'audio.
Étape 2 : faire proposer des idées à un LLM depuis un digest horodaté
Les outils en ligne parlent de « score de viralité ». Chez nous, le modèle choisit, avec deux garde-fous : il lit une transcription horodatée et il cite des bornes réelles.
Le digest
Le digest réduit la transcription à une ligne horodatée par phrase. Il insère un marqueur ⟂ à chaque silence de 0,6 seconde ou plus : ces marqueurs signalent les points d'entrée et de sortie propres.
python3 pipeline/digest.py --job "$JOB" --gap 0.6
Pour un talk de 53 minutes, le digest compte 2 597 lignes. Celui d'un talk de 65 minutes pesait 41 000 tokens. On l'a confié à un sous-agent Claude Code pour protéger le contexte principal, puis on a vérifié à la main 7 des 12 bornes proposées.
Le prompt d'idéation
Le prompt, avant le digest complet :
Propose the 12 strongest self-contained short-clip ideas for vertical 9:16.
RULES
- Each clip 20-55s (hard max 60, never under 15).
- start/end MUST match real segment boundaries shown in the digest (cite exact M:SS).
- Each clip = a complete thought a stranger follows with zero context,
  strong hook first sentence.
- Spread picks across the whole talk (beginning/middle/end), not clustered.
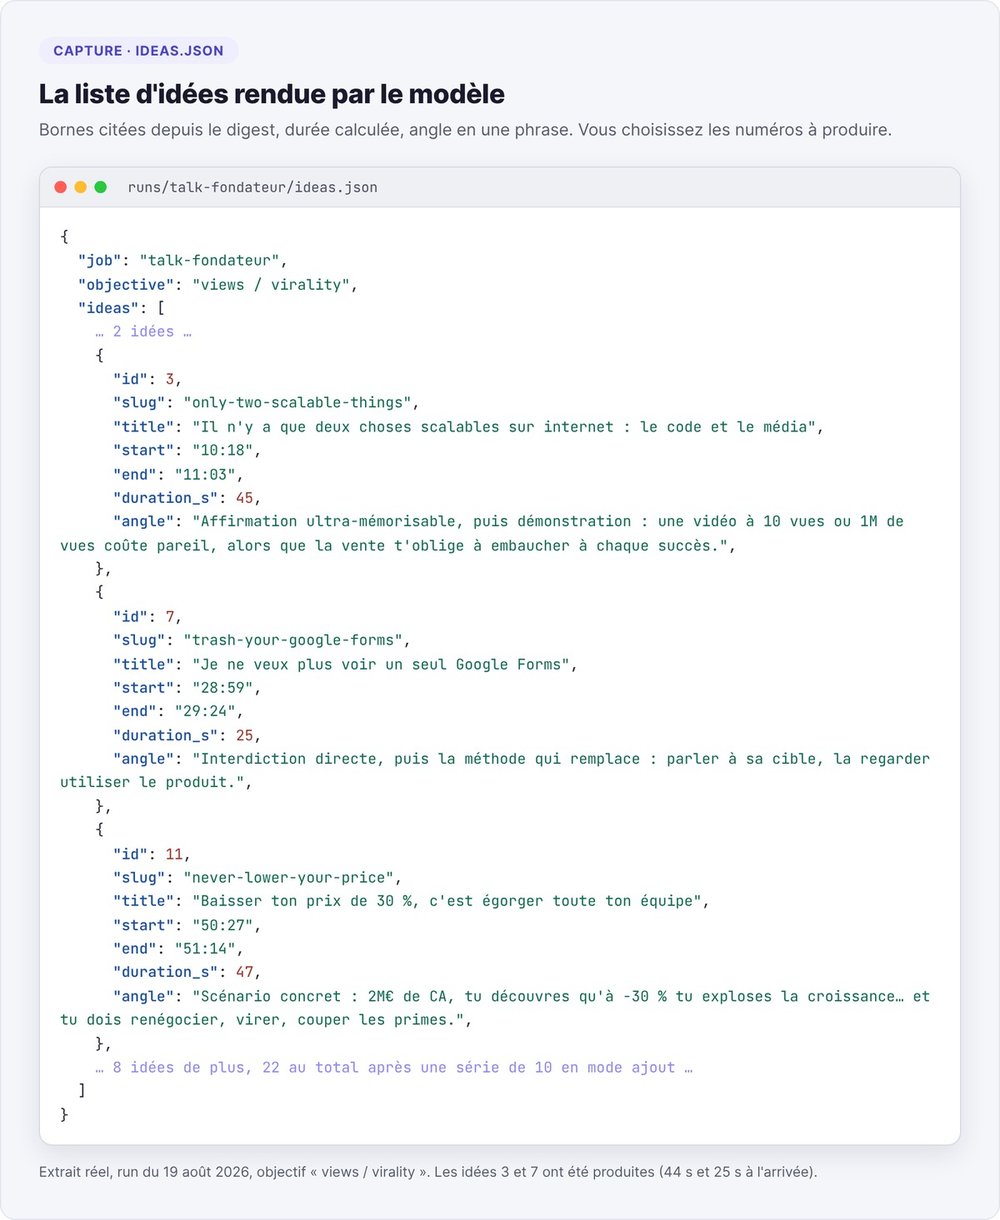
Return ONLY a JSON array: id, slug, title, angle, start, end, duration_s, why_objective
Passez le prompt par l'entrée standard (claude -p lit stdin) : un digest long dépasse la limite de 128 Ko d'un argument et la commande plante. Pour une série de plus, on réinjecte les idées déjà proposées avec l'ordre de ne pas les reformuler, et on écarte toute idée qui en recouvre une autre à 70 % ou plus. Nos runs ont produit 12, 22 et 32 idées : une série de 12, puis des séries de 10.
Choisir selon l'objectif
Le même talk donne des clips différents selon l'objectif déclaré au départ :
- Vues : les accroches les plus fortes, les renversements, la chute placée tôt.
- Ventes : problème, déclic, solution suggérée, avec une carte de fin vers l'offre.
- Autorité : un point de vue tranché, des moments pédagogiques, des phrases faciles à citer.
Le modèle présente un menu numéroté (accroche, durée, argument) et vous répondez « 1, 4, 7 ». Pour la ligne éditoriale, voyez notre guide du contenu porté par le fondateur.
Étape 3 : couper le segment au mot près
Recaler les bornes sur les mots
Un LLM qui lit un digest donne des secondes rondes, qui tombent souvent au milieu d'un mot : le clip finit sur « cont » au lieu de « contenu ». Avant de couper, on recale les deux bornes sur les horodatages des mots :
- au début, un mot à cheval sur la borne part entier ou disparaît entier, et on recule de 0,14 seconde dans le silence précédent ;
- à la fin, le dernier mot reste entier, avec 0,28 seconde de marge, parce que Whisper date les fins de mots trop tôt ;
- on laisse 0,06 seconde de silence contre le mot voisin.
En français, ajoutez une règle pour les élisions. Whisper découpe « d'arriver » en deux jetons, « d » et « 'arriver ». La paire voyage ensemble à la coupe, sinon le clip se termine sur « c'était l » au lieu de « c'était l'enfer ». Dans nos journaux de rendu, le recalage s'affiche ainsi :
== snap 17.00-70.00 -> 17.04-70.78 ("que…" … "…absolument formidable.") ==
La coupe tient en une commande, -ss avant l'entrée pour la vitesse, ré-encodage pour la précision :
ffmpeg -ss 17.04 -i talk.mp4 -t 53.74 -c:v libx264 -preset veryfast -crf 18 \
  -c:a aac -b:a 192k segment.mp4
Retirer un passage avec cuts.json
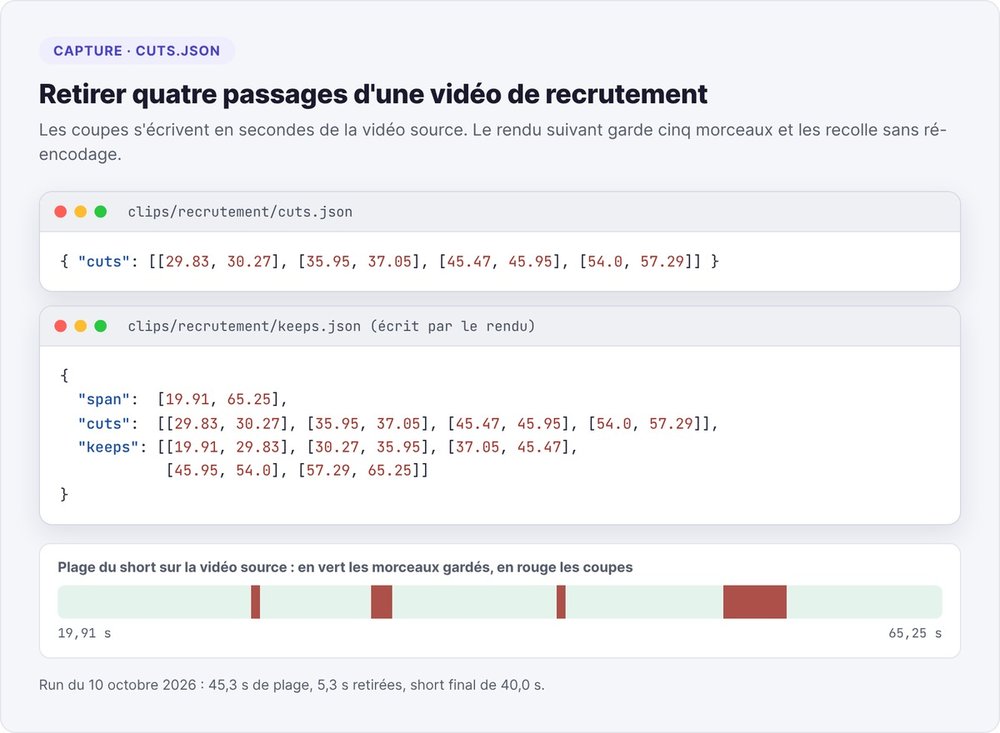
Pour supprimer une hésitation après un premier rendu, notez le passage dans cuts.json, en secondes de la vidéo source, et relancez le même rendu :
echo '{"cuts": [[29.83, 30.27], [35.95, 37.05], [45.47, 45.95], [54.0, 57.29]]}' \
  > "$JOB/clips/recrutement/cuts.json"
python3 pipeline/produce.py --job "$JOB" --idea 1 --brand brands/marque/brand.json
Les coordonnées source survivent à tous les re-rendus, puisque chaque rendu recoupe depuis l'original. Sur une vidéo de recrutement, ces quatre coupes ont laissé cinq morceaux, recollés sans ré-encodage. Un fichier vide restaure le short.
Étape 4 : re-transcrire le segment et relire tout le texte
Chaque segment repasse en medium, le bon compromis en français sur CPU : environ 1,9 fois la durée du clip sur un cœur, contre 6 fois pour large-v3, qui vaut rarement l'attente. small entend « le vélamin » pour « levez la main ».
medium se trompe encore. Sur nos lots, il a écrit « on l'affronte » pour « on la floute » et « les GERP et les MDS » pour « les ERP et les MES ». Avec small, on a relevé « 100h du matin » pour « 10h du matin », « Ochamp » pour « Auchan », « Diolingo » pour « Duolingo ». Aucun de ces mots n'est une marque prévue d'avance, donc une table de remplacement des noms propres ne les attrape pas.
Notre règle : relire toute la transcription avant de graver le moindre sous-titre. On confie cette relecture à un LLM, avec un prompt volontairement prudent :
You are a strict, conservative transcription proofreader. Your ONLY job is to fix
words it clearly got WRONG: phonetic mistakes and mangled proper / brand names.
Do NOT paraphrase, do NOT change style.
- PROTECT domain vocabulary: agent, prompt, RAG, LLM, token, pipeline, growth, pitch, SaaS.
- If the transcript reads correctly, return exactly []. Prefer [] over a risky fix.
Return: [{"i": <first index>, "j": <last index>, "text": "<corrected words>"}]
On répartit ensuite la durée de chaque plage sur les mots corrigés, au prorata de leur longueur : le karaoké reste synchronisé même quand le nombre de mots change. Sur un talk, la même phrase est passée par trois états :
Quand un passage reste incompréhensible, ne devinez pas. Recoupez la fenêtre audio et re-transcrivez-la seule avec large-v3, avec un initial_prompt qui contient le vocabulaire du domaine :
ffmpeg -ss 41.2 -to 44.0 -i segment.mp4 -ar 16000 -ac 1 win.wav
Une fois les corrections écrites, relancez le rendu avec SKIP_TRANSCRIBE=1 pour économiser les deux minutes de transcription. On a corrigé ainsi « col-col » en « cold call », dernier mot d'un clip sur la prospection.
Étape 5 : resserrer les silences
Les blancs d'un talk filmé ralentissent un short. On les retire avec une politique prudente :
- seuls les trous de 0,45 seconde ou plus entre deux mots deviennent candidats ;
- on garde 0,14 seconde de silence autour de chaque mot ;
- on ignore toute coupe de moins de 0,22 seconde, qui produirait un saut visible ;
- un trou compte comme silencieux s'il descend 9 dB ou plus sous le niveau de parole du clip.
Un seuil fixe à -30 dB échoue dès que le bruit de salle le dépasse ; notre seuil relatif s'adapte à chaque enregistrement et garde rires et applaudissements.
Deux pièges ffmpeg. Le filtre volumedetect écrit ses mesures au niveau de log info : avec -v error, chaque trou mesure 0,0 dB et vous ne coupez jamais rien. Pour recoller les morceaux, utilisez trim, atrim et concat : le filtre select décale l'audio.
Sur nos 16 clips qui gardent une trace de ce passage, on compte 24 coupes et 10,5 secondes retirées ; sept clips n'ont subi aucune coupe. La prudence coûte un peu de rythme et ne mange aucune syllabe.
Étape 6 : recadrer en 9:16 sur l'orateur
Une source 1080p donne une fenêtre verticale de 608 pixels de large (la hauteur × 9/16), qu'on agrandit en 1080 × 1920. Reste à placer cette fenêtre à chaque image.
La deadzone
On détecte le visage toutes les 0,4 seconde avec un classifieur Haar d'OpenCV. Recentrer à chaque détection fait trembler l'image ; on applique donc une zone morte. Le cadre reste immobile tant que le visage reste à moins de 30 % de la largeur du cadre de son centre, puis glisse juste assez pour le ramener sur la bordure. Une moyenne glissante de 1,6 seconde adoucit ces déplacements.
Sur un clip de 43 secondes, le journal indique deadzone=±182px leash_moves=15 : quinze déplacements, et un cadre fixe le reste du temps.
Le filtre crop n'accepte que des positions entières, et un pixel source vaut 1,78 pixel en sortie : un panoramique lent avance en escalier. On agrandit la source 4 fois en largeur avant le recadrage, ce qui ramène chaque pas à 0,44 pixel. Et comme le lissage décalait le cadre au démarrage, on ancre les 0,8 premières secondes sur le premier visage détecté.
Garder la fréquence d'images de la source
Ce problème nous a coûté six versions. Le cadre saccadait pendant les panoramiques, on corrigeait le calcul du recadrage, et la saccade revenait sur la vidéo suivante. La cause était ailleurs : le rendu forçait -r 30 sur une source à 50 images par seconde. Le passage de 50 à 30 supprime deux images sur cinq selon une cadence irrégulière, invisible sur un orateur immobile, flagrante dès que la caméra glisse.
La correction tient en une règle : la sortie garde la fréquence de la source, divisée par deux seulement au-delà de 60. Vérifiez-la sur chaque fichier :
ffprobe -v error -select_streams v:0 -show_entries stream=r_frame_rate \
  -of csv=p=0 source.mp4 final.mp4
Les deux valeurs doivent être identiques. Nos clips issus d'une source à 23,976 images par seconde sortent à 2997/125, la même valeur exacte.
Contre la monotonie d'un plan fixe, on ajoute des zooms secs de 13 % sur des débuts de phrase, espacés d'au moins 3,2 secondes. On les superpose par overlay : changer la taille d'un crop en cours de rendu via sendcmd bloque ffmpeg.
Étape 7 : poser les sous-titres karaoké
On grave les sous-titres dans l'image : ils s'affichent sur toutes les plateformes, son coupé compris. Le détail de la relecture et des pièges ASS est dans notre tuto sous-titres IA gratuits. Nos règles, écrites en ASS et rendues par libass :
- Trois mots au plus par groupe, et un nouveau groupe après tout silence de plus de 0,7 seconde.
- Le mot prononcé change de couleur, jamais de taille. Un mot qui grossit recentre toute la ligne et la fait trembler.
- Des événements jointifs : la fin d'un mot égale exactement le début du suivant, sinon une image vide clignote entre deux mots.
- Les élisions recollées : tout jeton qui commence par une apostrophe rejoint le précédent, et « l'IA » reste un seul mot.
- Les chiffres en couleur d'accent, 8 % plus grands pendant toute la durée du groupe.
Chaque groupe entre en passant de 88 % à 100 % de sa taille en 90 millisecondes, sur son premier mot seulement. Un piège de syntaxe nous a fait tester six variantes de police avant d'en trouver la cause : une virgule de trop dans la ligne Dialogue: affiche une virgule devant chaque sous-titre. Le format exact est Dialogue: <layer>,<start>,<end>,<Style>,0,0,0,,<texte>.
Étape 8 : ajouter des illustrations et un titre d'accroche
Des images ancrées sur les mots prononcés
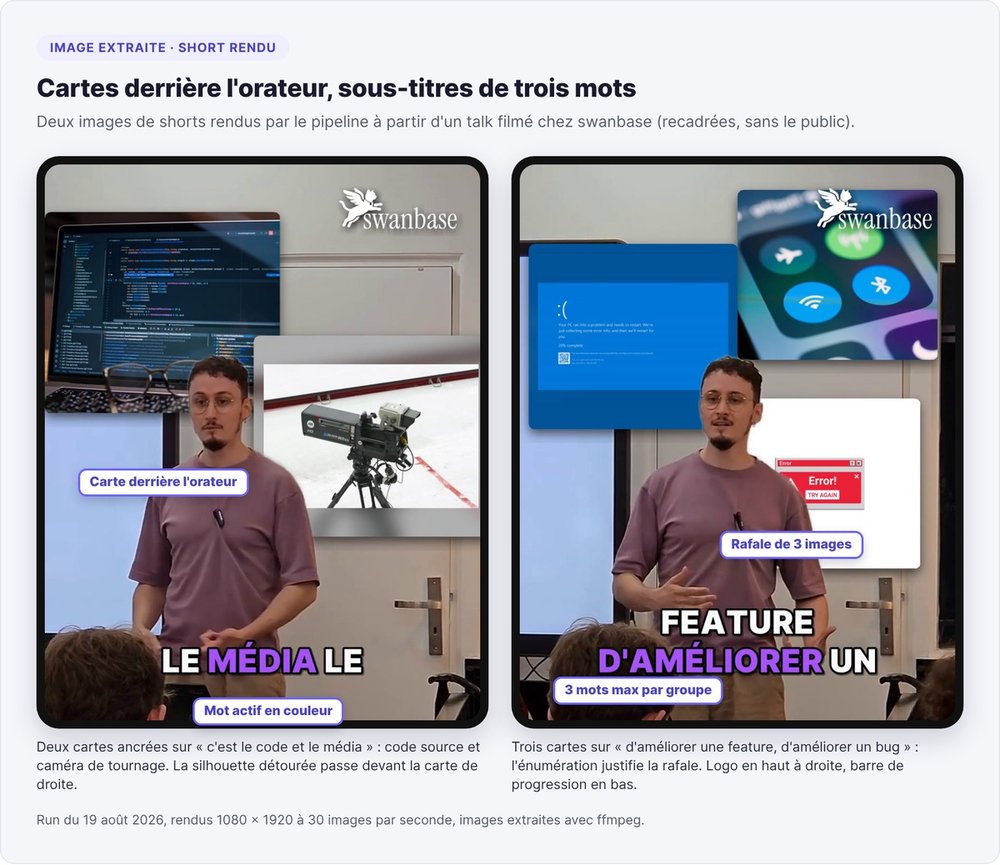
Le style « yapping » d'Instagram et TikTok fait apparaître des cartes d'image autour de l'orateur, la plupart derrière lui. On le reproduit avec trois garde-fous.
Le modèle planifie dans un cadre strict. Les cartes couvrent au plus 60 % de la durée du clip, et ce plafond n'est pas un objectif. Rien dans la première seconde, rien dans les 2,5 dernières. Chaque apparition dure de 1,6 à 3,2 secondes et montre 1 à 4 images, 3 ou 4 étant réservées aux énumérations. Une carte sur cinq au plus passe devant l'orateur.
Chaque carte cite les mots prononcés. Le modèle copie 2 à 8 mots exacts de la transcription ; si on ne les retrouve pas à ce moment du clip, on supprime la carte. Le prompt interdit aussi les métaphores visuelles : pas de clé pour « la clé, c'est », pas d'ampoule pour une idée. Les recherches partent en anglais, langue d'indexation des banques d'images.
Un modèle de vision vérifie. Pour chaque carte, on récupère 6 candidates (Wikidata, Wikimedia Commons, Openverse, Pexels, recherche d'images) et on les montre au modèle sur une planche contact. Le modèle choisit un numéro ou répond « none ». Sur les clips d'une seule vidéo source, il a refusé toutes les candidates 17 fois, surtout des captures d'interface illisibles sur téléphone (« Reddit user profile page », « Stripe revenue dashboard »). Un plan sans image vaut mieux qu'une image fausse.
Pour placer les cartes derrière l'orateur, on détoure sa silhouette avec RobustVideoMatting, en version MobileNetV3 ONNX, qui tourne sur CPU. Faites ce montage sur la vidéo propre, avant les sous-titres et le logo. Sinon le détourage prend le texte incrusté pour du décor, et une carte l'efface.
Trois titres d'accroche
Une fois le clip rendu, le modèle écrit trois titres de 2 à 7 mots, 42 caractères au plus, affichés en haut de l'écran pendant les 4 premières secondes. Chaque titre suit un angle :
- l'enjeu : ce que le spectateur gagne ou risque ;
- le fait : un chiffre, un nom ou un fait concret tiré du clip ;
- la tension : la contradiction résolue par le clip, sans la réponse.
Un titre ne doit jamais répéter les mots entendus au même moment. Le script compare ses mots aux 5 premières secondes de parole et rejette le titre si 60 % de ses mots porteurs y figurent. Le prompt bannit aussi les formules racoleuses comme « le secret » ou « la vérité sur », et le tutoiement. Changer de titre coûte une passe d'incrustation d'une minute environ, sans refaire le rendu :
python3 pipeline/title.py --clip-dir "$JOB/clips/idea3" --select 2
On ne met jamais de carte titre avant le contenu : une carte « LA PROMESSE » testée en ouverture créait un temps mort dans les premières secondes, quand le spectateur hésite encore à rester. La première image montre l'orateur.
Étape 9 : mixer le son et exporter
Notre chaîne audio : 48 kHz, passe-haut à 85 Hz contre les grondements de salle, débruitage léger (plus fort, il rend le son « aquatique »), compresseur doux, puis normalisation à -12 LUFS avec une crête vraie plafonnée à -1 dBTP. On visait -14 LUFS au départ. Le plafond reste sous 0 dBTP parce que le décodage AAC sature les crêtes à 0.
# AOUT_ST = durée du clip - 0,04 s
-af "aresample=48000,highpass=f=85,afftdn=nr=10:nf=-25,\
acompressor=threshold=0.09:ratio=2.8:attack=15:release=250:knee=6:makeup=1.5,\
loudnorm=I=-12:TP=-1.0:LRA=9,afade=t=out:st=${AOUT_ST}:d=0.04"
Supprimez les fondus de fin longs. Notre fondu de 0,6 seconde avalait le dernier mot de chaque clip ; on garde une rampe de 40 millisecondes contre le clic de coupe.
À l'export, fixez un plafond de taille plutôt qu'un débit : sous le plafond, on copie le master tel quel ; au-dessus, un encodage x264 en deux passes remplit exactement le budget. Notre plafond est de 57 Mo, 9 Mo pour Discord, qui a refusé un master de 23 Mo. N'ajoutez pas de -r, vous recréeriez la saccade de l'étape 6.
Le même fichier 1080 × 1920 sert sur Shorts, Reels, TikTok et LinkedIn ; pour LinkedIn, voyez comment transformer vos vues LinkedIn en clients.
Nos chiffres sur 40 shorts rendus à partir de 6 vidéos
Entre juillet et octobre 2026, le pipeline a rendu 40 shorts à partir de 6 vidéos sources : des talks, une interview de CEO, une vidéo de recrutement. Les mesures viennent de nos fichiers de rendu.
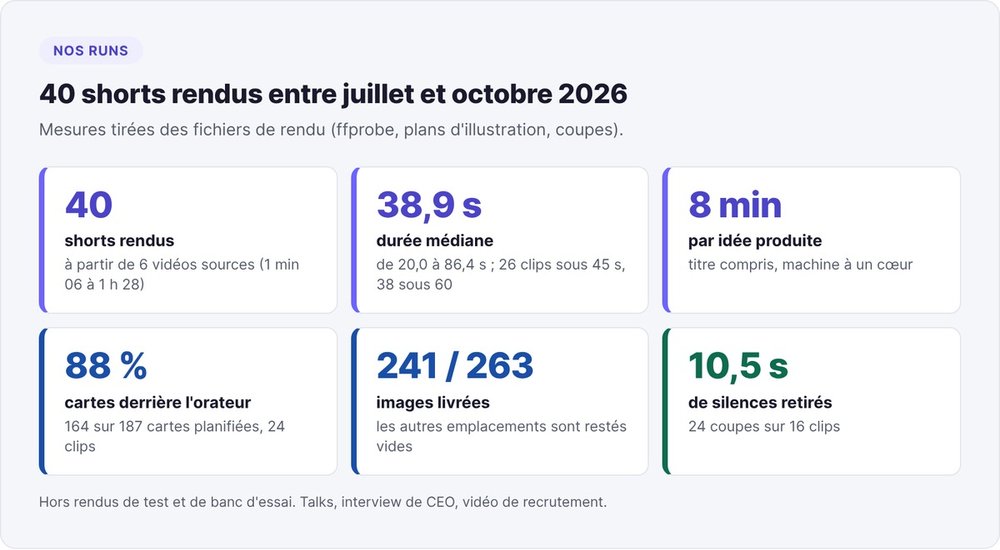
Les durées vont de 20,0 à 86,4 secondes, pour une médiane de 38,9. 26 clips tiennent sous 45 secondes et 38 sous 60. Les deux plus longs, à 77 et 86 secondes, viennent de la même vidéo et dépassent la consigne du prompt : la consigne oriente le modèle, la vérification reste à faire à la main.
Une idée sort de bout en bout en 8 minutes avec son titre, sur une machine à un cœur ; un carrousel tiré du même clip sort en parallèle en 40 secondes environ.
Côté illustrations, le modèle a planifié 187 cartes sur 24 clips, dont 164 derrière l'orateur (88 %). Il a demandé 263 images et en a livré 241 : faute d'image validée, les autres emplacements n'ont reçu aucune image. Les silences retirés totalisent 10,5 secondes sur 16 clips, moins d'une seconde par clip.
Prévoyez enfin les redémarrages : notre serveur a redémarré pendant une transcription longue. Depuis, notre file de tâches remet en attente, au démarrage, toute tâche restée « en cours ».
Outil SaaS ou pipeline local : comment choisir
Les éditeurs en ligne qui dominent la recherche « IA qui découpe les vidéos » (Opus Clip, Vizard, Submagic) font gagner du temps au premier essai. Ils suffisent si vous publiez quelques clips par mois et que leurs sous-titres vous conviennent.
Un pipeline local se justifie dans trois cas :
- vous voulez régler vous-même le modèle de transcription, la relecture, l'ancrage des images et le niveau sonore ;
- vous produisez en volume à partir de vos talks, interviews ou démos produit, avec votre charte (polices, couleurs, logo) dans un fichier de marque ;
- vous travaillez déjà avec un agent de code. Les recherches « opus clip alternative open source » renvoient vers des dépôts qui assemblent les mêmes briques (faster-whisper, un LLM, OpenCV, ffmpeg). Avec Claude Code, vous pouvez monter et régler votre version en partant des seuils de ce guide.
Le coût d'un pipeline local : la maintenance des pièges décrits ici. Notre panorama des outils IA pour startup couvre le reste de la stack.
Pour créer des shorts avec l'IA sans y passer vos soirées, retenez l'ordre de priorité de nos runs : relire la transcription, garder la fréquence d'images de la source, couper au mot.
FAQ
Quelle est la durée maximale d'un Short YouTube ?
YouTube accepte des Shorts jusqu'à trois minutes pour les vidéos mises en ligne après le 15 octobre 2024, au format carré ou vertical. Nos shorts durent 38,9 secondes en valeur médiane : notre prompt vise 20 à 55 secondes, avec un plafond à 60.
Quel modèle Whisper choisir pour le français ?
small pour repérer les moments dans la vidéo longue, medium pour les sous-titres. Sur CPU, medium prend environ 1,9 fois la durée du clip, large-v3 environ 6 fois. Même medium exige une relecture complète.
Peut-on créer des shorts avec l'IA gratuitement ?
Oui pour les briques de traitement : faster-whisper, ffmpeg, OpenCV et RobustVideoMatting tournent sur CPU sans licence payante. Les postes payants de notre pipeline : le LLM et, en option, une API de recherche d'images.
Combien de temps faut-il pour produire un short ?
Sur notre machine à un cœur, une idée sort en 8 minutes avec son titre. Ajoutez la transcription initiale de la vidéo longue : environ 0,3 fois sa durée avec small sur notre test d'une minute, environ 40 minutes pour une vidéo de 88 minutes.
Comment faire des reels avec l'IA à partir d'une vidéo horizontale ?
Recadrez en 9:16 autour du visage de l'orateur avec une zone morte, pour que le cadre reste fixe tant qu'il bouge peu, et gardez la fréquence d'images de la source. Le même fichier 1080 × 1920 sert pour Reels, Shorts et TikTok.
Faut-il savoir coder pour monter ce pipeline ?
Il faut savoir lancer des commandes Python et ffmpeg et lire un fichier JSON. Un agent comme Claude Code peut écrire les scripts si vous lui donnez les seuils de ce guide et lui faites vérifier chaque rendu image par image.