Un agent IA de prospection LinkedIn utile commence par chercher des personnes qui ont exprimé un besoin en public, à une date connue : une demande de recommandation, une plainte contre un outil, un changement d'outil annoncé. Il range ces signaux par personne, vérifie que chacune publie encore, calcule un score avec une grille fixe, puis rédige un premier message. Vous le relisez et vous l'envoyez vous-même.
Ce tuto suit l'agent open source first-users-hunter de fog-agents, que nous faisons tourner dans Claude Code. Les commandes, les seuils et les sorties viennent de ses fichiers et d'un run d'exemple relancé le 12 octobre 2026. Les personnes de cet exemple sont fictives et apparaissent ici sous pseudonyme. Pour la stratégie d'ensemble, voyez notre guide pour trouver ses premiers clients.
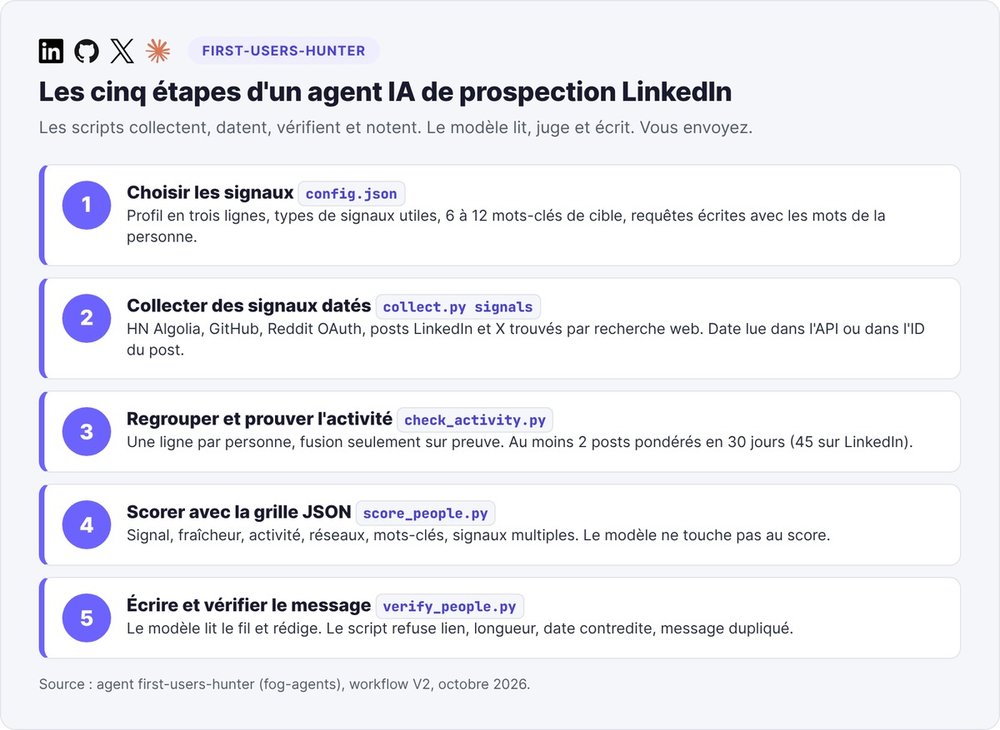
Qu'est-ce qu'un agent IA de prospection LinkedIn ?
La plupart des guides sur la prospection LinkedIn avec l'IA décrivent des outils d'envoi : séquences d'invitations, relances, messages générés par ChatGPT à partir d'un profil Sales Navigator (notre avis sur Waalaxy et notre comparatif d'outils de prospection B2B les passent en revue). Avec ces outils, vous envoyez plus vite. Vous ne savez toujours pas à qui écrire cette semaine, ni quoi lui dire, quand vous cherchez les dix premiers utilisateurs de votre SaaS.
Automatiser l'envoi ou trouver les bonnes personnes
Dans un titre de profil (« CEO, SaaS B2B, 11-50 salariés »), vous lisez qui est la personne. Vous n'y lisez rien de son besoin du moment. Le fichier de requêtes de l'agent classe d'ailleurs « traiter un profil comme un signal » parmi les erreurs à refuser.
Avec un signal daté, la conversation part ailleurs. Une fondatrice qui a écrit il y a neuf jours « quelqu'un peut-il me recommander un outil pour X » attend une réponse. Vous lui répondez dans son propre fil, sur son sujet, et vous arrivez comme quelqu'un d'utile.
Le partage des tâches entre le modèle et les scripts
L'agent tient sur une règle : les collecteurs et les scripts rassemblent, datent, vérifient et notent ; le modèle lit les fils, juge l'adéquation et écrit les messages ; un script contrôle chaque ligne avant qu'elle sorte. Le modèle de langage ne fixe donc jamais un score et ne devine jamais une date. L'agent ne publie rien et n'envoie rien : l'envoi vous revient.
Étape 1 : choisir les signaux à chercher
Vous écrivez d'abord un profil de trois lignes : le rôle de la personne, son stade ou son secteur, le moment où le besoin apparaît. Puis vous choisissez les types de signaux qui comptent pour votre produit.
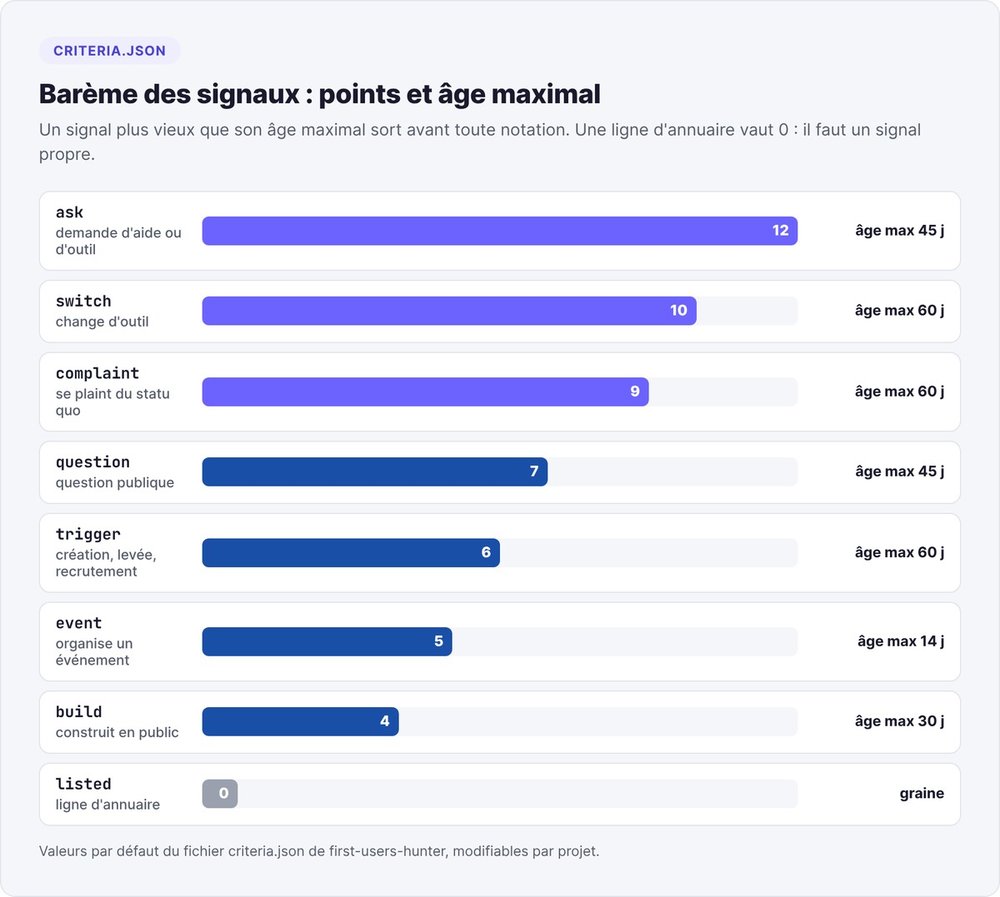
Sept types de signaux et leur barème
Le fichier criteria.json fixe les points et l'âge maximal de chaque type. Un signal trop vieux sort avant toute notation.
| Type | Comportement de la personne | Points | Âge maximal |
|---|---|---|---|
| ask | demande de l'aide, une recommandation, un outil | 12 | 45 jours |
| switch | quitte ou remplace un outil, cherche une alternative | 10 | 60 jours |
| complaint | se plaint du statu quo ou d'un concurrent | 9 | 60 jours |
| question | pose une question publique sur le problème | 7 | 45 jours |
| trigger | événement daté : création de société, levée, recrutement | 6 | 60 jours |
| event | organise ou anime un événement sur le sujet | 5 | 14 jours (60 à venir) |
| build | construit en public dans un domaine voisin | 4 | 30 jours |
Une présence dans un annuaire vaut 0 point : c'est une graine, et la personne doit encore publier un signal à elle. Le fichier présente ces points comme des réglages par défaut, sans étude derrière. Vous les changez, vous relancez et vous comparez les classements.
Écrire les requêtes avec les mots de vos futurs clients
Les requêtes reprennent les phrases que la personne écrirait elle-même : « any recommendation », « looking for a », « alternative to », « tired of » en anglais. Le classifieur reconnaît aussi « je cherche », « vous conseillez », « passer de », « marre de » et « galère ». Il teste les types dans l'ordre switch, ask, complaint, question, et retient le premier qui correspond. Prévoyez 6 à 12 mots-clés de cible : un signal sans aucun de ces mots sort de la liste.
Étape 2 : collecter des signaux datés
Hacker News, GitHub, Reddit : les API gratuites
Trois collecteurs tournent sans abonnement. Pour Hacker News, l'agent passe par l'API de recherche Algolia, sans clé, avec un filtre sur la date de création. Pour GitHub, il interroge la recherche d'issues sans jeton, à 10 requêtes par minute selon la documentation de l'API de recherche GitHub. Reddit exige l'OAuth officiel avec les clés d'une application gratuite : depuis un serveur, le JSON anonyme répond 403 (test du 10 octobre 2026).
python3 scripts/collect.py signals --config <projet>/first-users-hunter/config.json --run-dir <run>
Chaque enregistrement passe un schéma JSON. Un collecteur sans clé ou bloqué apparaît en skipped dans source-health.json, et le run continue.
Les posts LinkedIn et X par recherche web
L'agent ne se connecte jamais à LinkedIn et n'ouvre aucune page de profil. Il interroge un moteur de recherche sur les posts publics :
site:linkedin.com/posts "any recommendation" "<mot du problème>"
site:linkedin.com/posts "alternative to <outil en place>"
site:linkedin.com/posts "tired of" "<mot du problème>"
site:linkedin.com/posts "we just raised" "pre-seed"
Vous gardez une URL seulement si elle porte un identifiant de post (activity-<id>, ugcPost-<id>, share-<id>, ou /status/<id> sur X). Le texte du post va dans manual-signals.csv, puis vous relancez la même commande de collecte. Pour lire ce que votre propre profil attire, notre article sur les vues LinkedIn complète cette recherche.
Dater un post LinkedIn à partir de son ID
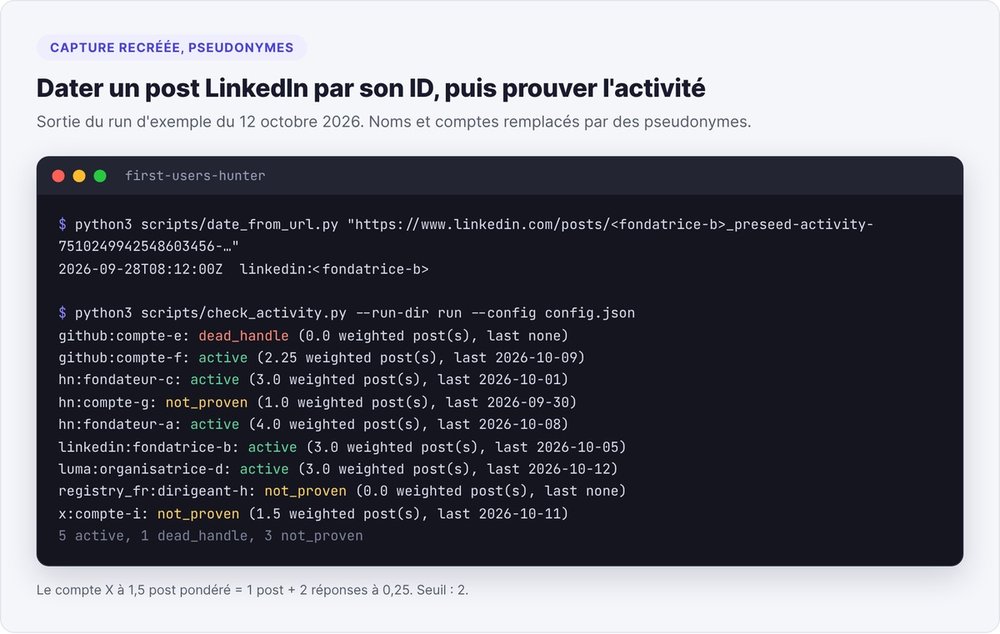
Les identifiants de posts LinkedIn contiennent leur date de création : les 41 premiers bits donnent un temps Unix en millisecondes, soit (id >> 22) / 1000 secondes. Sur X, on ajoute l'époque de Twitter : ((id >> 22) + 1288834974657) / 1000.
python3 scripts/date_from_url.py "<url du post>"
# 2026-09-28T08:12:00Z  linkedin:<slug de l'auteur>  <url>
Le script affiche aussi l'auteur nommé dans l'URL. Vous repérez ainsi un post où quelqu'un a seulement tagué votre cible : il appartient à quelqu'un d'autre et ne compte pas. Sans le script, trois lignes de Python suffisent :
from datetime import datetime, timezone
post_id = 7510249942548603456  # le nombre après "activity-"
print(datetime.fromtimestamp((post_id >> 22) / 1000, tz=timezone.utc))
Étape 3 : regrouper par personne et prouver l'activité
Une personne, plusieurs comptes
Le script candidates.py regroupe les signaux par compte. Il fusionne deux comptes seulement quand une source publie elle-même le lien, par exemple un profil Hacker News qui pointe vers un profil LinkedIn. Pour toute autre fusion, vous écrivez la preuve dans identities.json. Un nom identique ne suffit jamais. Au même passage sortent les signaux trop vieux, les simples lignes d'annuaire et les personnes déjà présentes dans votre ledger.
Le filtre des deux posts en 30 jours
Une personne qui ne publie plus ne lira pas votre réponse. Vous exigez au moins deux posts pondérés dans la fenêtre : 30 jours, 45 sur LinkedIn, parce que les moteurs n'indexent qu'une partie des posts LinkedIn. Un post, un commentaire, une issue ou une pull request valent 1. Une réponse, un repost ou un push valent 0,25.
python3 scripts/collect.py activity --config <cfg> --run-dir <run>
python3 scripts/check_activity.py --run-dir <run> --config <cfg>
Vous obtenez trois statuts : active, dead_handle (le compte n'existe plus) et not_proven. Zéro post trouvé sur LinkedIn donne not_proven, et la personne quitte ce run. Si elle compte pour vous, ouvrez son activité récente dans votre navigateur et collez les URL de ses posts dans activity-manual.csv. Quand moins de cinq personnes passent, élargissez les requêtes ou portez la fenêtre des types ask et complaint à 90 jours, en le notant. Le seuil d'activité reste à deux.
Étape 4 : scorer avec une grille JSON
python3 scripts/score_people.py --run-dir <run> --config <cfg>
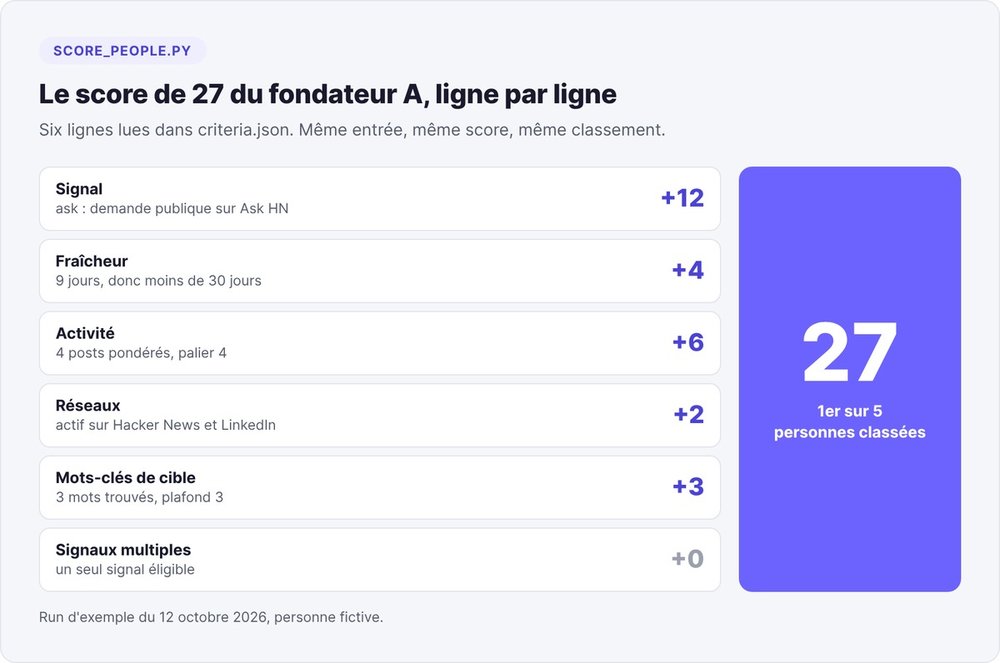
Le score se calcule en six lignes, toutes lues dans criteria.json : les points du meilleur signal, la fraîcheur (6 points sous 7 jours, 4 sous 30, 2 sous 90), l'activité (4 points à partir de 2 posts, 6 à partir de 4, 8 à partir de 8), 2 points si la personne est active sur deux réseaux, 1 point par mot-clé de cible (3 au plus), 2 points si elle a deux signaux éligibles.
Le détail d'un score de 27
Dans le run d'exemple, le fondateur A arrive premier. Il a demandé sur Ask HN, neuf jours avant le run, où les fondateurs pré-seed trouvent leurs premiers utilisateurs. Son score : 12 pour la demande, 4 pour la fraîcheur, 6 pour quatre posts pondérés, 2 pour deux réseaux actifs (Hacker News et LinkedIn), 3 pour les mots-clés. Total : 27.
Pourquoi le modèle ne touche pas au score
Un score attribué par un modèle de langage varie d'un run à l'autre, et vous ne pouvez pas le discuter. Avec une grille JSON, vous relancez le même run et vous obtenez le même classement. Vous changez un poids, vous relancez, vous comparez. Au contrôle final, un score retapé à la main dans le livrable bloque la ligne.
Étape 5 : écrire un premier message vérifié par script
Avant d'écrire, le modèle lit le fil complet du signal, mis en cache avec cache_page.py. Il note ce que la personne a demandé, ce que les réponses lui ont déjà apporté, sa langue et, en français, son tutoiement ou son vouvoiement.
Le premier contact, dans le fil du signal
Le premier contact est une réponse dans le fil du signal : un commentaire LinkedIn, une réponse HN ou GitHub. Il tient en une à quatre phrases et répond au point de la personne avec un angle concret ou une question qui fait avancer son problème. Il ne contient aucun lien, aucune proposition d'appel, aucun compliment d'ouverture, aucun « je suis X de Y ». Votre offre apparaît seulement si la personne a demandé exactement ce que vous vendez. Limites : 600 caractères dans un fil, 280 sur X, 200 pour une note de connexion LinkedIn.
Si le besoin de la personne ne recoupe pas votre offre, elle sort de la liste avec sa raison. Dans l'exemple, une personne cherchait un outil de liste d'attente pour ses bêta-testeurs : signal réel, personne active, et aucun rapport avec un accélérateur. Elle est sortie.
Le second contact porte une seule demande
Le second contact part après le premier, en message privé ou en note de connexion. Il rappelle le premier en une proposition, dit qui écrit en une autre, et porte au plus une petite demande et un lien. La signature reste une variable, {{sender_first_name}}.
Les contrôles de verify_people.py
python3 scripts/verify_people.py <projet>/first-users-hunter/people-<date>.jsonl --run-dir <run> --config <cfg>
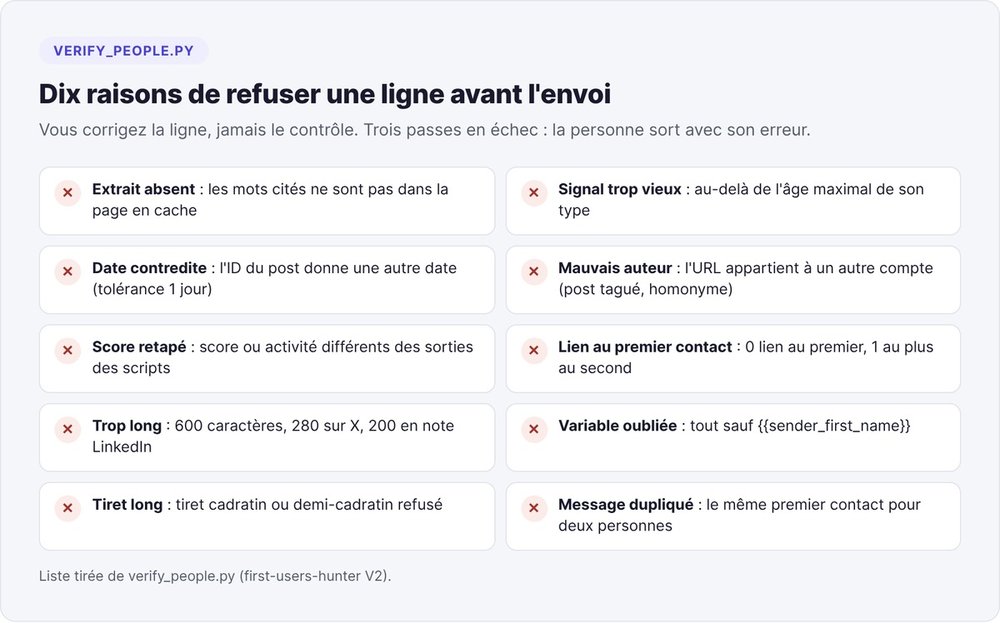
Une ligne échoue dans ces cas : extrait absent de la page en cache, signal plus vieux que l'âge maximal de son type, date contredite par l'ID du post (au-delà d'un jour d'écart), auteur de l'URL différent de la personne, activité ou score différents des sorties des scripts, lien dans le premier contact, longueur hors limite, variable non remplie, tiret long, même premier message pour deux personnes. Vous corrigez la ligne, jamais le contrôle. Après trois passes en échec, la personne sort avec son erreur.
Une grille de relecture complète le script : huit critères notés de 0 à 2, au moins 1 partout et 12 sur 16 au total. Trois fautes bloquent quel que soit le score : une preuve inventée, un email deviné, un message qui renvoie une plainte publique à son auteur.
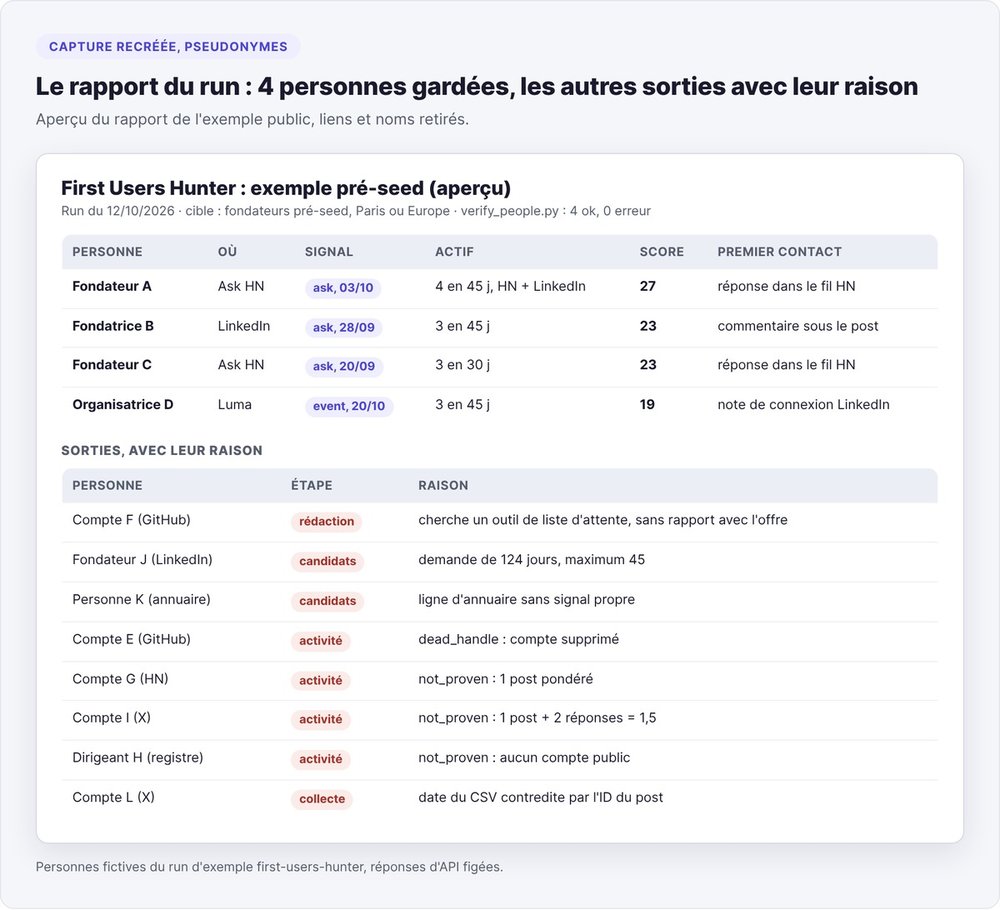
Le résultat d'un run d'exemple : 4 personnes gardées, 7 rejetées
Le dépôt contient un run d'exemple construit pour swanbase, avec des personnes fictives et des réponses d'API figées : il tourne hors ligne. Relancé le 12 octobre 2026, il donne la même sortie à chaque fois :
- 9 candidats après regroupement, dont 2 écartés tout de suite : une demande LinkedIn vieille de 124 jours pour un maximum de 45, une ligne d'annuaire sans signal propre ;
- 9 comptes vérifiés, 19 posts trouvés : 5 actifs, 1 compte GitHub supprimé, 3
not_proven(dont un compte X avec un post et deux réponses, soit 1,5 post pondéré) ; - 5 personnes classées, 1 écartée à la rédaction, 4 gardées ;
verify_people.pyrend 4 lignes valides et 0 erreur.
Une septième personne n'a jamais atteint le tri : la date saisie dans le CSV contredisait l'ID de son post, et la ligne est sortie dès la collecte. La suite de tests du dépôt passe à 159 sur 159.
Prospection LinkedIn avec l'IA : les règles à respecter
Les guides d'automatisation consacrent une section aux restrictions de compte. Avec cette méthode, la question ne se pose pas : l'agent ne se connecte pas à LinkedIn, ne visite aucun profil et n'envoie aucun message. Les posts arrivent par un moteur de recherche, et vous postez chaque réponse à la main.
Les données personnelles suivent des règles écrites dans l'agent. Il garde seulement des données professionnelles publiées par la personne, chacune avec son URL source, et ne fait aucune déduction sur la santé, la politique, la religion ou la famille. Il garde un email seulement si la personne l'a publié pour un contact professionnel. Une personne qui demande à sortir passe en do_not_contact et ne revient plus. Vous purgez les lignes jamais contactées après 60 jours.
Si vous cherchez aussi des profils dans Sales Navigator, tapez les opérateurs booléens en majuscules (AND, OR, NOT) et restez sous une quinzaine d'opérateurs : au-delà, LinkedIn tronque la requête sans prévenir. Un profil trouvé ainsi doit encore publier un signal daté avant d'entrer dans la liste.
Les erreurs de notre première version
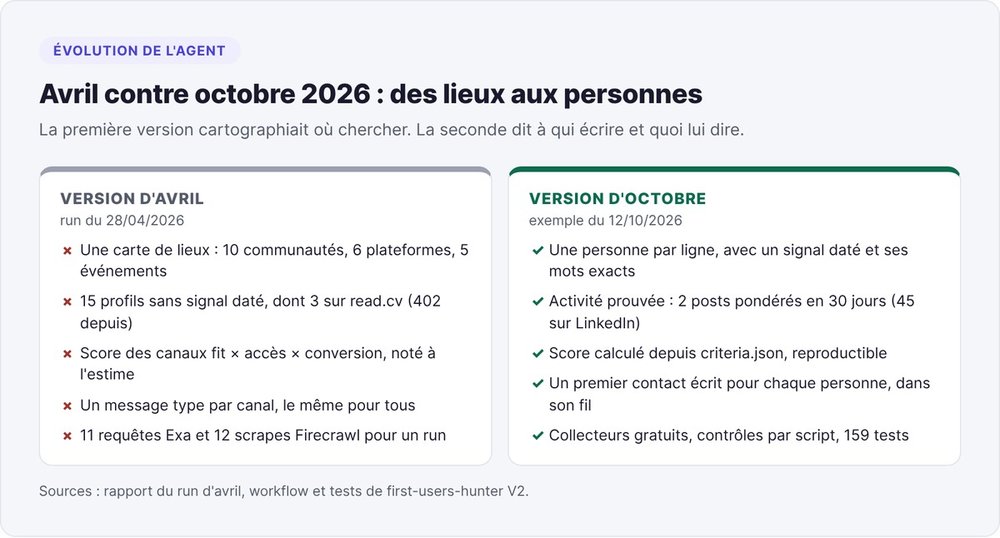
La version d'avril 2026 cartographiait des lieux. Le run du 28 avril a consommé 11 requêtes Exa et 12 scrapes Firecrawl pour livrer 10 communautés, 6 plateformes, 5 événements et 15 profils sans aucun signal daté. Le score des canaux multipliait l'adéquation, l'accès et la conversion, notés de 1 à 5 à l'estime : le rapport l'écrivait lui-même, « judgment-based, not a measurement ».
Trois sources de cette version ont cessé de répondre depuis un serveur : read.cv (erreur 402, alors que 3 des 15 profils en venaient), le JSON anonyme de Reddit (403) et les salons Discord (page de connexion). Sur Exa, le filtre --include-domains linkedin.com ramenait surtout des pages d'accueil. La version d'octobre garde une personne par ligne, avec un signal daté, une preuve d'activité, un score calculé et un message contrôlé.
Relancez l'agent toutes les une à deux semaines. Le ledger exclut les personnes déjà contactées ; une personne déjà listée revient seulement avec un signal plus récent. L'agent et son run d'exemple sont disponibles sur fog-agents.com, avec les autres agents IA marketing de fog.
FAQ
Un agent IA de prospection LinkedIn risque-t-il une restriction de compte ?
La méthode de ce tuto ne touche pas à votre compte : l'agent lit des posts publics trouvés par recherche web, ne se connecte pas à LinkedIn et n'envoie rien. Les restrictions concernent les outils qui pilotent votre session pour envoyer invitations et messages en volume.
Combien coûte un agent de prospection LinkedIn basé sur des signaux ?
Les collecteurs de first-users-hunter utilisent des points d'accès gratuits : Hacker News Algolia sans clé, GitHub sans jeton, Reddit avec des clés d'application gratuites. Vous payez l'abonnement du modèle qui fait tourner l'agent, Claude Code par exemple. Ajoutez au besoin un service de recherche web.
Faut-il Sales Navigator pour prospecter avec l'IA ?
Non. Les signaux viennent de posts publics et d'API gratuites. Sales Navigator sert à chercher des profils par rôle et par taille d'entreprise. Un profil trouvé ainsi doit encore publier un signal daté avant d'entrer dans la liste.
Comment connaître la date d'un post LinkedIn ?
Prenez le nombre après activity- dans l'URL du post, décalez-le de 22 bits vers la droite et divisez par 1 000 : vous obtenez un temps Unix en secondes. Exemple : le post activity-7510249942548603456 date du 28 septembre 2026 à 8 h 12 UTC.
Quelle longueur pour un premier message LinkedIn ?
Dans cet agent, 600 caractères au plus pour une réponse dans un fil ou un message privé, 200 pour une note de connexion, 280 pour une réponse sur X. Le premier message ne contient aucun lien.