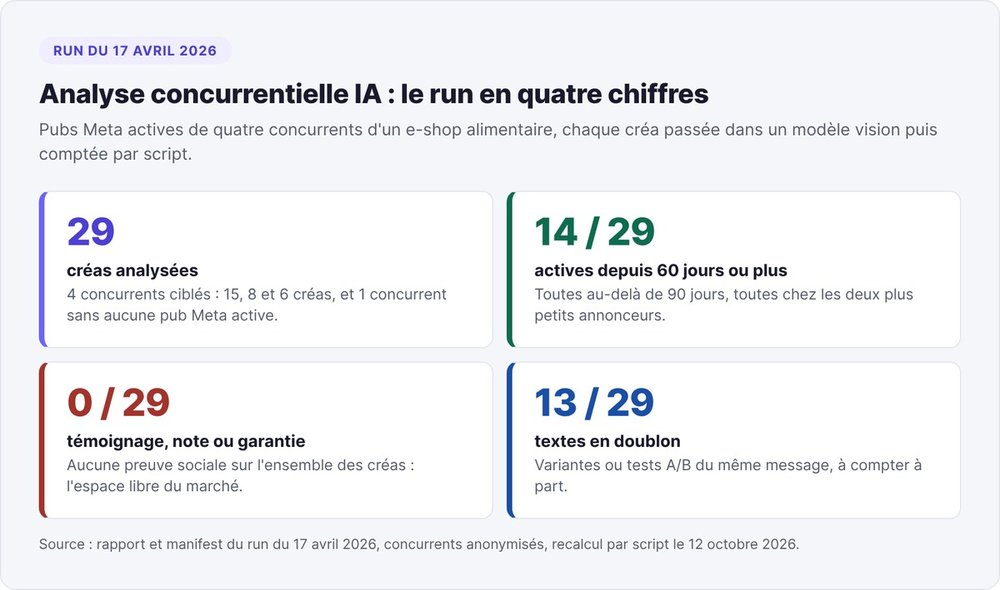
Le 17 avril 2026, nous avons mené une analyse concurrentielle IA sur 29 pubs Meta de quatre concurrents d'un e-shop alimentaire : un modèle vision a décrit chaque créa, puis un script a fait les comptes. Deux faits sont ressortis : 14 créas sur 29 tournaient depuis 60 jours ou plus, et aucune ne montrait un témoignage, une note ou une garantie.
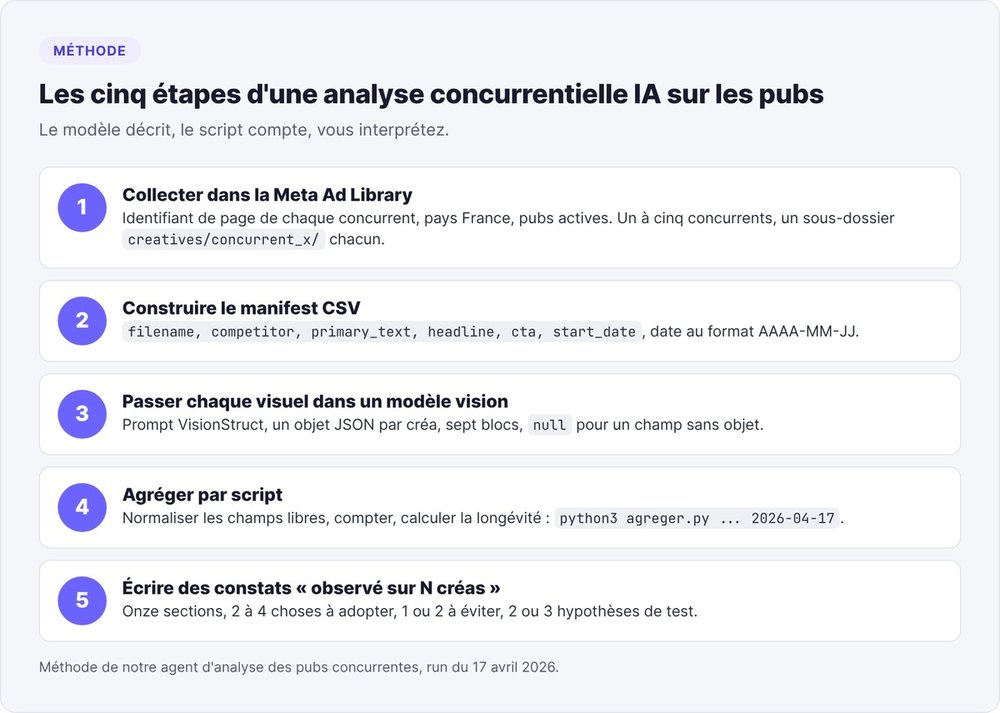
Pour la reproduire, vous collectez les pubs actives de vos concurrents dans la Meta Ad Library, vous les listez dans un manifest CSV, vous passez chaque visuel dans un modèle vision qui renvoie un JSON (composition, couleurs en hexadécimal, texte, bouton d'action), vous agrégez ces JSON avec un script, puis vous écrivez des constats ancrés « observé sur N créas ».
Ce tuto donne la méthode pour un SaaS, avec les commandes, le prompt, le script et sept pièges vécus.
Qu'est-ce qu'une analyse concurrentielle IA appliquée aux publicités ?
Une analyse concurrentielle IA appliquée aux publicités décrit chaque pub d'un concurrent dans un format structuré, puis compte les motifs qui reviennent. Vous confiez la description au modèle vision et le comptage à un script, et vous gardez l'interprétation.
Les outils d'analyse concurrentielle classiques
Les guides classés sur cette requête listent des outils de mots-clés, de trafic ou de veille sociale. Ils décrivent rarement le contenu des pubs : message, image, bouton d'action.
Le contenu visible dans la Meta Ad Library
La Meta Ad Library affiche les pubs actives et inactives de n'importe quelle page Facebook ou Instagram : le visuel, le texte principal, le titre, le bouton d'action et la date de début de diffusion.
Les angles morts de l'analyse
La bibliothèque ne donne ni le budget ni les résultats d'une pub commerciale. Notre méthode retient donc un signal indirect : une pub active depuis 60 jours ou plus devient un « gagnant probable », car un annonceur laisse rarement tourner deux mois une pub qui ne rapporte rien. Le rapport présente ce signal comme une hypothèse.
Étape 1 : collecter les publicités dans la Meta Ad Library
Notre agent accepte un à cinq concurrents par run, avec un sous-dossier d'images par concurrent (creatives/concurrent_a/, creatives/concurrent_b/).
La recherche dans l'interface web
Cherchez chaque concurrent par le nom de sa page, puis filtrez sur la France et sur les pubs actives. L'URL d'une page de résultats suit ce modèle :
https://www.facebook.com/ads/library/?active_status=active&ad_type=all&country=FR&search_type=page&view_all_page_id=<PAGE_ID>
Notez l'identifiant de page (view_all_page_id) de chaque concurrent. Une recherche par mot-clé mélange les annonceurs, alors que l'identifiant de page isole un concurrent.
L'API Ad Library et le champ ad_snapshot_url
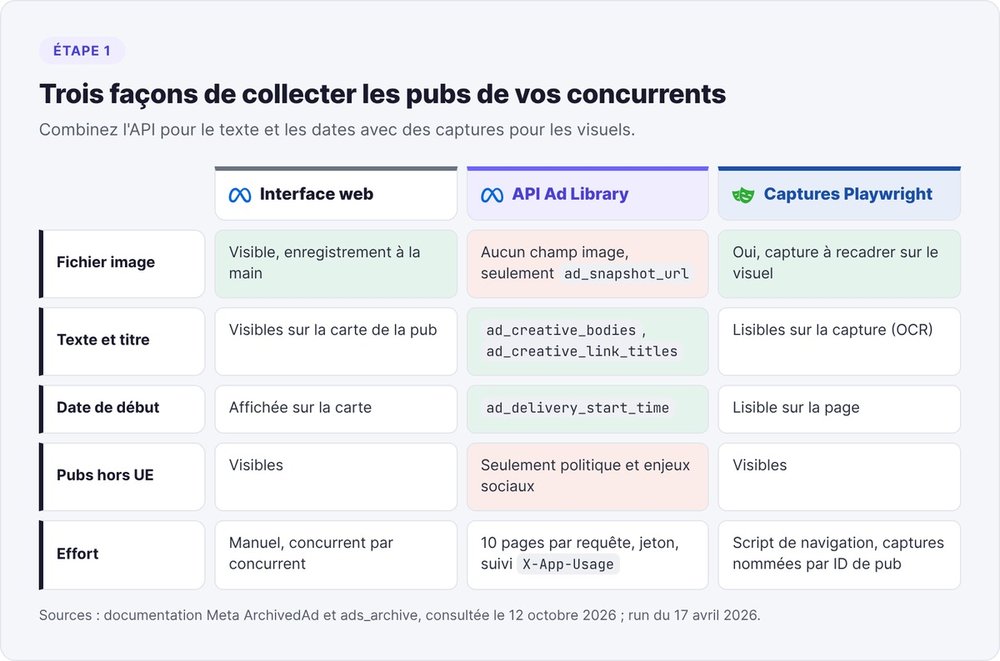
L'API officielle accepte jusqu'à dix identifiants de page par requête (search_page_ids). Elle renvoie le texte de chaque pub, le titre, la date de début de diffusion et les plateformes. D'après la référence de l'objet ArchivedAd, aucun champ ne renvoie le fichier image : vous obtenez un ad_snapshot_url, une page HTML qui affiche la pub.
curl -G "https://graph.facebook.com/<version>/ads_archive" \
  --data-urlencode "search_page_ids=<ID_A>,<ID_B>,<ID_C>" \
  --data-urlencode "ad_reached_countries=['FR']" \
  --data-urlencode "ad_active_status=ACTIVE" \
  --data-urlencode "fields=id,page_name,ad_delivery_start_time,ad_creative_bodies,ad_creative_link_titles,ad_snapshot_url,publisher_platforms" \
  --data-urlencode "access_token=$TOKEN"
Deux limites. La documentation de l'endpoint ads_archive précise qu'une pub qui n'a touché aucun pays de l'Union européenne ne remonte que si elle traite de politique ou d'enjeux sociaux : un concurrent américain qui ne diffuse pas en Europe reste invisible côté commercial. Ensuite, Meta suit votre consommation dans l'en-tête X-App-Usage : notre plan de collecte automatique prévoit une pause à 75 % et 50 pubs par concurrent par défaut.
Capturer les visuels avec Playwright
Pour les images, enregistrez chaque créa à la main depuis la bibliothèque ou capturez les pages avec un navigateur piloté. Notre run du 17 avril a utilisé des captures Playwright. Nommez chaque fichier avec l'identifiant de la pub dans la bibliothèque : ce nom devient la clé de jointure avec le manifest.
Recadrez chaque capture sur le visuel. Si la capture garde l'interface de la bibliothèque (le bouton « En savoir plus », le nom de domaine, la mention sponsorisée), le modèle lit ces éléments comme du texte de pub : c'est le piège n°2.
Étape 2 : construire le manifest CSV
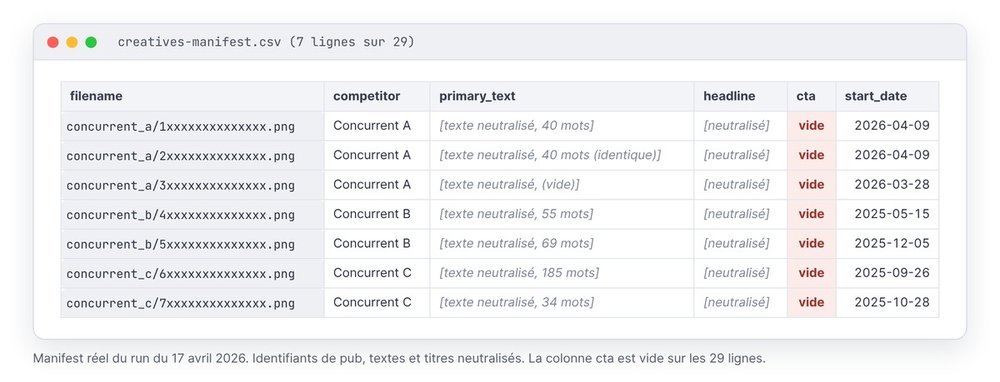
Dans le manifest, vous reliez chaque image à ce que le visuel ne montre pas : l'annonceur, le texte complet, la date de début.
Les six colonnes
filename,competitor,primary_text,headline,cta,start_date
concurrent_a/120200000000001.png,Concurrent A,"Fermez vos mois en 2 heures...",Essai gratuit 14 jours,S'inscrire,2026-09-02
concurrent_b/120200000000002.png,Concurrent B,"Vos relances partent seules...",Démo en 20 minutes,Réserver,2026-07-18
La date suit le format ISO (AAAA-MM-JJ), sinon le calcul de durée casse.
Calculer les jours de diffusion
La durée d'une pub vaut la date du run moins start_date. Notre script isole chaque créa active depuis 60 jours ou plus. Fixez la date du run dans la commande : relancé une semaine plus tard, le même manifest donnerait d'autres durées.
Étape 3 : transformer chaque visuel en JSON avec un modèle vision
Claude Code lit les images d'un dossier et écrit le fichier de sortie. Notre spec produit un seul fichier pour toutes les créas : structured/creatives-structured.json.
Le prompt
Extrait traduit de notre prompt, VisionStruct, qui interdit le résumé :
Tu es un moteur de sérialisation visuelle. Pour l'image fournie, renvoie un seul
objet JSON, sans bloc de code ni phrase autour.
Ne résume pas. Tout détail présent dans les pixels doit exister dans le JSON.
Avant d'écrire, fais trois passes silencieuses :
1. la scène, la lumière, les sujets principaux ;
2. les détails, les textures et tout le texte visible (OCR) ;
3. les relations entre objets (tient, cache, à côté de).
Clés obligatoires : meta, global_context, color_palette, composition,
objects, text_ocr, semantic_relationships. Champ sans objet : null.
Si vos captures gardent l'interface de la bibliothèque, ajoutez : « Ignore le cadre de la bibliothèque publicitaire (bouton d'action, nom de domaine, mention sponsorisée) et décris uniquement la créa. »
Dans Claude Code, lancez le traitement depuis le dossier du projet :
Lis chaque image de creatives/ et ses sous-dossiers. Pour chacune, applique
prompt-vision.md et ajoute {"filename": ..., "competitor": ..., "data": {...}}
au tableau de structured/creatives-structured.json. Si une image échoue,
note-la dans _skipped et continue.
Le schéma JSON par créa
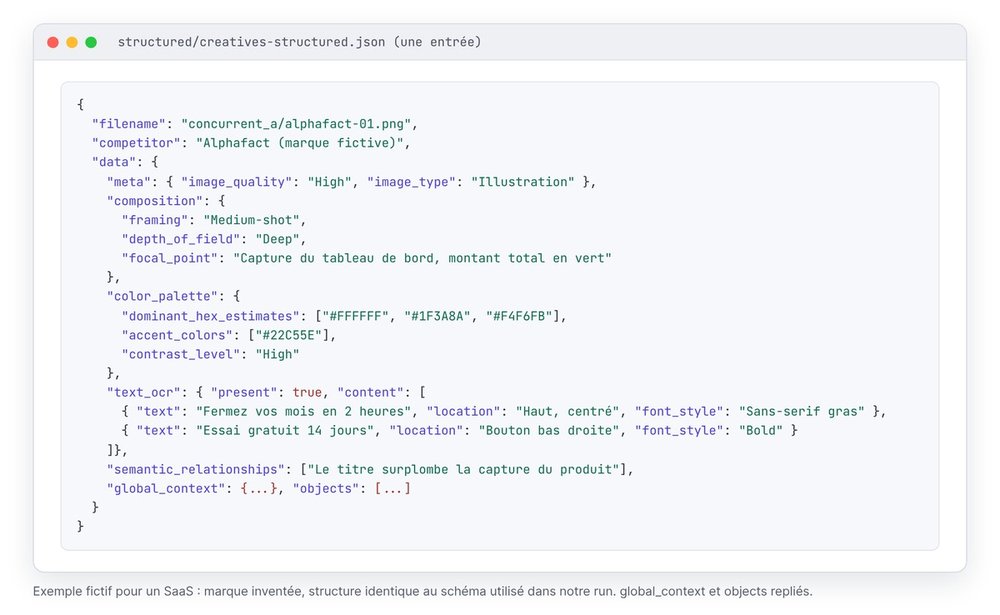
Chaque créa produit sept blocs. composition donne l'angle, le cadrage, la profondeur de champ et le point focal. color_palette liste les couleurs dominantes en hexadécimal et le niveau de contraste. text_ocr recopie chaque texte avec sa position et son style. Un champ sans objet vaut null et ne disparaît jamais : le script lit la même structure sur chaque créa.
Si le modèle renvoie un JSON mal formé, relancez une fois avec la consigne « JSON valide uniquement ». Au second échec, sautez l'image, journalisez-la et continuez le lot.
Le poids du JSON
Sur notre run, chaque créa a donné environ 5 900 caractères de JSON, soit 225 Ko pour 29 créas. Personne ne relit ce volume à la main. D'où l'étape 4.
Étape 4 : agréger par script, sans compter à l'œil
Confiez le comptage à un script. Un modèle qui lit 29 JSON et annonce « la plupart des pubs utilisent un plan moyen » vous livre une impression. Avec le script, vous lisez 18 sur 29.
Normaliser les champs libres
Le modèle remplit framing en texte libre. Sur notre run, il a produit sept libellés pour quatre notions : « Medium-shot », « Medium-shot (video thumbnail crop) », « Close-up to medium-shot », etc. Ramenez chaque champ libre à une liste fermée avant de compter, sinon chaque variante devient une catégorie à une créa.
Le script d'agrégation
Testé sur les données du run du 17 avril :
import csv, json, sys, datetime, collections

json_path, csv_path, date_run = sys.argv[1], sys.argv[2], sys.argv[3]
creas = json.load(open(json_path))
manifest = {r["filename"]: r for r in csv.DictReader(open(csv_path, encoding="utf-8"))}
jour = datetime.date.fromisoformat(date_run)

def cadrage(v):
    v = (v or "").lower()
    if "close" in v: return "gros plan"
    if "medium" in v: return "plan moyen"
    if "wide" in v or "full" in v: return "plan large"
    return "autre"

compte = collections.Counter()
par_concurrent = collections.defaultdict(lambda: [0, 0])
textes = collections.Counter()
for c in creas:
    d, m = c["data"], manifest.get(c["filename"], {})
    conc = c.get("competitor") or m.get("competitor", "?")
    compte["cadrage: " + cadrage(d["composition"].get("framing"))] += 1
    compte["contraste: " + str(d["color_palette"].get("contrast_level"))] += 1
    if d["text_ocr"].get("present"): compte["texte sur l'image"] += 1
    textes[m.get("primary_text", "")] += 1
    par_concurrent[conc][0] += 1
    if m.get("start_date"):
        if (jour - datetime.date.fromisoformat(m["start_date"])).days >= 60:
            par_concurrent[conc][1] += 1

n = len(creas)
for k, v in sorted(compte.items()):
    print(f"{k} : observé sur {v}/{n} créas")
for conc, (tot, longues) in par_concurrent.items():
    print(f"{conc} : {tot} créas, {longues} actives depuis 60 jours ou plus")
doublons = sum(v for t, v in textes.items() if t and v > 1)
print(f"créas qui partagent leur texte avec une autre : {doublons}/{n}")
python3 agreger.py structured/creatives-structured.json creatives-manifest.csv 2026-04-17
Sortie sur notre run, concurrents anonymisés :
cadrage: gros plan : observé sur 8/29 créas
cadrage: plan moyen : observé sur 18/29 créas
contraste: Medium : observé sur 20/29 créas
texte sur l'image : observé sur 29/29 créas
Concurrent A : 15 créas, 0 actives depuis 60 jours ou plus
Concurrent B : 8 créas, 8 actives depuis 60 jours ou plus
Concurrent C : 6 créas, 6 actives depuis 60 jours ou plus
créas qui partagent leur texte avec une autre : 13/29
La ligne « texte sur l'image : 29/29 » est fausse : voyez le piège n°2.
Étape 5 : écrire des constats « observé sur N créas »
Notre règle : aucune statistique inventée, chaque constat porte son compte (« observé sur 20 créas sur 29 »).
Les 11 sections du rapport
Notre gabarit impose onze sections dans cet ordre : en-tête (date, source, nombre de créas), synthèse en deux à quatre phrases, formats et placements, motifs visuels, couleurs et style, textes et accroches, offres et preuves, longévité, notes par annonceur, recommandations, hypothèses testables. Bornez les recommandations : deux à quatre choses à adopter, une ou deux à éviter, un ou deux espaces libres.
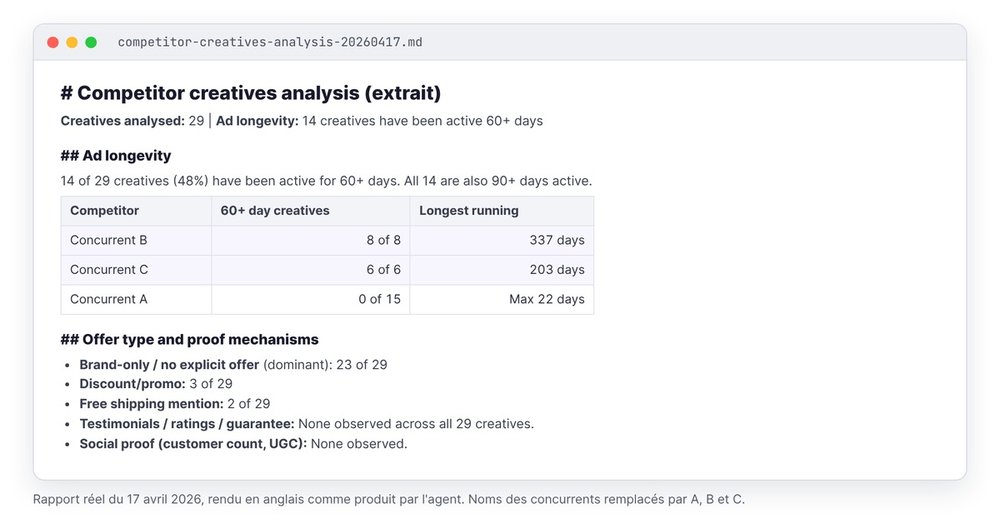
Dans le run du 17 avril, la section offres et preuves contenait ceci : aucune offre explicite sur 23 créas sur 29, une accroche liée à une occasion de l'année sur 20 créas sur 29, et zéro témoignage, note client, garantie ou preuve sociale sur les 29. Dans la section longévité, deux stratégies opposées apparaissent : le plus gros annonceur faisait tourner 15 créas récentes (toutes lancées depuis moins de quatre semaines), les deux plus petits gardaient toutes les leurs plus de 90 jours.
Des constats aux hypothèses de test
Le rapport finit par deux ou trois tests concrets, tirés des trous observés. Avec zéro preuve sociale sur 29 créas, le test évident oppose une créa avec une citation client à la même créa sans citation. Formulez le test sans prédire de résultat. Pour transformer ces tests en visuels, suivez notre méthode pour créer une pub avec l'IA.
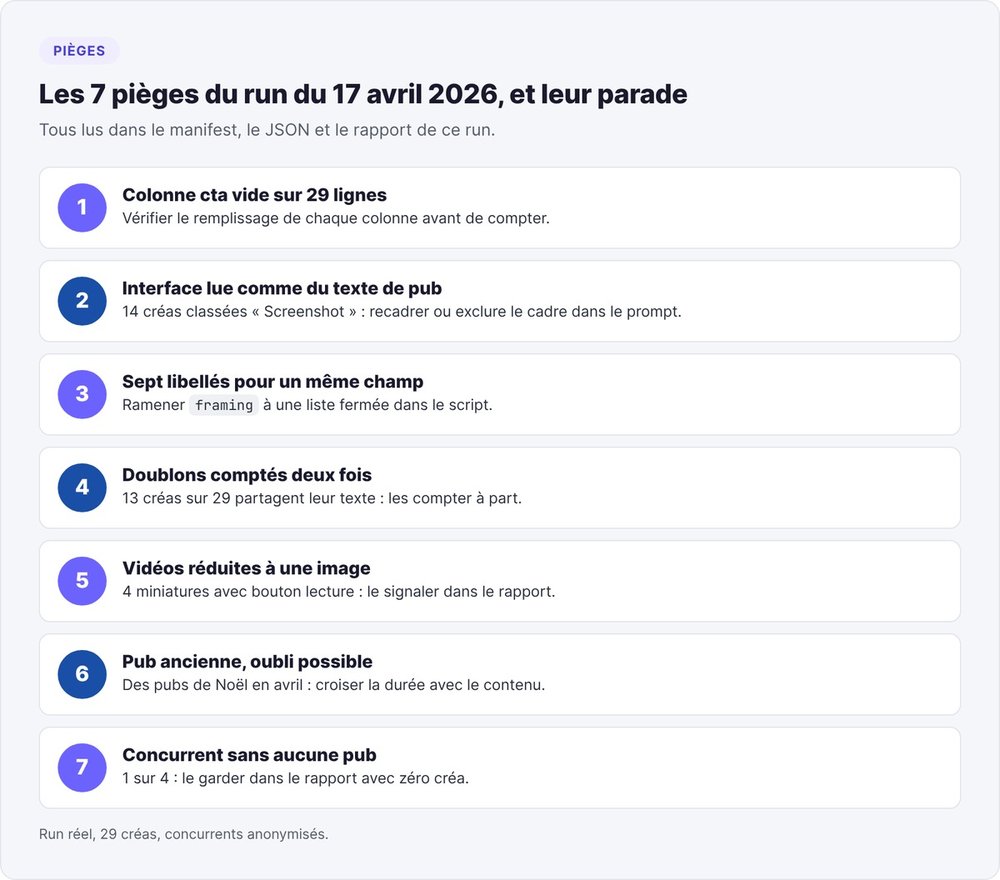
Les 7 pièges de notre run du 17 avril 2026
1. La colonne CTA vide
La colonne cta du manifest est restée vide sur les 29 lignes : le bouton d'action n'existait que dans l'OCR du modèle. Vérifiez le taux de remplissage de chaque colonne avant de compter.
2. L'interface de la bibliothèque lue comme du texte de pub
Le modèle a classé 14 créas sur 29 comme « Screenshot » et a recopié le bouton « En savoir plus » et le nom de domaine comme du texte de créa. D'où le « 29/29 » du script, contre 18 créas avec un texte incrusté dans le visuel à la relecture. Recadrez les captures ou ajoutez la ligne d'exclusion au prompt.
3. Sept libellés pour un même champ
Le cadrage est sorti en sept variantes pour quatre notions : normalisez avec une liste fermée, comme dans le script.
4. Les doublons comptés deux fois
13 créas sur 29 partageaient leur texte principal avec une autre : des variantes ou des tests A/B du même message. Comptez-les à part, sinon un message testé deux fois compte double dans vos pourcentages.
5. Les vidéos réduites à une image
Quatre créas étaient des vidéos, analysées sur leur seule miniature : signalez-les dans le rapport.
6. Une pub ancienne, un oubli possible
Des pubs de Noël tournaient encore en avril. Après 60 jours, une pub peut refléter un budget maintenu ou une campagne oubliée. Croisez la durée avec le contenu avant de parler de gagnant.
7. Un concurrent sans aucune pub
Un des quatre concurrents ciblés n'avait aucune pub Meta active. Gardez-le dans le rapport avec zéro créa et notez qu'il cherche ses clients par d'autres canaux.
Adapter l'analyse concurrentielle IA à un SaaS
La méthode reste la même pour un SaaS. Seuls les champs que vous comptez changent.
Choisir 3 à 5 concurrents
Prenez deux concurrents directs, un concurrent plus gros que vous et un concurrent indirect : un logiciel d'une catégorie voisine que vos clients utilisent à la place du vôtre. Vérifiez d'abord qu'ils diffusent en Europe, sinon l'API ne renverra rien de commercial. Si un concurrent n'a aucune pub, cartographiez ses autres canaux avec notre guide du growth marketing pour startups.
Les champs à surveiller pour un SaaS
Ajoutez au manifest et au script ces champs propres aux pubs SaaS :
- le type de bouton d'action : essai gratuit, démo, inscription, téléchargement ;
- la présence d'une capture de l'interface du produit dans le visuel (
objectsdu JSON) ; - la promesse chiffrée dans le titre (temps gagné, nombre d'outils remplacés) ;
- la preuve affichée : logos clients, note sur une plateforme d'avis, citation.
Ensuite, comparez vos propres pubs à ces constats en branchant votre compte avec notre tuto Meta Ads MCP dans Claude. Pour situer cette analyse dans votre outillage, voyez notre stack d'outils IA pour startup, et pour la parole client, notre méthode d'étude de marché avec Claude.
Vingt-neuf JSON, un script d'une quarantaine de lignes : la concurrence publicitaire devient un tableau que vous vérifiez ligne à ligne.
FAQ
Quelle IA utiliser pour une analyse concurrentielle ?
Prenez un modèle vision qui rend un JSON strict, comme Claude piloté depuis Claude Code, pour décrire les images. Comptez ensuite avec un script Python, plus fiable qu'un modèle pour additionner 29 fiches.
L'API Meta Ad Library donne-t-elle les images des pubs ?
Non. L'API renvoie le texte, le titre, la date de début, les plateformes et un ad_snapshot_url, une page HTML qui affiche la pub. Pour les images, enregistrez chaque créa depuis la bibliothèque ou capturez les pages avec Playwright.
Combien de temps une pub doit-elle tourner pour compter comme gagnante ?
Notre méthode retient 60 jours d'activité comme signal de « gagnant probable ». Ce signal reste indirect. Meta ne publie ni budget ni résultat pour une pub commerciale, et une pub oubliée tourne aussi longtemps.
Peut-on voir les pubs de concurrents américains ?
Dans l'interface web, oui. Par l'API, une pub qui n'a touché aucun pays de l'Union européenne ne remonte que si elle traite de politique ou d'enjeux sociaux. Pour un concurrent qui ne diffuse qu'aux États-Unis, passez par l'interface et remplissez le manifest à la main.
Combien de créas faut-il pour tirer des conclusions ?
Sur nos 29 créas de trois annonceurs actifs, un motif présent sur 20, ou absent des 29, se lisait sans ambiguïté. En dessous d'une dizaine de créas par concurrent, présentez vos constats comme des pistes et donnez toujours le compte exact.
Est-ce légal de télécharger les pubs de ses concurrents ?
La documentation de l'API indique que vous pouvez télécharger des créas individuelles, images et textes, pour les analyser, dans le respect des conditions d'utilisation de Meta. Le téléchargement en masse n'est pas proposé. Gardez ces fichiers pour l'analyse interne et ne republiez pas les visuels.