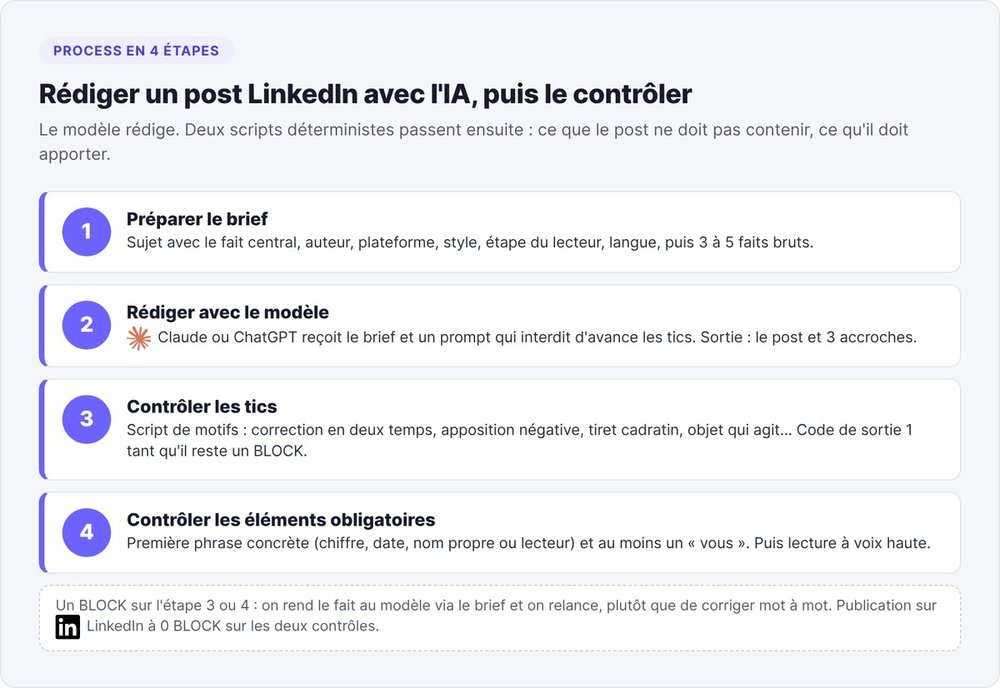
Pour rédiger un post LinkedIn avec l'IA sans qu'il sonne IA, séparez deux métiers. Le modèle (Claude, ChatGPT) écrit à partir d'un brief qui contient déjà vos faits. Deux contrôles automatiques passent ensuite sur son texte : le premier cherche ce que le post ne doit pas contenir (tirets cadratins, correction en deux temps, objet qui agit à la place d'une personne), le second vérifie ce qu'il doit apporter (une première phrase concrète, une adresse au lecteur). Vous publiez quand les deux sortent à zéro alerte bloquante.
Ce tuto suit le process que nous utilisons pour les textes de swanbase. Les seuils et les mesures viennent de nos fichiers, relancés le 12 octobre 2026. Une mesure résume le problème : sur 18 runs de notre agent de rédaction, produits avant l'existence du contrôle, le script relève 263 alertes bloquantes pour 21 301 mots, soit 12,3 pour 1 000 mots. Sur de la prose humaine (Flaubert, Hugo, Wikipédia), le même type de contrôle en relève 0,13.
Pourquoi un post LinkedIn rédigé par l'IA se repère
Les tournures typiques d'un texte généré se comptent et se nomment. Notre script de contrôle en suit 31 familles en français. Les premières viennent des corrections faites à la main sur nos textes entre le 7 et le 11 août 2026, les suivantes d'une fiche sur les tics d'écriture IA, croisée avec les articles de notre blog pour fixer les seuils.
Les tics de surface
Les plus fréquents dans un post généré :
- la correction en deux temps : une négation, puis l'affirmation qu'elle préparait, dans la même phrase ;
- l'apposition négative en fin de phrase, après une virgule ;
- le tiret cadratin, rare chez un auteur français hors dialogue ;
- l'objet qui agit à la place d'une personne : des résultats qui parlent, un tableau de bord qui décide ;
- le participe présent de remplissage en fin de phrase (garantissant, permettant, soulignant) ;
- les phrases de quatre mots enchaînées par trois, et la question suivie de sa réponse en deux mots ;
- l'annonce dramatique d'une révélation, qui retarde le fait ;
- la foule vague (une majorité de fondateurs, sans donnée derrière).
Notre propre outil n'y échappe pas. Nous donnons au modèle un fichier de référence avec des exemples pour chacun des sept styles de notre agent de rédaction. Ce fichier sort à 77 alertes bloquantes au contrôle, dont 50 tirets cadratins et 4 intertitres en proposition relative. Les exemples fournis au modèle portaient les tics qu'on voulait lui retirer.
Le texte plat sans aucun tic
La deuxième catégorie échappe à tout script. Un post sans tic peut ne contenir aucun chiffre et ne parler à personne. Le 15 août 2026, un email aux participants d'un de nos programmes est sorti à zéro alerte, et un des fondateurs l'a renvoyé avec, parmi ses mots, « incompréhensible ». Le texte ne violait aucune règle et n'apportait rien : ce rejet a donné le second contrôle.
Étape 1 : préparer un brief avec vos faits
Un modèle invente ce que vous ne lui donnez pas. Notre agent de rédaction suit la consigne « pas de recherche » : il écrit à partir du brief et de rien d'autre. Un chiffre absent du brief devient une généralité ou un chiffre inventé.
Les six champs du brief
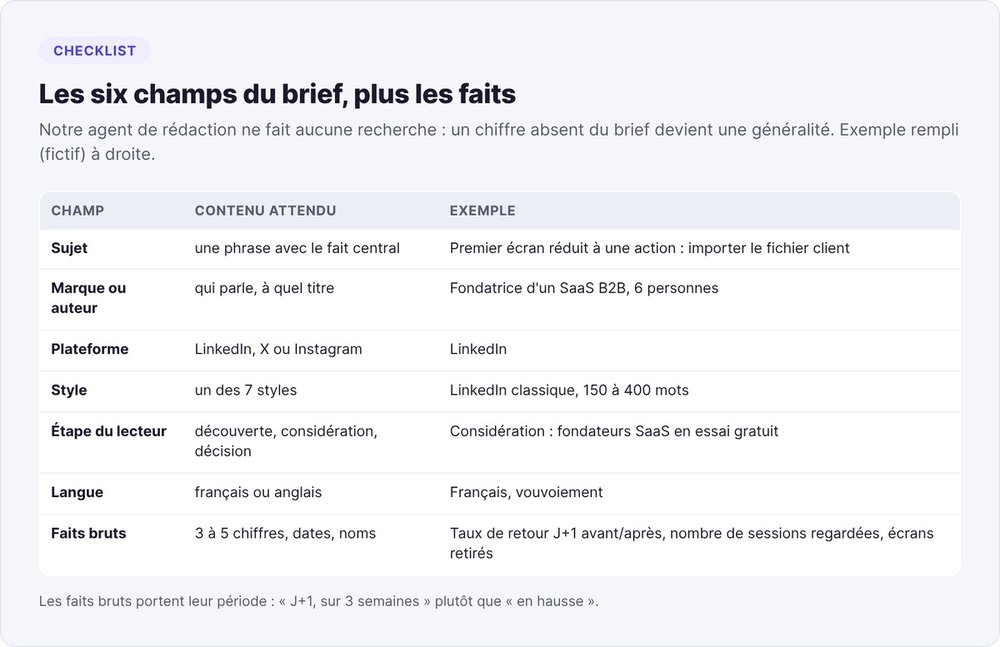
Le brief minimal de notre agent compte six champs. Remplissez-les avant d'ouvrir Claude ou ChatGPT :
- Sujet : une phrase, avec le fait central (un chiffre, une date, une décision).
- Marque ou auteur : qui parle, à quel titre.
- Plateforme : LinkedIn, X ou Instagram. La longueur en dépend.
- Style : un des sept styles (détail à l'étape 2).
- Étape du lecteur : découverte, considération ou décision.
- Langue : français ou anglais.
Ajoutez sous le brief trois à cinq faits bruts : chiffres avec leur période, noms d'outils, dates, citation d'un client avec son accord.
Choisir l'angle selon l'étape du lecteur
Notre agent propose deux ou trois angles avant d'écrire, puis choisit selon l'étape :
- Découverte (le lecteur ne vous connaît pas) : une prise de position, une donnée qui contredit l'idée reçue. L'appel à l'action se limite à une question légère.
- Considération (il connaît le problème) : une décomposition chiffrée, un avant/après, une méthode. L'appel à l'action invite à commenter ou à enregistrer.
- Décision (il compare des solutions) : une preuve, un résultat client, une offre. L'appel à l'action passe en message privé ou en lien.
Pour la stratégie de publication autour de ces posts (fréquence, plateforme, mesure), voyez notre guide du founder-led content.
Étape 2 : rédiger un post LinkedIn avec l'IA (prompt et formats)
Le prompt à copier
Le prompt reprend le brief, fixe la forme et interdit d'avance les tics les plus fréquents. L'interdiction réduit leur nombre sans les supprimer, d'où le contrôle de l'étape 3.
Tu rédiges un post LinkedIn en français pour [auteur, rôle].
Sujet : [une phrase avec le fait central].
Faits à utiliser, et aucun autre chiffre : [3 à 5 faits bruts].
Lecteur : [qui], étape [découverte | considération | décision].
Style : [linkedin-classique | punchy | storytelling...], [150 à 400] mots.
Contraintes :
- Les deux premières lignes portent le fait central, avec un chiffre ou un nom.
- Vouvoiement. Paragraphes de 2 à 4 lignes. Aucun hashtag.
- Interdits : tiret cadratin ; « ce n'est pas X, c'est Y » et ses variantes ;
  un objet ou un concept sujet d'un verbe humain (décide, parle, exige) ;
  « dans un monde où » ; « qui change tout » ; questions rhétoriques.
- Une seule action demandée, en dernière ligne.
Rends le post, puis 3 variantes de la première ligne.
Longueur et format par style
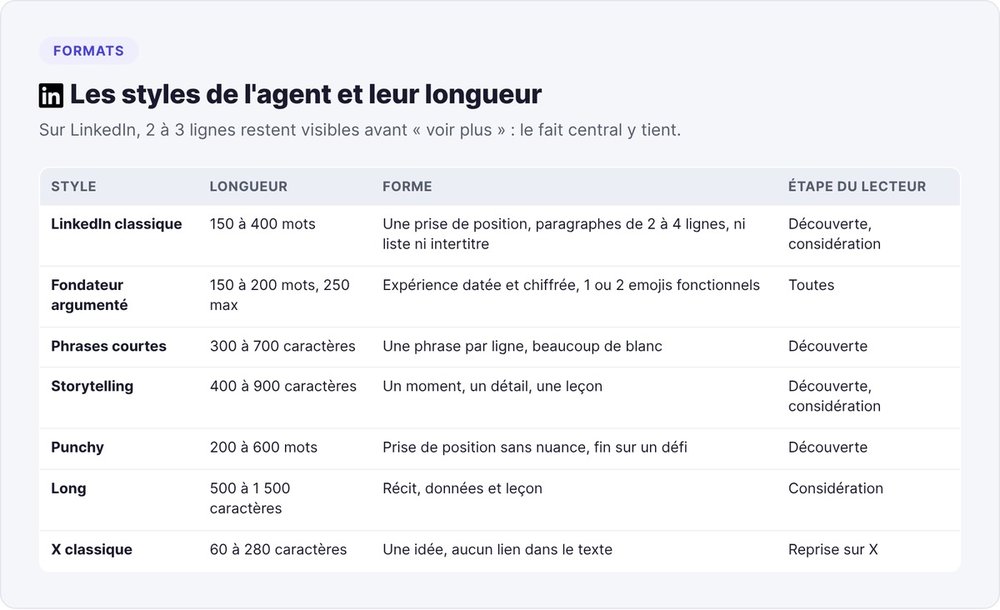
Les sept styles de l'agent fixent chacun une longueur. Sur LinkedIn :
| Style | Longueur | Forme |
|---|---|---|
| LinkedIn classique | 150 à 400 mots | une prise de position, paragraphes de 2 à 4 lignes, ni liste ni intertitre |
| Fondateur (prise de position argumentée) | 150 à 200 mots, 250 au plus | expérience datée et chiffrée, 1 ou 2 emojis fonctionnels |
| Phrases courtes | 300 à 700 caractères | une phrase par ligne, beaucoup de blanc |
| Storytelling | 400 à 900 caractères | un moment, un détail, une leçon |
| Punchy | 200 à 600 mots | prise de position sans nuance, fin sur un défi |
| Long | 500 à 1 500 caractères | récit, données et leçon |
Le style X classique (60 à 280 caractères) sert à reprendre l'idée sur X.
Les deux premières lignes
LinkedIn affiche les deux ou trois premières lignes avant le lien « voir plus ». Notre agent y place le fait central, avec un chiffre ou un nom, sans préambule. Pour faire lire ces lignes par la bonne audience, voyez aussi comment faire des vues sur LinkedIn et trouver des clients.
Étape 3 : retirer les tics avec un contrôle automatique
Une consigne de style reste probabiliste : le modèle la suit sur certains textes et la rate sur d'autres. Un script de motifs est déterministe : sur le même texte, il donne le même résultat à chaque passage. Notre contrôle tourne en deux secondes, ignore les blocs de code et rend un code de sortie 1 tant qu'il reste une alerte bloquante.
Les familles de tics et leurs motifs
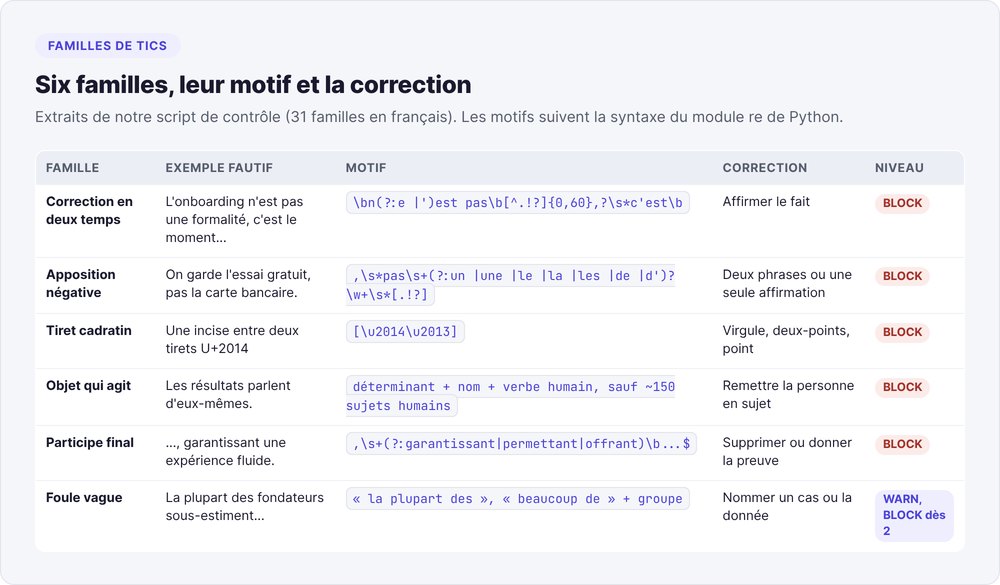
Chaque famille correspond à une expression régulière. Trois exemples tirés de notre script :
correction en deux temps   \bn(?:e |')est pas\b[^.!?]{0,60},?\s*c'est\b
apposition négative        ,\s*pas\s+(?:un |une |le |la |les |de |d')?\w+\s*[.!?]
tiret cadratin             [\u2014\u2013]
L'objet qui agit demande une liste d'exceptions. Le motif cherche un déterminant, un nom, puis un verbe d'action humain (décide, tranche, raconte, exige, sait). Il ignore le cas où le nom désigne une personne : notre liste compte environ 150 sujets humains, dont « fondateur », « client » et « jury ». Sans cette liste, « le client décide » sortirait en alerte.
Lancer le contrôle sur votre post
Le script complet compte 31 familles. Pour démarrer, une version de 40 lignes en Python suffit. Elle couvre sept familles de tics et les deux exigences de l'étape 4 :
import re, sys

# 1. Ce que le post ne doit pas contenir (BLOCK)
MOTIFS = {
    "correction-deux-temps": r"\bn(?:e |')est pas\b[^.!?]{0,60},?\s*c'est\b",
    "apposition-pas": r",\s*pas\s+(?:un |une |le |la |les |de |d')?\w+\s*[.!?]",
    "tiret-cadratin": r"[\u2014\u2013]",
    "qui-change-tout": r"\bqui change tout\b",
    "dans-un-monde-ou": r"\b(?:dans un monde où|à l'heure où)\b",
    "objet-agent": r"\b(?:le|la|les|ce|cette|vos|nos) (?!fondateur|client|équipe|lecteur)\w+ "
                   r"(?:décident?|parlent?|racontent?|exigent?|savent?|sait)\b",
    "participe-final": r",\s+(?:garantissant|permettant|offrant|soulignant|renforçant)\b[^.!?]*[.!?]?\s*$",
}
# 2. Ce que le post doit apporter (BLOCK si absent)
LECTEUR = r"\b(?:vous|votre|vos|tu|ton|ta|tes)\b"

def controler(texte):
    alertes = []
    for n, ligne in enumerate(texte.splitlines(), 1):
        for code, motif in MOTIFS.items():
            m = re.search(motif, ligne, re.I)
            if m:
                alertes.append(f"BLOCK l.{n} [{code}] {m.group(0)!r}")
    phrases = [p for p in re.split(r"(?<=[.!?])\s+", texte.strip()) if p]
    premiere = phrases[0] if phrases else ""
    if not re.search(r"\d|\b(?:vous|tu)\b|(?<!^)\b[A-ZÉ][a-zé]{2,}", premiere):
        alertes.append(f"BLOCK [ouverture-abstraite] {premiere[:70]!r}")
    if not re.search(LECTEUR, texte, re.I):
        alertes.append("BLOCK [lecteur-absent] aucun vous / votre")
    for p in phrases:
        if len(p.split()) > 30:
            alertes.append(f"WARN [phrase-longue] {len(p.split())} mots")
    return alertes

if __name__ == "__main__":
    alertes = controler(open(sys.argv[1], encoding="utf-8").read())
    print("\n".join(alertes) or "0 alerte")
    sys.exit(1 if any(a.startswith("BLOCK") for a in alertes) else 0)
Collez le post dans un fichier texte et lancez :
python3 controle_post.py post-linkedin.md
Dans Claude Code, demandez à l'agent de lancer cette commande après chaque rédaction et de corriger jusqu'à zéro BLOCK. Un hook Claude Code peut la déclencher à chaque écriture de fichier, et une skill peut porter le prompt de l'étape 2 et la commande ensemble. La syntaxe des motifs suit le module re de Python.
BLOCK ou WARN : la règle de tri
Notre script range chaque alerte dans un des deux niveaux :
- BLOCK : le motif ne sort presque jamais d'une plume humaine. Il se corrige, il ne se justifie pas.
- WARN : le motif a des usages légitimes. Vous relisez, vous gardez si la phrase porte un fait.
La voix passive sort en WARN : on admet une passive par paragraphe quand l'agent de l'action est inconnu ou sans intérêt. Quatre tournures passent en BLOCK par accumulation : l'énumération de trois adjectifs dès quatre occurrences dans le texte, le verbe faible (du type « constitue ») dès trois, l'analogie et le concept baptisé dès deux. Une énumération ternaire reste normale, quatre donnent un rythme de machine.
Étape 4 : vérifier les éléments obligatoires du post
Une ouverture concrète et un lecteur
Pour un post, notre second script exige deux éléments, en alerte bloquante :
- Une ouverture concrète : la première phrase contient un chiffre, une date, un nom propre ou une adresse au lecteur. « L'onboarding se joue dès le premier écran » échoue, « Nos essais gratuits duraient 14 jours » passe.
- Une adresse au lecteur : au moins un « vous » ou « votre ». Un post qui décrit sans parler à personne se lit comme une notice.
Deux alertes non bloquantes complètent le contrôle : une phrase de plus de 30 mots, un bloc de plus de 90 mots d'un seul tenant. Sur LinkedIn, le vouvoiement s'impose : vous parlez à une audience, le tutoiement reste pour un message privé à une personne que vous connaissez.
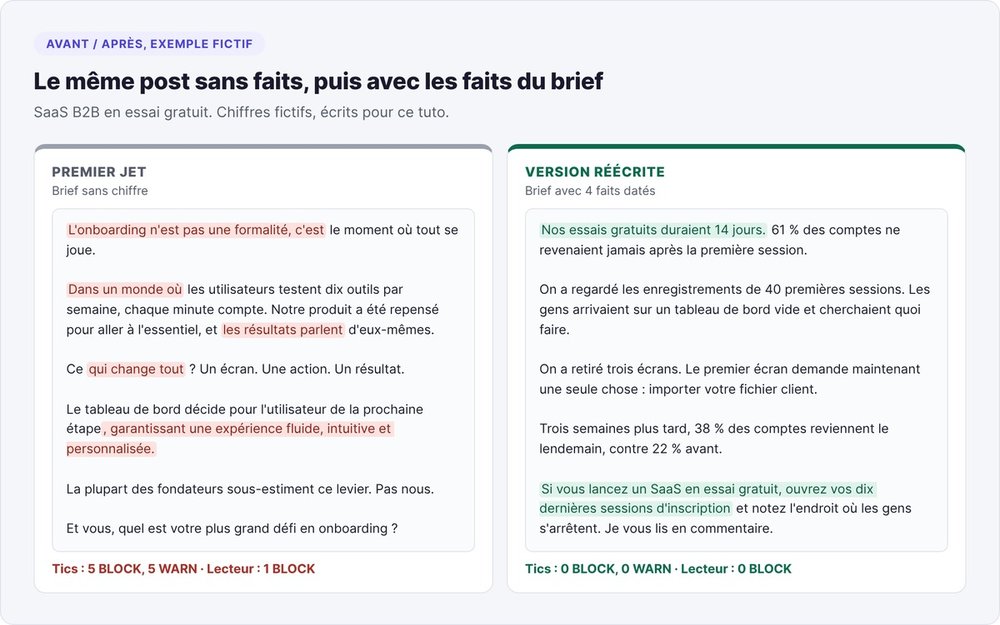
Un exemple complet avant et après
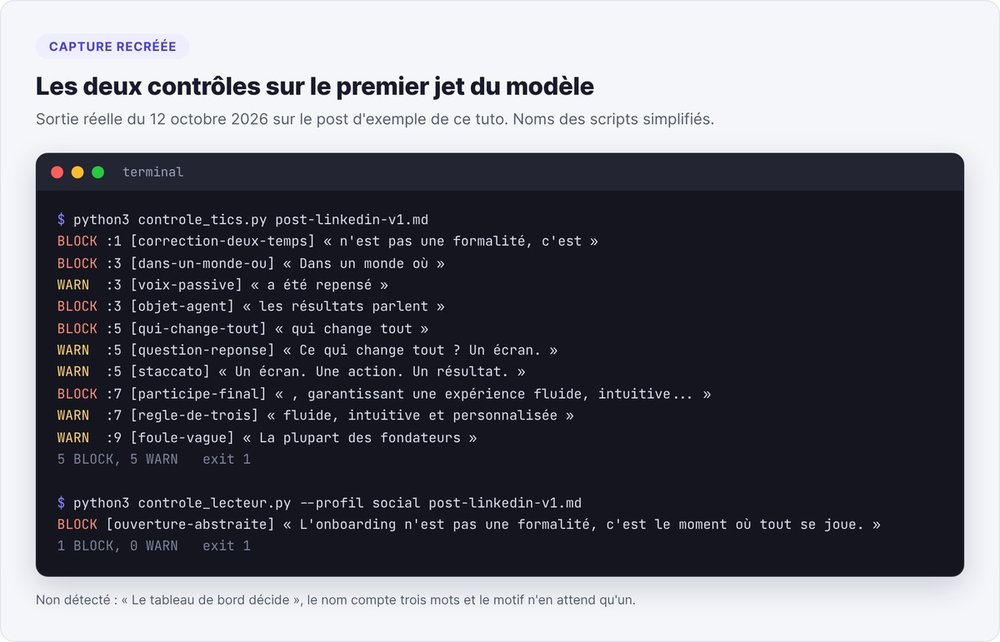
Premier jet d'un modèle, sans brief chiffré, pour un fondateur de SaaS B2B (exemple écrit pour ce tuto) :
L'onboarding n'est pas une formalité, c'est le moment où tout se joue.

Dans un monde où les utilisateurs testent dix outils par semaine, chaque
minute compte. Notre produit a été repensé pour aller à l'essentiel, et
les résultats parlent d'eux-mêmes.

Ce qui change tout ? Un écran. Une action. Un résultat.

Le tableau de bord décide pour l'utilisateur de la prochaine étape,
garantissant une expérience fluide, intuitive et personnalisée.

La plupart des fondateurs sous-estiment ce levier. Pas nous.

Et vous, quel est votre plus grand défi en onboarding ?
Notre contrôle des tics relève 5 BLOCK (correction en deux temps, formule d'époque en ouverture, objet qui agit, annonce dramatique, participe final) et 5 WARN (passive, question-réponse, staccato, règle de trois, foule vague). Le contrôle lecteur ajoute un BLOCK sur l'ouverture abstraite. Le script laisse pourtant passer « Le tableau de bord décide » : le nom compte trois mots et le motif n'en attend qu'un.
La correction passe par le brief : on redonne au modèle les faits de l'essai gratuit (chiffres fictifs de l'exemple) et on relance.
Nos essais gratuits duraient 14 jours. 61 % des comptes ne revenaient
jamais après la première session.

On a regardé les enregistrements de 40 premières sessions. Les gens
arrivaient sur un tableau de bord vide et cherchaient quoi faire.

On a retiré trois écrans. Le premier écran demande maintenant une seule
chose : importer votre fichier client.

Trois semaines plus tard, 38 % des comptes reviennent le lendemain,
contre 22 % avant.

Si vous lancez un SaaS en essai gratuit, ouvrez vos dix dernières sessions
d'inscription et notez l'endroit où les gens s'arrêtent. Je vous lis en
commentaire.
Résultat : 0 BLOCK et 0 WARN sur les deux contrôles. La seconde version n'ajoute aucune formule, seulement des faits, un lecteur et une action.
Humaniser un texte IA : outils humaniseurs ou réécriture
Le 12 octobre 2026, sept des dix premiers résultats de Google sur « humaniser texte IA » vendent un humaniseur : un outil qui reformule un texte généré pour tromper les détecteurs. Votre lecteur cherche un fait ou une raison de répondre, et une reformulation automatique n'en ajoute aucun.
Humaniser un texte IA pour LinkedIn revient à faire trois gestes :
- Remettre des faits : rouvrir le brief, ajouter le chiffre, la date, le nom qui manquaient, puis relancer la rédaction.
- Retirer les tics relevés par le contrôle de l'étape 3, en réécrivant la phrase entière plutôt qu'en remplaçant un mot.
- Lire à voix haute : notre agent porte cette consigne dans son prompt (« est-ce qu'un fondateur français parle comme ça ? »). Aucun script ne mesure la justesse du ton.
Un humaniseur reformule sans connaître vos faits : relancez les deux contrôles sur sa sortie comme sur celle du modèle.
Détecter un texte IA : nos mesures
Les détecteurs commerciaux rendent un score de probabilité. Un contrôle par motifs rend une liste de phrases, avec la règle en cause. Il ne dit pas qui a écrit le texte : il dit quelles tournures relire.
Calibrer sur de la prose humaine
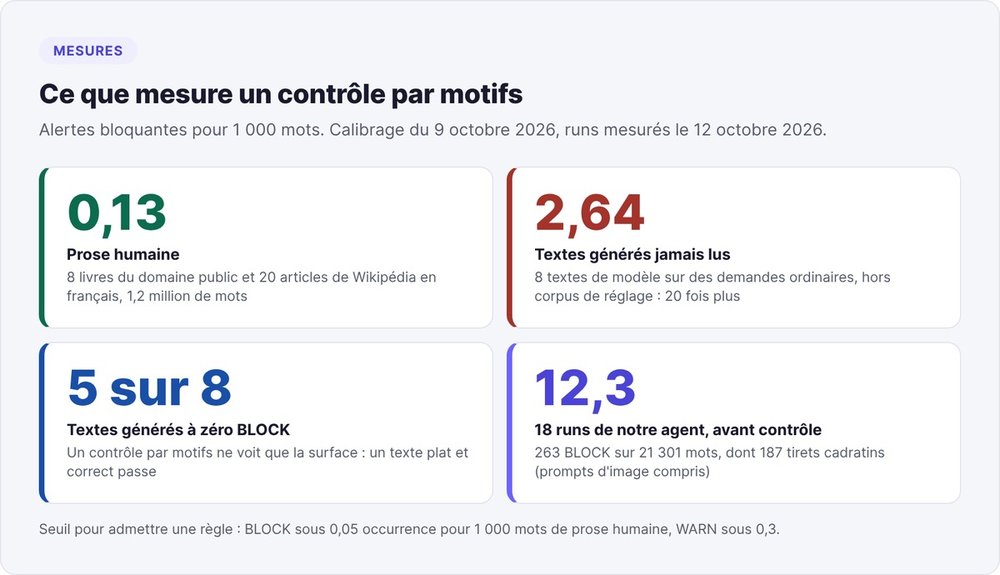
Nous avons mesuré notre contrôle le 9 octobre 2026 sur deux corpus :
- Prose humaine : huit livres du domaine public (Voltaire, Dumas, Flaubert, Hugo, Proust, Zola, Verne, Descartes, 990 000 mots) et vingt articles de Wikipédia en français (245 000 mots). Résultat : 0,12 alerte bloquante pour 1 000 mots sur les livres, 0,16 sur Wikipédia, soit une alerte pour 7 700 mots environ.
- Textes générés : huit textes écrits par un modèle sur des demandes ordinaires (post LinkedIn, email de prospection, fiche produit...), que personne n'a lus pour écrire les règles. Résultat : 2,64 pour 1 000 mots, vingt fois plus.
Le même banc montre la limite : cinq des huit textes générés sortent sans aucune alerte bloquante. Les modèles de 2026 produisent moins de tics de surface que ceux de 2023, et un contrôle par motifs rate un texte plat et correct, d'où le second contrôle et la relecture.
La page Wikipédia Signs of AI writing, tenue par les éditeurs de l'encyclopédie, recense les marqueurs anglais. L'étude de Kobak et al. sur le vocabulaire en excès dans les publications biomédicales suit le vocabulaire de plus de 15 millions de résumés indexés par PubMed entre 2010 et 2024. Nos règles anglaises s'appuient sur ces deux sources.
Ajouter vos propres motifs
Votre modèle a ses tics, et vos lecteurs en repèrent d'autres. Nous ajoutons un motif dans cet ordre :
- Écrire la phrase fautive dans un fichier de test, vérifier que le motif la déclenche.
- Lancer le contrôle sur un corpus relu par un humain (pour nous, les articles du blog, 119 au 10 octobre 2026) et compter les nouvelles alertes.
- Lire un échantillon des nouvelles alertes (douze par règle chez nous) et régler la sévérité : la règle garde le BLOCK si l'échantillon ne contient aucun faux positif franc.
- Fixer le seuil : BLOCK sous 0,05 occurrence pour 1 000 mots de prose humaine, WARN sous 0,3, refus au-delà.
Un détecteur qui sort 138 alertes bloquantes sur un corpus relu par un humain se trompe de seuil. Sur prose humaine, nos règles les plus bavardes restent le tiret cadratin (0,066 pour 1 000 mots, dans les incises de Dumas et de Hugo) et l'adjectif « véritable » (0,021).
Les pièges
- Des exemples fautifs dans le prompt. Nos exemples de styles contenaient 50 tirets cadratins. Passez vos modèles de posts au contrôle avant de les donner à l'IA.
- Un chiffre inventé pour remplir. Sans faits dans le brief, le modèle produit un pourcentage de fondateurs sans origine. Notre contrôle bloque tout pourcentage de population sans source dans la phrase.
- Le zéro alerte pris pour une validation. Un post sans tic peut rester vide. Le contrôle lecteur et la lecture à voix haute restent obligatoires.
- La correction mot à mot. Retirer un tiret cadratin pour mettre une virgule laisse la phrase intacte. Réécrivez la phrase, ou rendez le fait au modèle.
- Un même brouillon pour LinkedIn et X. Le style X classique tient en 280 caractères ; repartez du brief.
Vous cherchez des clients plutôt que de l'audience : notre tuto sur l'agent IA de prospection LinkedIn applique le même principe au premier message, rédigé par le modèle et vérifié par script.
FAQ
Quelle IA utiliser pour rédiger un post LinkedIn ?
Le process de ce tuto ne dépend pas du modèle : le brief, le prompt et les deux contrôles s'appliquent à Claude comme à ChatGPT. Sur nos 18 runs, le tiret cadratin pesait à lui seul 187 des 263 alertes bloquantes, prompts d'image compris : un contrôle automatique le retire quel que soit le modèle.
Comment humaniser un texte écrit par l'IA ?
Remettez des faits (chiffres, dates, noms) dans le brief et relancez la rédaction, puis retirez les tics relevés par un contrôle de motifs en réécrivant chaque phrase signalée. Finissez par une lecture à voix haute. Un outil humaniseur reformule pour tromper un détecteur et n'ajoute aucune information pour votre lecteur.
Comment savoir si une IA a écrit un texte ?
Cherchez des tournures précises : correction en deux temps, tiret cadratin en incise, objet sujet d'un verbe humain, participe final de remplissage, phrases de quatre mots enchaînées. Sur notre banc, un contrôle par motifs relève 2,64 alertes bloquantes pour 1 000 mots de texte généré contre 0,13 en prose humaine, mais cinq textes générés sur huit passent sans alerte.
Quelle longueur pour un post LinkedIn rédigé avec l'IA ?
Entre 150 et 400 mots pour un post classique, 150 à 200 pour une prise de position argumentée, 400 à 900 caractères pour un récit court. LinkedIn affiche les deux ou trois premières lignes avant « voir plus » : le fait central doit y tenir.
Faut-il dire à son audience qu'on rédige ses posts avec l'IA ?
Votre lecteur juge les faits et l'expérience, et ceux-ci viennent de vous par le brief : le modèle les met en forme. Si vous publiez sous votre nom, relisez chaque post et assumez chaque chiffre.