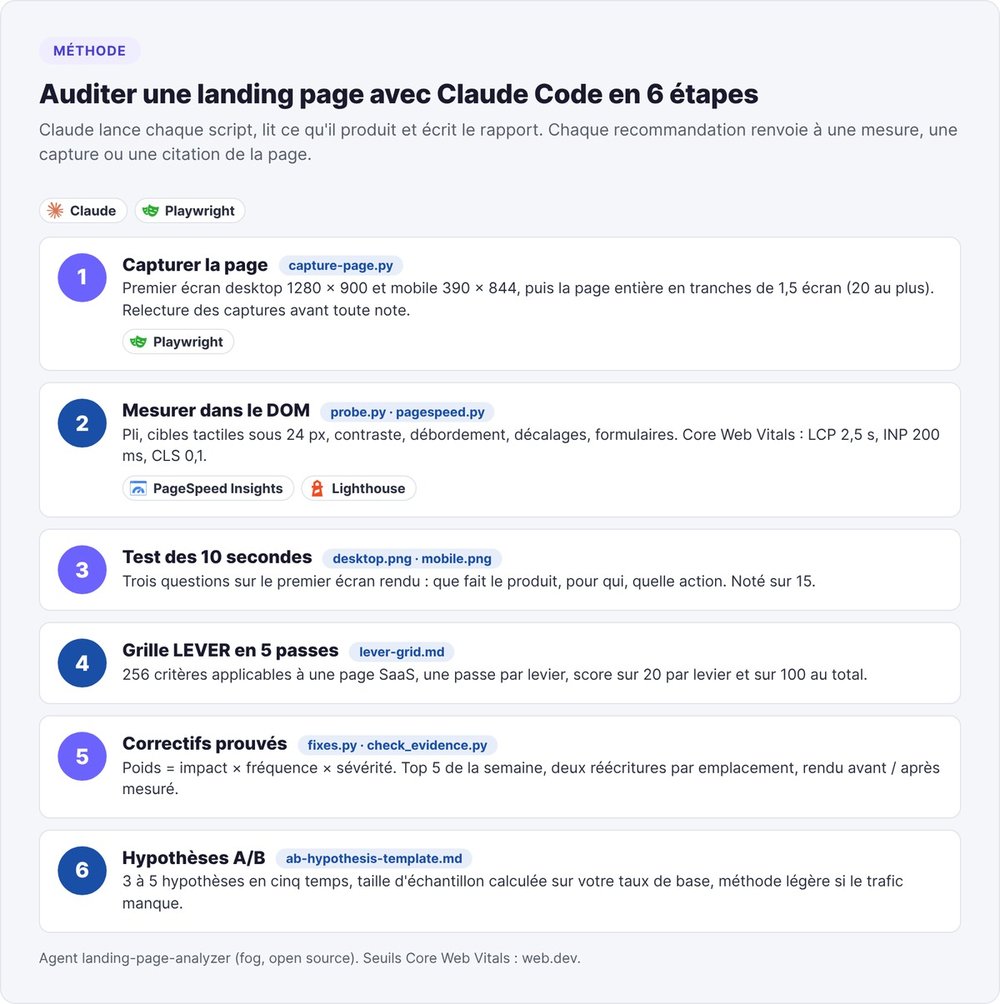
Pour auditer une landing page avec Claude Code, faites capturer la page par Playwright en desktop (1280 × 900) et en mobile (390 × 844), mesurez le premier écran et les Core Web Vitals, puis notez la page critère par critère sur une grille pondérée. Claude classe ensuite les correctifs par impact et facilité, rend chaque correctif avant et après, et rédige 3 à 5 hypothèses de test A/B avec leur taille d'échantillon.
Deux repères. Pour une page SaaS, notre grille retient 256 critères sur 340, répartis en cinq leviers. Et le 12 octobre 2026, nous avons découvert que notre sonde lisait un CLS mobile à zéro sur une page qui bougeait, parce que Chromium, en émulation mobile, attribue chaque décalage à l'utilisateur. Voici la méthode, ses commandes, ses seuils et ce qu'elle a trouvé sur swanbase.co.
Pourquoi auditer une landing page avec Claude Code ?
Un audit de landing page cherche ce qui empêche un visiteur qualifié de cliquer sur votre bouton principal. À l'œil, vous passez à côté de l'essentiel : vous connaissez votre produit, vous la lisez en desktop et vous ne voyez plus ce qu'un visiteur pressé rate sur un téléphone.
Avec Claude Code, l'audit tourne dans votre terminal : Claude lance les scripts de capture et de mesure, lit les images produites, applique la grille et écrit un rapport où chaque recommandation renvoie à une mesure, une capture ou une citation de la page.
Skill de landing page ou agent d'audit
Les skills Claude pour landing page se rangent en deux familles : ceux qui construisent une page, et ceux qui la relisent pour lui donner une note (6 dimensions sur 100 pour l'un, 8 dimensions de A à F pour un autre, 10 points sur le premier écran pour un troisième). Ces notes partent toujours d'une capture ou du texte.
Notre agent, landing-page-analyzer, fait partie de fog, notre stack open source d'agents marketing (voir notre guide des agents IA marketing). Il ajoute des mesures prises dans le DOM, une grille dont chaque ligne cite sa source et un contrôle des preuves. Pour le format lui-même, lisez notre article sur les skills Claude Code.
Prérequis avant de commencer
- Claude Code installé (voir Claude Code, définition et usages).
- Python 3.8 ou plus, et Playwright avec Chromium.
- Node.js si vous voulez Lighthouse en local quand PageSpeed Insights ne répond pas.
- L'URL de la page, l'objectif du bouton principal (inscription, démo, essai) et la cible en une phrase.
Aucune API payante n'est nécessaire. PageSpeed Insights répond sans clé à faible volume.
Étape 1 : capturer la landing page en desktop et en mobile
La capture fournit la preuve de tous les critères visuels : le premier écran tel qu'un visiteur le voit, puis le reste de la page dans un format lisible par un modèle de vision.
Lancer la capture avec Playwright
pip install -r agents/landing-page-analyzer/scripts/requirements.txt
playwright install chromium
python3 agents/landing-page-analyzer/scripts/capture-page.py ./captures-20261012 "https://votre-saas.com/"
Vous obtenez desktop.png (1280 × 900) et mobile.png (390 × 844), soit exactement le premier écran, puis la page entière en tranches de 1,5 hauteur d'écran (20 au plus), après un défilement jusqu'en bas qui charge les sections différées. Une capture pleine page d'une page longue, réduite pour le modèle, devient illisible : d'où les tranches.
Le script patiente 1,5 seconde après le chargement, ferme les bannières de cookies courantes (Cookiebot, OneTrust) et, sur une 404, laisse 5 secondes à une redirection côté client.
Relire les captures avant de noter
Avant de noter le moindre critère, Claude relit les captures avec trois contrôles : une bannière, un chargement ou un widget de chat qui masque la page ; des dimensions différentes de celles attendues ; une tranche coupée en plein milieu d'une section. Une capture ratée se corrige à la source (attente plus longue, autre méthode), jamais en retouchant l'image, en trois tours au plus. Au-delà, les critères visuels concernés passent en « non vérifié ».
Étape 2 : mesurer le pli, les cibles tactiles et les Core Web Vitals
Sur une capture, vous voyez à quoi ressemble la page. Vous n'y lisez ni la position exacte du bas du bouton, ni le décalage qu'une bannière provoque après le premier rendu. Pour ces questions, l'agent mesure.
Six mesures du DOM à la place d'un avis
python3 agents/landing-page-analyzer/scripts/probe.py "https://votre-saas.com/" --out ./mesures-20261012 --cta "Essai gratuit"
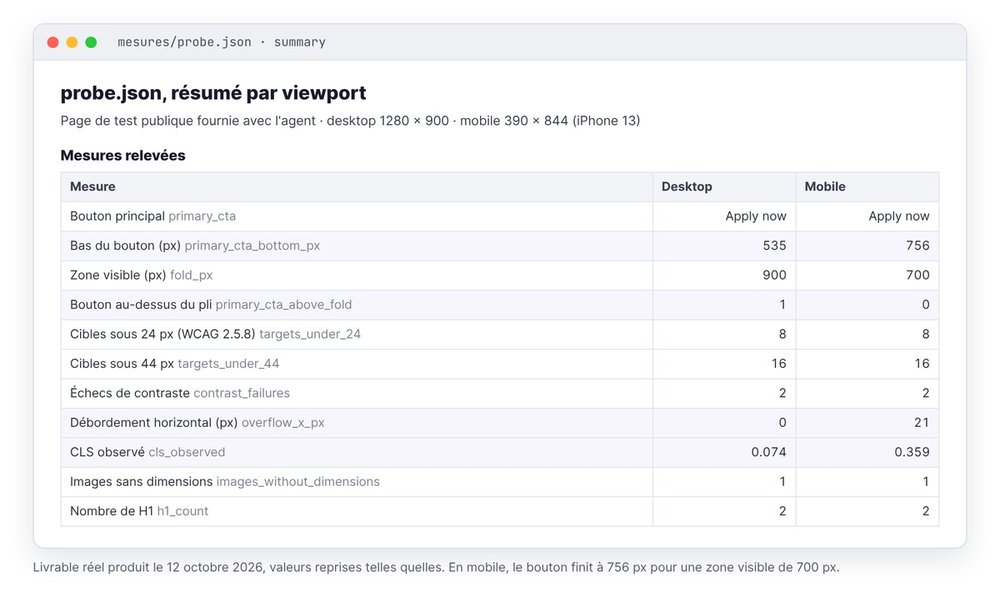
probe.py charge la page en desktop puis en mobile et relève :
- Le pli : la position du bas du bouton principal par rapport à la hauteur visible.
- Les cibles tactiles : les éléments cliquables sous 24 × 24 pixels CSS, le minimum du critère 2.5.8 des WCAG 2.2, et ceux sous 44 pixels, le repère d'Apple.
- Le contraste de chaque texte contre la couleur peinte dessous (4,5:1, ou 3:1 pour un grand texte).
- Le débordement horizontal en mobile, élément fautif compris.
- Les décalages de mise en page du chargement, avec les éléments qui ont bougé.
- Les images et formulaires : images sans dimensions, image principale en chargement différé, champs sans étiquette visible.
Le 12 octobre 2026, sur la page de test publique fournie avec l'agent, le bouton « Apply now » finissait à 756 pixels en mobile pour une zone visible de 700 (invisible sans défiler), contre 535 pixels sur 900 en desktop. La même passe a relevé 8 cibles sous 24 pixels, 2 textes sous le contraste minimum et 21 pixels de débordement causés par un tableau.
Mesurer les Core Web Vitals avec PageSpeed Insights
python3 agents/landing-page-analyzer/scripts/pagespeed.py ./mesures-20261012 "https://votre-saas.com/"
PageSpeed Insights répond en mobile, Lighthouse prend le relais en local si l'API échoue, et chaque valeur se compare aux seuils de la page Web Vitals de web.dev : LCP sous 2,5 secondes, INP sous 200 millisecondes, CLS sous 0,1, mesurés au 75e centile des visites.
Quand Google dispose de données réelles pour l'URL (CrUX), le résumé les retient, sinon il prend les valeurs de laboratoire. En laboratoire, l'INP ne se mesure pas : vous obtenez le Total Blocking Time à la place. Lisez la ligne source du résumé avant de conclure.
Le piège du CLS mobile à zéro
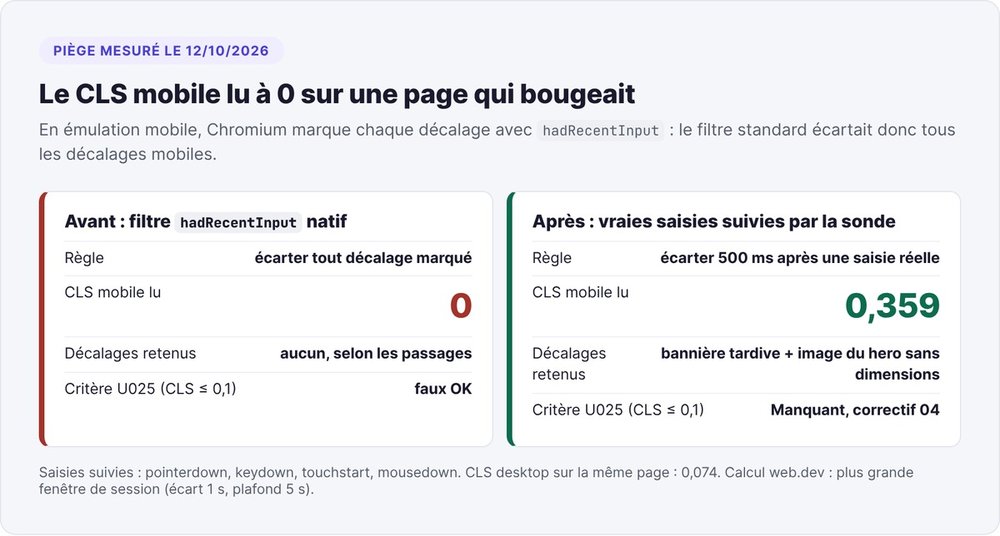
Nous suivons les décalages avec l'API layout-shift du navigateur et, comme le recommande web.dev, nous écartons ceux qui suivent une action de l'utilisateur (attribut hadRecentInput). Sur la page de test, une bannière promotionnelle insérée après le premier rendu poussait tout le contenu vers le bas. Selon les passages, la mesure mobile affichait 0.
La cause, trouvée le 12 octobre 2026 : en émulation mobile, Chromium positionne hadRecentInput sur chaque décalage, car le redimensionnement du viewport après un débordement horizontal compte comme une saisie. Tous les décalages mobiles partaient à la poubelle. La sonde enregistre désormais elle-même les saisies réelles (pointeur, clavier, toucher) et n'écarte un décalage que dans les 500 millisecondes qui suivent l'une d'elles. Le CLS mobile mesuré est passé à 0,359. Une fois la sonde corrigée, nous avons aussi vu un second décalage : l'image du hero, chargée sans dimensions.
Si vous écrivez votre propre sonde, testez-la d'abord sur une page où vous avez planté un décalage connu.
Étape 3 : le test des 10 secondes, noté sur 15
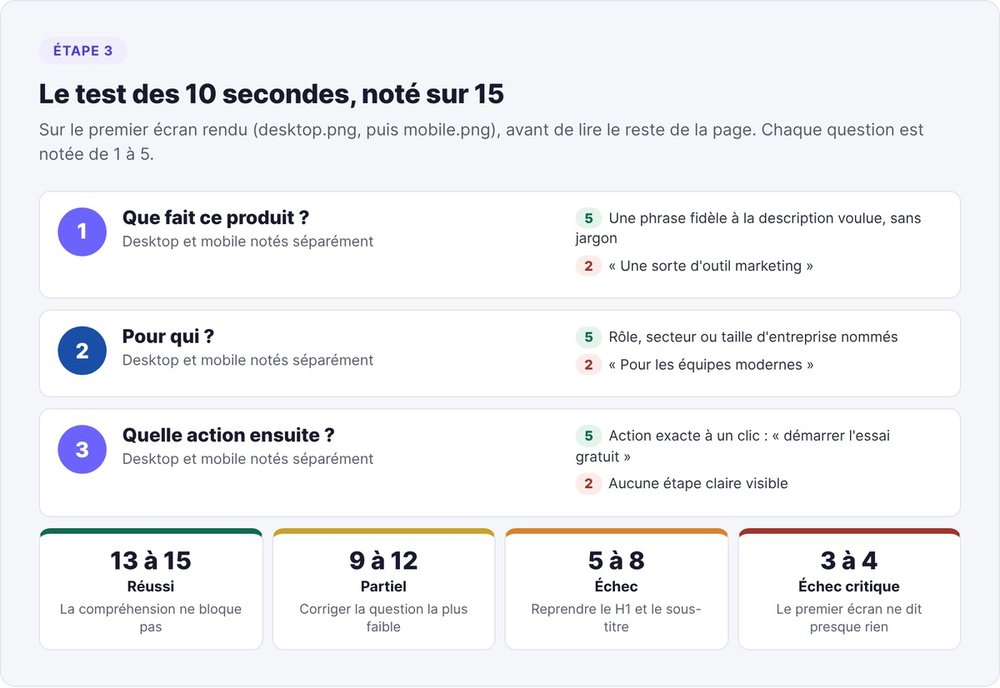
Le test des 10 secondes simule un visiteur qui ne lit que le premier écran. Claude le passe sur desktop.png et mobile.png, jamais sur une maquette, avant de lire le texte complet.
Trois questions sur le premier écran rendu
- Que fait ce produit ? Une phrase qui reprend la description voulue par le fondateur, sans jargon, vaut 5. « Une sorte d'outil marketing » vaut 2.
- Pour qui ? Un rôle, un secteur ou une taille d'entreprise nommés valent 5. « Pour les équipes modernes » vaut 2.
- Quelle action ensuite ? Une action exacte (« démarrer l'essai gratuit ») à un clic vaut 5. Plusieurs boutons de même poids font tomber la note à 4, des boutons contradictoires à 1.
Le mobile se note à part, souvent plus bas faute de place. Notre règle : si Claude doit lire le quatrième paragraphe pour répondre à la première question, le test a déjà échoué.
Lire le score
| Total sur 15 | Verdict | Action |
|---|---|---|
| 13 à 15 | Réussi | La compréhension ne bloque pas, cherchez ailleurs |
| 9 à 12 | Partiel | Une question à 3 ou moins : corrigez la plus faible d'abord |
| 5 à 8 | Échec | La compréhension bloque : reprenez le H1 et le sous-titre |
| 3 à 4 | Échec critique | Le premier écran ne dit presque rien |
Pour une refonte importante, confirmez ce test à un seul évaluateur avec cinq personnes réelles devant la page en ligne.
Étape 4 : noter la landing page SaaS sur la grille LEVER
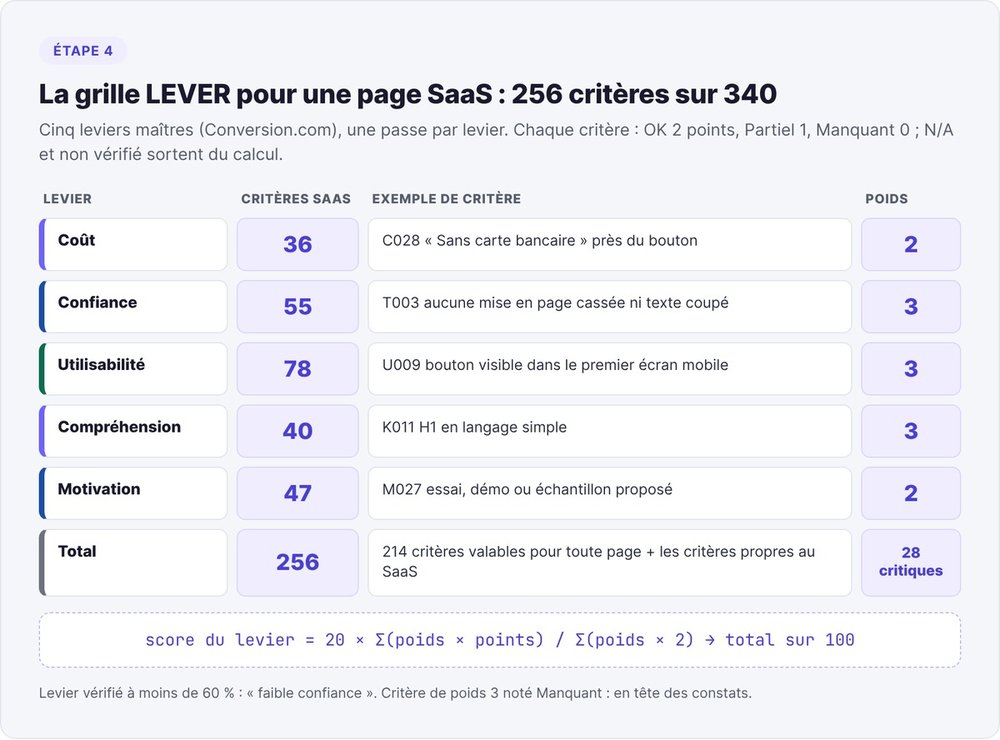
La grille LEVER suit l'arbre du Lever Framework publié par Conversion.com en décembre 2022 : cinq leviers maîtres (Coût, Confiance, Utilisabilité, Compréhension, Motivation), déclinés en 22 leviers et 48 sous-leviers. Notre version compte 340 critères vérifiables, chacun avec sa portée, la preuve qu'il exige, son poids et sa source.
256 critères pour une page SaaS
Chaque critère vaut pour toutes les pages ou pour certains types (saas, ecom, local, lead, app). Pour une page SaaS, 256 critères s'appliquent : 36 en Coût, 55 en Confiance, 78 en Utilisabilité, 40 en Compréhension, 47 en Motivation. Le rapport annonce donc « 256 critères applicables », jamais « 340 critères vérifiés ».
Chaque critère indique aussi la preuve attendue : capture (S), texte de la page (M), code HTML (H), données PageSpeed (P) ou interaction (X). Sans cette preuve, Claude classe le critère « non vérifié » au lieu de deviner.
Noter un levier par passe
Claude note tous les critères Coût, écrit les résultats dans le fichier JSON, puis seulement ouvre les critères Confiance, et ainsi de suite. Sur 256 lignes notées d'un bloc, l'attention baisse et les dernières lignes finissent validées à la chaîne.
Chaque critère reçoit OK (2 points), Partiel (1), Manquant (0), N/A ou Non vérifié. Les critères visuels se notent séparément en desktop et en mobile, puis on fait la moyenne. Toute note autre que OK porte un commentaire de 12 mots au plus, cité de la page quand c'est possible.
Le calcul du score par levier
score du levier = 20 × Σ(poids × points) / Σ(poids × 2)
La somme porte sur les critères applicables et vérifiés, avec un poids de 3 (critique), 2 (important) ou 1 (hygiène). Les cinq leviers donnent une note sur 100. Deux garde-fous : un levier vérifié à moins de 60 % porte la mention « faible confiance », et tout critère de poids 3 noté Manquant remonte en tête des constats, quel que soit le score du levier.
Cinq critères SaaS à poids élevé
Cinq critères de la grille visent directement les pages SaaS ou leur premier écran :
- C028 (poids 2) : « Sans carte bancaire » apparaît près du bouton quand c'est vrai. Le visiteur lit la réponse à son objection au moment où il hésite à cliquer.
- C020 (poids 3) : la page dit ce qui se passe à la fin de l'essai (prélèvement automatique ou non).
- U009 (poids 3) : le bouton principal reste visible dans le premier écran mobile de 390 pixels de large.
- K011 (poids 3) : le H1 dit ce que fait le produit en langage simple.
- U023 (poids 3) : LCP à 2,5 secondes ou moins en mobile.
Pour l'affichage des prix et le choix entre essai et offre gratuite, voir notre guide sur le pricing d'une startup early-stage et celui sur le product-led growth.
Étape 5 : classer les correctifs et les prouver
Le poids d'un constat et le top 5 de la semaine
Chaque critère Partiel ou Manquant reçoit trois notes de 1 à 5 : l'impact sur la conversion, la fréquence (5 au-dessus du pli, 2 dans le pied de page) et la sévérité (5 quand le défaut fait partir le visiteur). Leur produit, 125 au plus, trie les constats.
Vous rangez ensuite chaque correctif en rapide (une heure ou moins : texte, bouton, image) ou lourd (un jour ou plus : mise en page, section, performance). Le top 5 « à livrer cette semaine » puise d'abord dans les rapides, triés par impact × facilité.
Deux réécritures par emplacement
Pour le H1, le bouton principal et le bloc de proposition de valeur, l'agent nomme le défaut détecté (jargon, liste de fonctionnalités, bouton générique comme « Commencer ») et propose exactement deux réécritures qui diffèrent sur un axe : concise contre précise, bénéfice contre problème. Avec deux options, vous tranchez en connaissance de cause et vous tenez déjà les deux versions du test A/B.
Pour ces réécritures, l'agent applique une règle stricte : un chiffre, un nom de client ou un témoignage n'y entre que s'il figure déjà sur la page, dans les preuves fournies par le fondateur ou derrière une URL source. Sinon, la réécriture part sans preuve.
Rendre chaque correctif avant et après
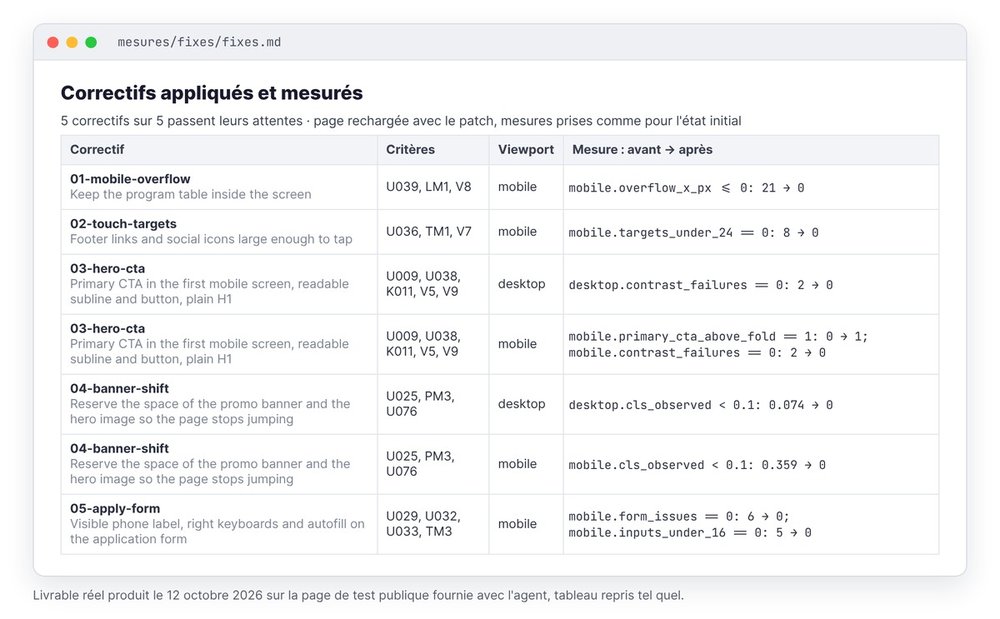
Claude écrit chaque correctif dans fixes.json : le CSS, le texte ou les attributs à changer, et la mesure attendue. Le script l'applique à la page en ligne, la recharge et mesure avant et après.
python3 agents/landing-page-analyzer/scripts/fixes.py fixes.json --out ./mesures-20261012
Sur la page de test, le 12 octobre 2026, les cinq correctifs ont tenu leurs attentes : débordement mobile de 21 à 0 pixel, cibles sous 24 pixels de 8 à 0, bouton principal ramené dans le premier écran mobile, CLS mobile de 0,359 à 0, problèmes du formulaire de 6 à 0. Votre développeur récupère patch.css et patch.js pour chacun.
Étape 6 : écrire 3 à 5 hypothèses A/B chiffrées
Un audit heuristique produit des hypothèses. Pour les départager, vous lancez un test A/B, à condition d'avoir assez de trafic.
Le gabarit en cinq temps
Parce que le test des 10 secondes ne peut pas dire ce que fait le produit à partir du H1 actuel, nous pensons que remplacer le H1 par une phrase qui nomme le résultat et le délai va augmenter le taux d'inscription pour les visiteurs mobiles venus d'une campagne payante parce que le visiteur comprend l'offre avant de décider de faire défiler.
L'agent n'annonce jamais l'ampleur du gain, faute de référence pour une page donnée. Une hypothèse sans observation sourcée, sans mécanisme ou sans moyen de perdre sort de la liste.
Combien de sessions par version
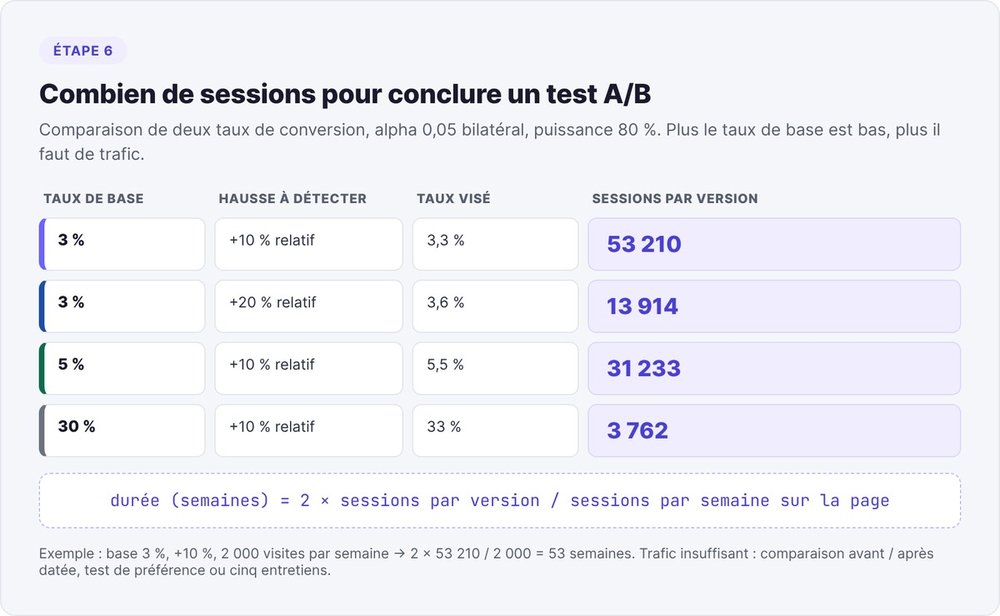
Sessions nécessaires par version pour comparer deux taux de conversion (alpha 0,05 bilatéral, puissance 80 %) :
| Taux de base | Hausse relative à détecter | Sessions par version |
|---|---|---|
| 3 % | +10 % (3 % vers 3,3 %) | 53 210 |
| 3 % | +20 % (3 % vers 3,6 %) | 13 914 |
| 5 % | +10 % | 31 233 |
| 30 % | +10 % | 3 762 |
Calculez avec votre propre taux de base :
python3 -c "from statistics import NormalDist as N; from math import sqrt; p1,rel=0.03,0.10; p2=p1*(1+rel); pa=(p1+p2)/2; za,zb=N().inv_cdf(0.975),N().inv_cdf(0.8); print(round((za*sqrt(2*pa*(1-pa))+zb*sqrt(p1*(1-p1)+p2*(1-p2)))**2/(p2-p1)**2))"
La durée suit : 2 × sessions par version / sessions hebdomadaires de la page testée.
Quand le trafic ne suffit pas
À 3 % de conversion et +10 % à détecter, il faut 106 420 sessions au total : une landing page à 2 000 visites par semaine mettrait 53 semaines à départager les deux versions. L'agent le signale alors et propose une méthode plus légère : comparaison avant/après datée, test de préférence ou cinq entretiens avec des visiteurs de votre cible. Pour choisir les indicateurs à suivre pendant ces semaines, voir notre guide du growth marketing pour startup.
Résultats de l'audit sur swanbase.co
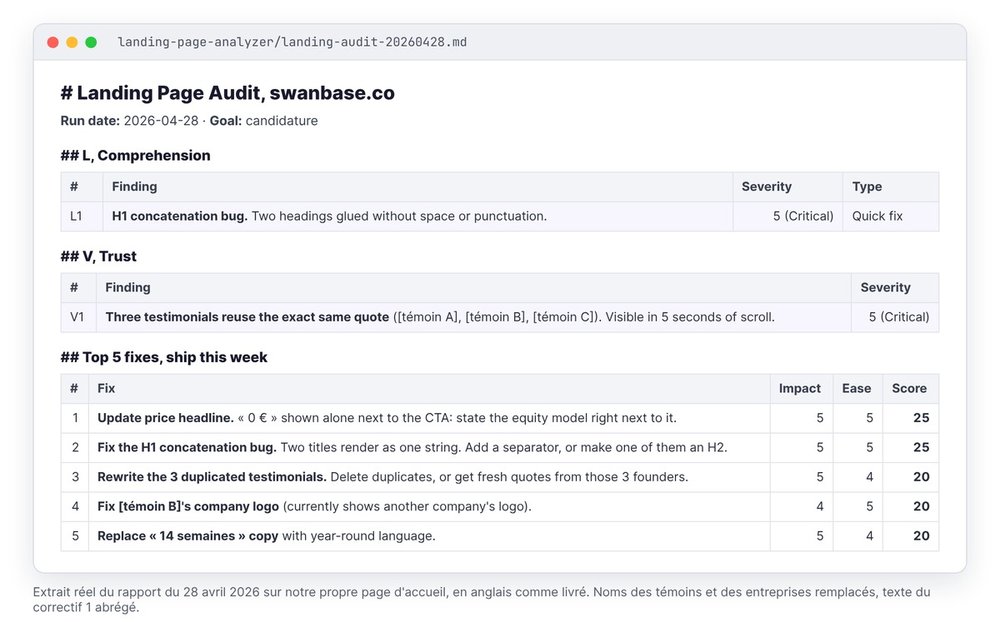
Le 28 avril 2026, nous avons lancé la première version de l'agent sur notre propre page d'accueil, objectif candidature. Cinq constats ont pesé :
- Un H1 cassé. Deux titres s'affichaient collés, sans espace ni ponctuation. Sévérité 5, correctif rapide.
- Des témoignages en double. Trois témoignages reprenaient la même citation mot pour mot, deux autres une seconde citation, et l'un affichait le logo d'une autre entreprise. Cinq secondes de défilement suffisent pour le voir.
- Un « 0 € » seul près du bouton. La page affichait le prix sans dire que swanbase prend de l'equity : le candidat l'aurait découvert au moment de signer. Sévérité 5.
- Une promesse datée. La page annonçait un programme de 14 semaines alors que swanbase accompagne les fondateurs à l'année.
- Deux boutons sans différence claire. « Rejoindre » ouvrait un formulaire externe, « Candidater » une page du site.
Le top 5 a donné 25 points (impact 5 × facilité 5) au prix et au H1, 20 aux témoignages. Le constat le plus utile est venu de la comparaison entre la page et notre positionnement réel, une étape absente de l'agent à l'époque : la version actuelle charge le contexte du projet dès le départ. Ce jour-là, impossible d'auditer le mobile : l'option de scraping mobile manquait à la CLI utilisée. D'où les captures Playwright en 390 × 844 de la version suivante.
Le prompt à donner à Claude Code
Ouvrez Claude Code à la racine du dépôt de l'agent et donnez-lui l'URL, l'objectif et la cible :
Lance l'agent landing-page-analyzer (agents/landing-page-analyzer/).
URL : https://votre-saas.com/
Objectif : inscriptions à l'essai gratuit.
Cible : responsables sales ops B2B, SaaS de 50 à 500 salariés.
Type de page : saas. Langue du rapport : fr.
Pour chaque information manquante, l'agent applique une valeur par défaut et la note dans la méthodologie du rapport (seule l'URL n'en a pas). Vous recevez le rapport en markdown avec un fichier JSON. Lancez ensuite check_evidence.py : il signale toute recommandation qui ne pointe pas vers une mesure, une capture ou une citation présente sur la page.
L'agent est open source et gratuit : vous le trouverez avec le reste du stack sur fog-agents.com. Une fois la page corrigée, branchez votre suivi de trafic organique avec notre méthode Search Console et Claude Code.
FAQ
Un skill Claude suffit-il pour auditer une landing page ?
Un skill qui lit une capture donne un premier avis. Ce skill estime à l'œil la position du bouton, les cibles tactiles et la stabilité de la page, sans les mesurer. Pour décider quoi corriger avant d'acheter du trafic, ajoutez des mesures dans le DOM et une grille dont chaque critère exige une preuve.
Faut-il payer une API pour auditer une landing page ?
Non. La capture passe par Playwright en local, PageSpeed Insights répond sans clé à faible volume et Lighthouse tourne en local en repli. Seul l'abonnement Claude Code reste à votre charge.
L'audit risque-t-il d'envoyer votre formulaire ?
Non. Le script de parcours bloque toute écriture (POST, PUT, PATCH, DELETE) pendant l'envoi final et vers les services de paiement, et n'accepte que des e-mails de test sur un domaine réservé comme example.com. Le 12 octobre 2026, sur la page de test, le script a bloqué 4 envois et aucune écriture n'a atteint le réseau.
Peut-on auditer une page derrière une connexion ?
Pas directement : la capture ne gère pas la connexion. Déposez vos captures dans le dossier de sortie et collez le texte visible. L'agent passe le reste en « non vérifié ».
Test des 10 secondes ou test des 5 secondes ?
Le test des 10 secondes est le réglage par défaut. Le test des 5 secondes pose les mêmes questions avec un barème plus dur. Réservez-le aux pages denses ou à celles qui reçoivent du trafic payant.
Quelles données apporter à l'audit ?
L'URL, l'objectif du bouton principal et la cible. Pour chiffrer les tests A/B, ajoutez votre taux de conversion actuel et le trafic hebdomadaire de la page. Sans ces deux chiffres, l'agent laisse la taille d'échantillon vide plutôt que d'inventer un nombre.