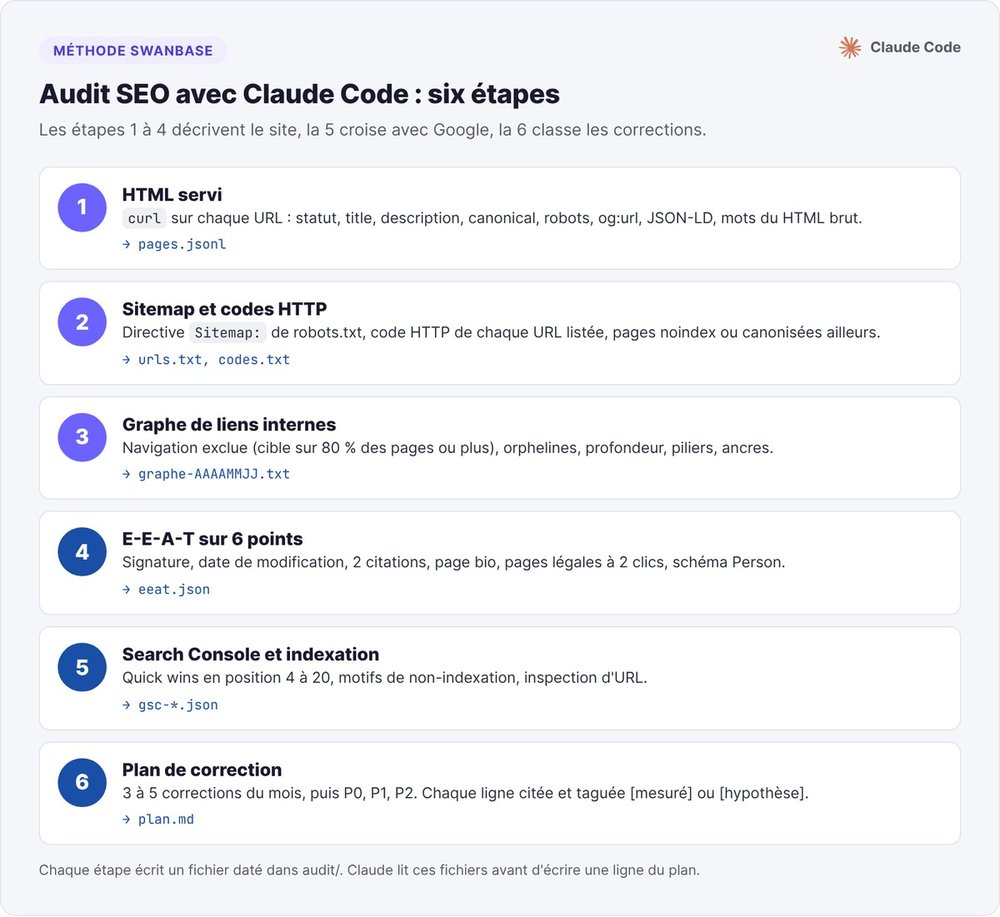
Pour faire un audit SEO avec Claude Code, vous lui faites exécuter six étapes dans votre terminal : lire le HTML servi avec curl, tester les codes HTTP du sitemap, construire le graphe de liens internes, noter chaque article sur six signaux E-E-A-T, croiser avec Search Console, puis écrire un plan de correction priorisé. Des scripts produisent les mesures. Claude lit les fichiers, écarte les faux positifs et classe les corrections.
Notre audit de swanbase.co du 31 août 2026 a parcouru 363 pages. Il a trouvé 11 orphelines, dont 3 fichiers sitemap qui n'ont rien à faire dans un maillage. Le même jour, /sitemap.xml répondait 200 avec le contenu de notre page 404. Voici les commandes, les seuils et les pièges de notre méthode.
Pourquoi faire un audit SEO avec Claude Code plutôt qu'avec un outil en ligne ?
Le 12 octobre 2026, sur la requête « audit seo ia », la première page de Google alignait surtout des outils gratuits et des pages d'agence. Vous collez une URL, l'outil rend un score. Pour un site SaaS de quelques centaines de pages, il vous faut toutes les pages, vos propres seuils et une trace de chaque constat.
Les angles morts des outils d'audit SEO IA gratuits
Une canonical qui pointe vers un autre domaine, un sitemap qui liste des pages en noindex, une page orpheline : ces défauts n'apparaissent qu'en croisant le site entier, et un outil qui note une URL à la fois ne les voit pas. Un tutoriel anglais bien classé sur « claude code seo audit » pilote un navigateur par MCP : il lit la page après exécution du JavaScript, ce qu'une partie des robots ne fait pas.
Le partage du travail entre les scripts et Claude
Nous avons fixé une règle après un test d'avril 2026 : le rapport proposait des réécritures de titres pour des pages jamais téléchargées, avec la mention « titre actuel (probable) ». Depuis, un script récupère les pages et calcule les écarts. Claude lit les fichiers produits, repère les faux positifs et rédige le plan. Chaque valeur citée dans le rapport renvoie à la ligne du fichier de crawl qui la contient.
Préparer l'audit : quatre sources et une consigne
Créez un dossier audit/ à la racine de votre projet et lancez Claude Code depuis ce dossier. Tous les fichiers de l'audit y atterrissent, datés.
Les quatre sources à réunir
- Le HTML servi de chaque page, récupéré avec
curl. C'est ce que lit Googlebot avant le rendu, et ce que lisent les robots d'IA qui n'exécutent pas JavaScript. - Le sitemap et
robots.txt, avec le code HTTP de chaque URL listée. - Search Console : un export page × requête sur 90 jours et l'état d'indexation des pages importantes. Notre guide Search Console et Claude Code détaille la connexion et le tri.
- La page de résultats Google de vos 3 à 5 requêtes prioritaires, pour comparer votre page aux pages classées.
La règle à écrire avant la première commande
Un agent passe vite d'un chiffre à un diagnostic. Un de nos audits automatisés a produit un tableau « état réel page par page » sans avoir ouvert les fichiers. Nous avons donc écrit ces consignes, que vous pouvez coller dans le CLAUDE.md du projet :
Aucun verdict sur le contenu d'une page sans avoir lu son HTML servi en entier.
Les positions Search Console disent « cette page sous-performe », jamais « l'intro est faible ».
Tague chaque recommandation [mesuré] ou [hypothèse à vérifier].
Zéro chiffre inventé : un chiffre vient d'un fichier de l'audit, ou tu montres le calcul.
Étape 1 : lire le HTML servi avec curl
Les balises à extraire page par page
URL=https://votre-saas.fr/tarifs/
curl -sL -o page.html -w "%{http_code} %{url_effective}\n" "$URL"
grep -oiE '<title>[^<]*</title>|<link[^>]*rel="canonical"[^>]*>|<meta[^>]*(name="(description|robots)"|property="og:url")[^>]*>' page.html
grep -c 'application/ld+json' page.html
Vous obtenez le code final après redirections, puis le title, la description, la canonical, la directive robots, l'og:url et le nombre de blocs JSON-LD. Demandez à Claude de boucler sur toutes les URL du sitemap et d'écrire une ligne JSON par page.
Lisez ensuite les écarts : une canonical vers l'accueil ou vers un autre hôte, un og:url différent de l'URL, un noindex sur une page que vous voulez classer. Les longueurs de title servent d'indice seulement : Google tronque à la largeur en pixels.
Un code correct et une production cassée
En août 2026, sur le site Next.js d'un client, personne n'avait défini la variable qui portait l'URL du site. Le code se repliait sur un ancien domaine écrit en dur, parqué depuis. Les 14 pages SEO servaient une canonical, un og:url et un sitemap pointant vers ce domaine. Le code était correct et les tests passaient. Seul un curl sur la page servie montrait le défaut.
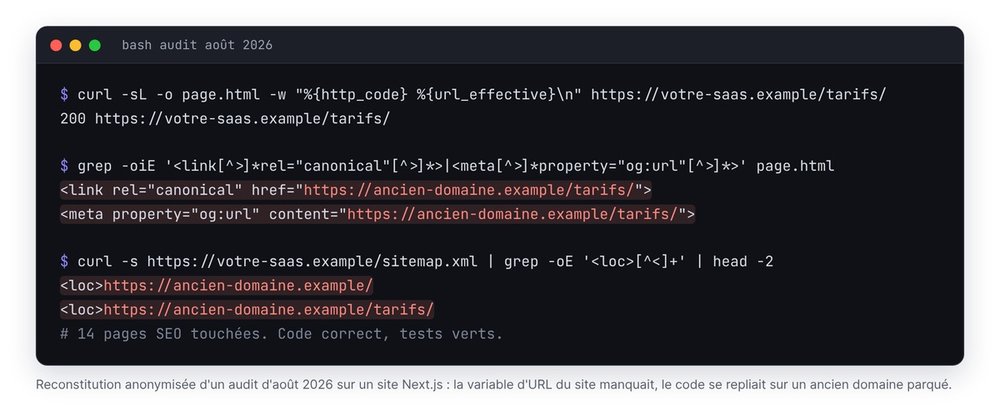
En juin 2026, sur notre propre blog, 37 articles sur 39 publiaient leur FAQ sans le JSON-LD FAQPage écrit dans le fichier source. Notre convertisseur Markdown retirait les balises <script> faute d'un drapeau dans l'en-tête de l'article. Nous avons appris le défaut en comptant FAQPage dans le HTML généré. Depuis, aucune affirmation sur un schéma ne se fait à partir du fichier source.
Les pages vides sans JavaScript
Comptez les mots du HTML brut, avant exécution du JavaScript. Sous 50 mots sur une page indexable, notre agent signale la page : les robots qui n'exécutent pas JavaScript la lisent presque vide. Les applications monopage et les listes chargées côté client tombent souvent dans ce cas.
Étape 2 : contrôler le sitemap et les codes HTTP
Trouver le sitemap déclaré
curl -s https://votre-saas.fr/robots.txt | grep -i '^sitemap:'
for p in sitemap.xml sitemap_index.xml sitemap-index.xml; do
  curl -sL -o /dev/null -w "%{http_code} %{content_type} $p\n" "https://votre-saas.fr/$p"
done
Google suit l'adresse de la directive Sitemap:. Un sitemap valide répond 200 avec un type XML, sur votre propre domaine.
Tester chaque URL du sitemap
curl -s https://votre-saas.fr/sitemap-0.xml | grep -oE '<loc>[^<]+' | cut -c6- > urls.txt
while read u; do echo "$(curl -s -o /dev/null -w '%{http_code}' "$u") $u"; done < urls.txt | grep -v '^200'
Toute ligne affichée signale une URL à retirer du sitemap ou à réparer : redirection, 404, erreur serveur. Ajoutez au contrôle les pages en noindex et celles dont la canonical pointe ailleurs : leur présence dans le sitemap contredit la page. Selon la documentation Google sur les sitemaps, un fichier contient au plus 50 000 URL ou 50 Mo non compressés, et Google ignore les valeurs priority et changefreq. Ne perdez pas une ligne de votre plan à les régler.
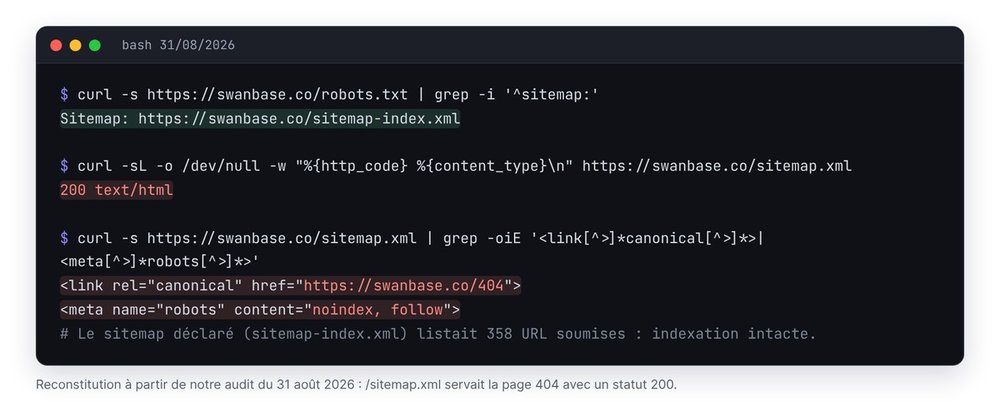
Notre sitemap.xml répondait 200 avec la page 404
Le 31 août, https://swanbase.co/sitemap.xml renvoyait le statut 200 avec le HTML de notre page 404, une canonical vers /404 et noindex, follow. Notre robots.txt pointait vers sitemap-index.xml, qui listait 358 URL soumises dans Search Console. L'indexation n'en souffrait pas. Mais un outil qui teste /sitemap.xml en premier y voit un sitemap cassé, et l'audit le remontait à chaque passage.
Étape 3 : construire le graphe de liens internes
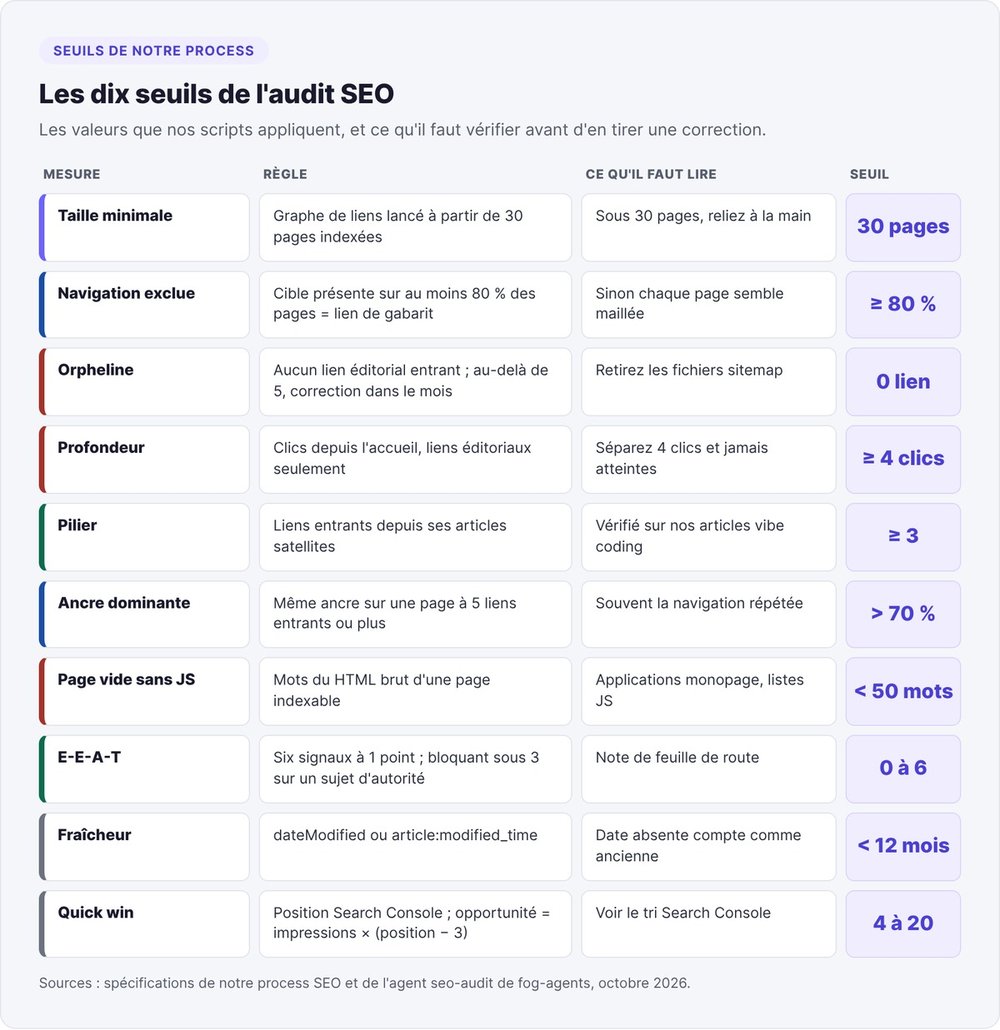
Avec le graphe, vous voyez quelles pages reçoivent des liens depuis vos contenus, à combien de clics de l'accueil elles se trouvent et avec quelles ancres. Notre process réserve le graphe aux sites de 30 pages indexées ou plus : en dessous, le résultat ne guide aucune décision.
Le script en trente lignes
Ce script reprend la liste d'URL de l'étape 2 et calcule les quatre mesures. Toute cible présente sur au moins 80 % des pages compte comme lien de navigation ou de pied de page, et sort du calcul.
import sys, re, collections, urllib.request, urllib.parse
site = sys.argv[1].rstrip("/")
urls = [u.strip() for u in open(sys.argv[2]) if u.strip()]
norm = lambda u: urllib.parse.urljoin(site + "/", u).split("#")[0].rstrip("/") or site
liens = {}  # page -> {cible: ancre}
for u in urls:
    try:
        html = urllib.request.urlopen(u, timeout=15).read().decode("utf-8", "ignore")
    except Exception:
        html = ""  # 404, 5xx : page sans liens sortants
    a = re.findall(r'<a[^>]+href="([^"]+)"[^>]*>(.*?)</a>', html, re.S)
    liens[norm(u)] = {norm(h): re.sub(r"<[^>]+>|\s+", " ", t).strip()
                      for h, t in a if norm(h).startswith(site)}
# navigation et pied de page : cible présente sur au moins 80 % des pages
freq = collections.Counter(c for cs in liens.values() for c in cs)
nav = {c for c, n in freq.items() if n / len(liens) >= 0.8}
ancres = collections.defaultdict(list)
for p, cs in liens.items():
    for c, t in cs.items():
        if c not in nav and c != p:
            ancres[c].append(t)
prof, file = {site: 0}, [site]  # parcours en largeur depuis l'accueil
while file:
    p = file.pop(0)
    for c in liens.get(p, {}):
        if c not in nav and c not in prof:
            prof[c] = prof[p] + 1
            file.append(c)
print("orphelines :", [p for p in liens if not ancres[p] and p != site])
print("4 clics ou plus :", [p for p, d in prof.items() if d >= 4])
print("jamais atteintes :", [p for p in liens if p not in prof])
for c, ts in ancres.items():
    if len(ts) < 5:
        continue
    top, n = collections.Counter(ts).most_common(1)[0]
    if n / len(ts) > 0.7:
        print(f"ancre dominante : {c} « {top} » {n}/{len(ts)}")
python3 graphe.py https://votre-saas.fr urls.txt > graphe-$(date +%Y%m%d).txt
Nous avons testé ce script sur un site de démonstration servi en local : il a signalé trois pages sans lien éditorial entrant, dont une ancienne URL redirigée en 301.
Les quatre seuils : orphelines, profondeur, piliers, ancres
- Une page orpheline ne reçoit aucun lien éditorial. Au-delà de 5 orphelines, la correction passe dans le mois.
- Une page profonde se trouve à 4 clics ou plus de l'accueil, en ne suivant que les liens éditoriaux.
- Chaque page pilier reçoit au moins 3 liens depuis ses articles satellites.
- Pour une page à 5 liens entrants ou plus, une même ancre ne dépasse pas 70 % des liens.
Lire le résultat sans se tromper : notre audit de 363 pages
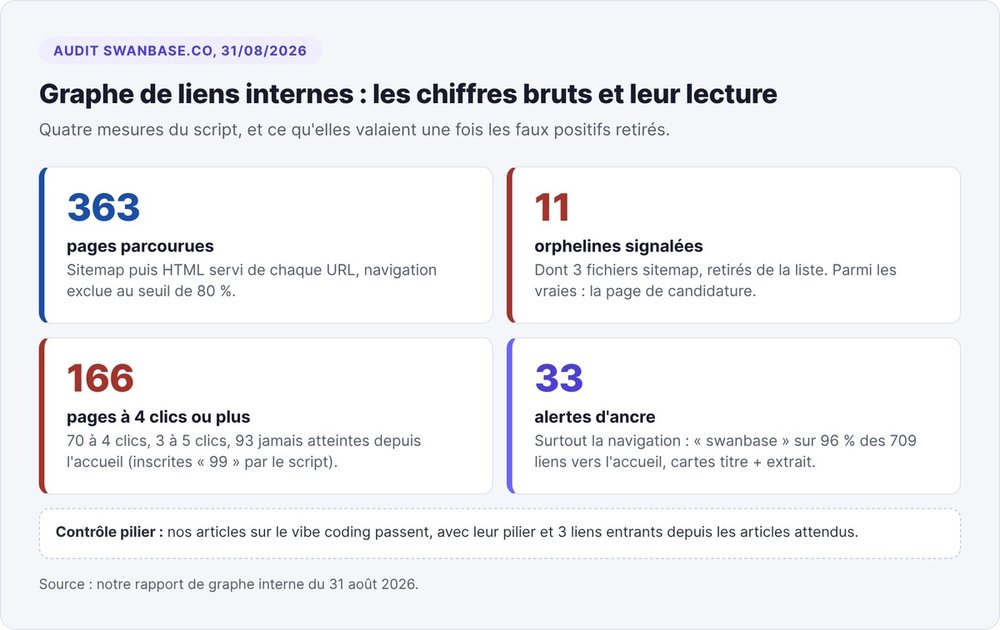
Le 31 août, notre graphe sortait 11 orphelines, 166 pages à 4 clics ou plus et 33 alertes d'ancre. Trois lectures ont changé le plan :
- 3 des 11 orphelines étaient des fichiers sitemap. Un sitemap ne reçoit aucun lien éditorial : sortez ces fichiers de la liste.
- Sur les 166 pages profondes, 70 étaient à 4 clics, 3 à 5 clics, et 93 jamais atteintes depuis l'accueil. Notre script les inscrivait à « 99 clics ». Une page jamais atteinte relève du maillage manquant, avec une autre correction qu'une page à 4 clics.
- La plupart des alertes d'ancre venaient de la navigation répétée. Le lien d'accueil portait « swanbase » sur 96 % de ses 709 liens entrants, et les cartes d'articles concaténaient titre et extrait dans l'ancre. Notre plan a classé ce point en hypothèse, sans réécriture avant inspection des pages.
Le même audit validait nos articles sur le vibe coding : pilier présent, 3 liens entrants depuis les articles attendus. Notre page de candidature, en revanche, ne recevait aucun lien éditorial.
Étape 4 : noter l'E-E-A-T sur 6 points
Google a ajouté l'Expérience à son cadre E-A-T en décembre 2022, d'après le blog Google Search Central sur l'E-E-A-T. Ce cadre décrit ce que regardent les évaluateurs de qualité. Nous en tirons six contrôles qu'un script vérifie sans jugement.
Les six signaux qu'un script peut vérifier
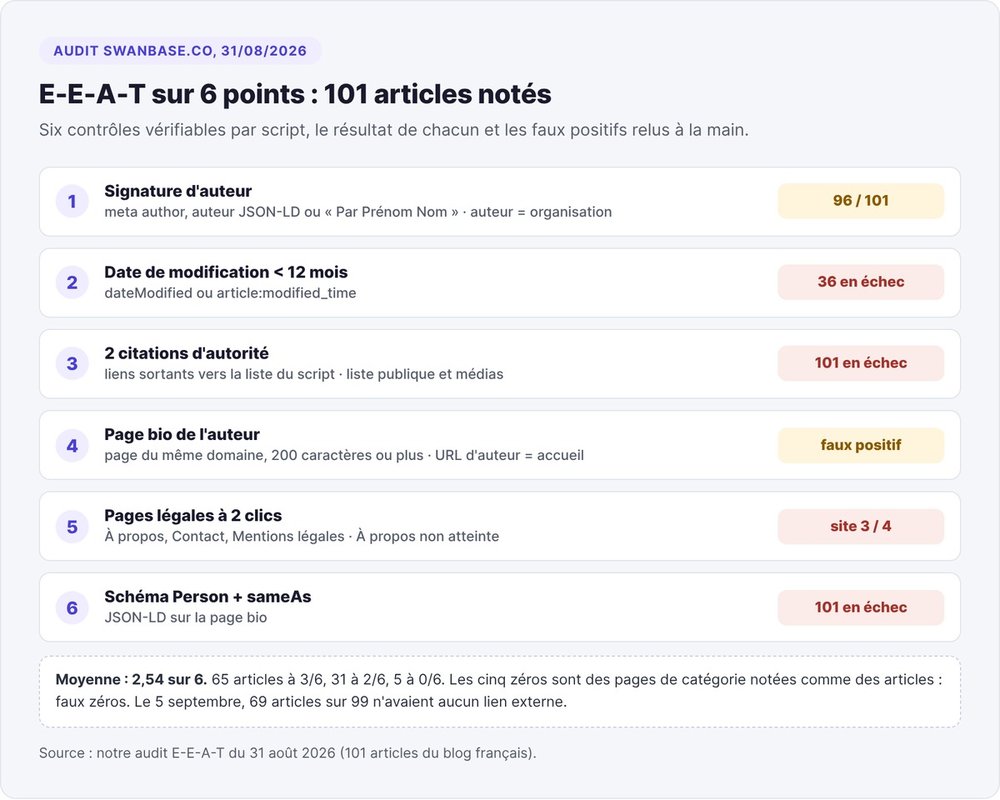
Chaque signal vaut 1 point, pour une note de 0 à 6 par article :
- Une signature d'auteur : meta
author, auteur dans le JSON-LD ou ligne « Par Prénom Nom ». - Une date de modification de moins de 12 mois (
dateModifiedouarticle:modified_time). - Au moins 2 liens sortants vers des domaines d'autorité.
- Une page bio de l'auteur sur le même domaine, liée depuis la signature.
- Les pages À propos, Contact et Mentions légales à 2 clics au plus de l'accueil.
- Un schéma
Personpour l'auteur, avec des lienssameAsvers ses profils.
Un site jeune obtient en général 1 ou 2 sur 6 : prenez la note comme une feuille de route. Elle devient bloquante sous 3 sur 6 pour les articles d'un sujet où vous visez l'autorité.
Relire notre note de 2,5 sur 6
Sur 101 articles audités le 31 août, la moyenne tombait à 2,54. 65 articles à 3/6, 31 à 2/6, 5 à 0/6. Aucun article ne portait de schéma Person, aucun ne passait le seuil des deux citations d'autorité, 36 n'affichaient pas de date de modification de moins de 12 mois.
Trois résultats demandaient une relecture. Les 5 notes à zéro visaient nos pages de catégorie, auxquelles le script appliquait des critères d'article. Le signal « page bio » passait sur chaque article parce que l'auteur déclaré dans le JSON-LD était l'organisation, avec l'accueil pour URL. Et la liste des domaines d'autorité du script ne contenait que des sites publics et des médias : un lien vers la documentation d'un éditeur ne comptait pas. Notre revue du 5 septembre a d'ailleurs relevé 69 articles sur 99 sans aucun lien externe.
Étape 5 : croiser avec Search Console et l'indexation
Dans Search Console, vous voyez quelles pages Google montre et lesquelles il refuse. Nous classons en quick win toute requête entre la position 4 et la position 20, avec une opportunité égale aux impressions multipliées par la distance au top 3 (position moins 3). Le détail des règles de tri figure dans notre guide Search Console avec Claude Code.
Pour l'indexation, exportez le rapport Pages et faites lire les motifs à Claude. Le 12 juin 2026, Search Console comptait 178 pages indexées et 204 non indexées sur swanbase.co. Environ 95 non-indexations étaient voulues ou sans gravité : 62 redirections, 21 noindex, 9 canoniques correctes, 2 pages 404 et 1 doublon. Restaient 109 pages à traiter : 63 « Explorée, actuellement non indexée », que Google a lues puis écartées, et 46 « Détectée, actuellement non indexée », jamais explorées.
Les deux groupes appellent deux corrections. Une page détectée mais jamais explorée manque de liens internes : vous la reliez depuis des pages indexées. Une page explorée puis refusée pose une question de doublon ou de contenu mince. Google n'indexait aucun de nos trois articles sur un même sujet : notre plan prévoyait de les consolider en un seul.
gsc inspect "https://votre-saas.fr/blog/<slug>/" --site "sc-domain:votre-saas.fr" --json
Étape 6 : écrire un plan de correction priorisé
Trois niveaux de priorité
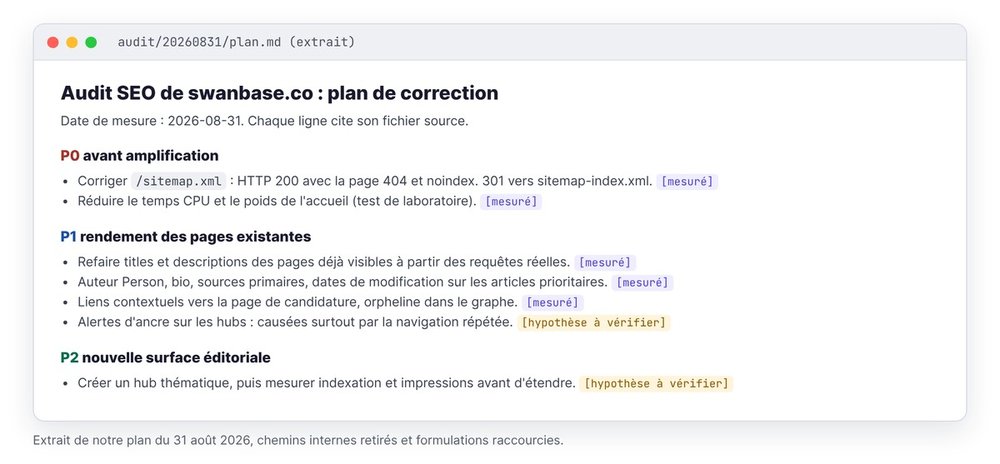
Notre audit du 31 août classait chaque correction dans un niveau :
- P0, avant toute amplification : les défauts qui faussent ce que Google lit. Chez nous, le
/sitemap.xmlen 404 servi en 200, et le temps de chargement de l'accueil. - P1, rendement des pages existantes : titles et descriptions des pages déjà visibles, auteurs, sources, liens vers la page de candidature.
- P2, nouvelle surface : les pages à créer, une fois les deux premiers niveaux traités.
Chaque ligne porte son tag. « Le sitemap renvoie la page 404 » est [mesuré]. « Les alertes d'ancre viennent surtout de la navigation » restait [hypothèse à vérifier] tant que personne n'avait ouvert les pages. Ouvrez le plan par une liste de 3 à 5 corrections « à faire ce mois-ci » : c'est la seule partie que votre équipe lira en entier.
Vérifier la page servie après chaque correction
Une correction n'existe qu'une fois servie. Après déploiement, relancez l'étape 1 sur la page corrigée : statut 200, canonical sur elle-même, og:url, présence dans un sitemap du même hôte, JSON-LD valide. Notre revue du 5 septembre a trouvé 14 anciennes URL anglaises « redirigées » par des pages 200 à rafraîchissement automatique avec noindex, au lieu de redirections 301. Suivez ensuite la page dans Search Console à 14, 28 et 56 jours.
Le prompt d'audit SEO à donner à Claude Code
Ce prompt sert aussi dans ChatGPT si vous lui fournissez les fichiers produits par les commandes. Claude Code lance les commandes lui-même et ouvre le code de votre site.
Audit SEO de https://votre-saas.fr. Travaille dans audit/AAAAMMJJ/.
1. Lis robots.txt et le sitemap déclaré. Écris urls.txt et le code HTTP de chaque URL.
2. Pour chaque URL, récupère le HTML servi avec curl et écris une ligne JSON :
   statut, title, description, canonical, robots, og:url, types JSON-LD, mots du HTML brut.
3. Lance graphe.py sur urls.txt. Retire des orphelines les fichiers sitemap.
   Sépare les pages à 4 clics et plus des pages jamais atteintes.
4. Note chaque article sur les 6 signaux E-E-A-T. Signale les pages de catégorie à part.
5. Croise avec l'export Search Console de 90 jours (data/gsc-*.json).
6. Écris plan.md : 3 à 5 corrections du mois en tête, puis P0, P1, P2.
   Chaque ligne cite le fichier et la ligne qui la prouvent, taguée [mesuré] ou [hypothèse à vérifier].
Ne modifie aucun fichier du site.
La dernière ligne compte. Gardez la main sur ce qui part en production : Claude propose, vous corrigez et vous redéployez.
Transformer l'audit SEO en skill Claude Code
Une fois le prompt stable, rangez-le dans une skill. Selon la documentation des skills Claude Code, une skill de projet vit dans .claude/skills/<nom>/SKILL.md et se lance avec /<nom> ou automatiquement quand sa description correspond à la demande.
---
name: audit-seo
description: Audit SEO technique et éditorial du site (HTML servi, sitemap, graphe de liens, E-E-A-T, Search Console). Utiliser quand on demande un audit SEO ou une baisse de trafic.
---
Suis les six étapes de audit/METHODE.md. Scripts : audit/graphe.py.
Aucun verdict sans fichier lu. Tague [mesuré] ou [hypothèse à vérifier].
Les étapes indépendantes, comme la page de résultats Google et l'E-E-A-T, peuvent partir en parallèle dans des sous-agents Claude Code. Notre guide des skills Claude Code détaille le format.
Si vous préférez partir d'un agent complet, nous publions seo-audit dans fog-agents, sous licence Apache 2.0. Ses scripts en Python standard crawlent le site avec respect de robots.txt, refusent un rapport qui cite un title sans sa ligne de crawl, et vérifient la page publiée. L'agent ne publie jamais : il vous rend un rapport et des briefs. Pour la visibilité dans les réponses des IA, il lit aussi l'accès des robots comme GPTBot, ClaudeBot ou PerplexityBot dans robots.txt ; notre article sur llms.txt complète ce volet. La présentation de l'ensemble des agents se trouve dans agents IA marketing.
FAQ
Claude Code peut-il remplacer un logiciel de crawl SEO ?
Pour un site de quelques centaines de pages, oui : curl, un script Python et Claude couvrent les codes HTTP, les balises, le sitemap et le graphe de liens. Notre audit de 363 pages a tourné avec des scripts Python et des requêtes HTTP simples. Au-delà de plusieurs milliers d'URL, un crawler dédié reste plus rapide, et Claude peut lire son export.
Peut-on faire un audit SEO avec ChatGPT ?
Oui pour l'analyse, si vous lui fournissez les fichiers : HTML récupéré, liste d'URL avec leurs codes, export Search Console. ChatGPT ne lance pas curl sur votre machine. Claude Code exécute les commandes, relit le code du site et cite la ligne de chaque constat.
À partir de combien de pages le graphe de liens internes est-il utile ?
Notre process le réserve aux sites de 30 pages indexées ou plus. En dessous, vous reliez chaque page à la main. Les seuils de profondeur et d'ancre manquent alors de données.
Combien coûte un audit SEO avec Claude Code ?
Les commandes de cet article n'utilisent aucune API payante : curl, Python et l'API Search Console sont gratuits. Vous payez votre abonnement ou votre consommation Claude. Une API de résultats Google reste optionnelle.
À quelle fréquence relancer l'audit SEO ?
Notre process prévoit le graphe de liens internes chaque mois, l'E-E-A-T et l'audit de la requête de marque chaque trimestre. Après une correction, l'agent seo-audit de fog-agents suit la page à 14, 28 et 56 jours.
Claude Code peut-il corriger lui-même les problèmes trouvés ?
Il peut proposer le correctif dans votre code : canonical, redirection 301, JSON-LD, liens internes. Notre prompt d'audit lui interdit de modifier le site. Vous appliquez ensuite les corrections choisies, puis vous relancez l'étape 1 sur la page servie.