Pour brancher Google Search Console à Claude Code, il vous faut un client OAuth Google, un outil qui appelle l'API Search Console (une CLI ou un serveur MCP) et un export page × requête sur 90 jours. Claude Code trie ensuite cet export avec des règles chiffrées. Chez swanbase, une requête devient un quick win entre la position 4 et la position 20 avec au moins 20 impressions. Une anomalie de CTR commence sous 5 % de clics entre la 4e et la 7e place.
Deux constats avant de commencer. Sur 89 jours, 76 % des impressions de swanbase.co portaient une requête que Google ne montre pas. Le jeton OAuth de notre CLI a expiré trois fois en six mois, et le 12 octobre la commande de statut affichait encore « authenticated ». Voici nos commandes, nos seuils et nos réparations.
Pourquoi brancher Google Search Console à Claude Code ?
Pour choisir les pages à reprendre, vous devez croiser des milliers de lignes requête × page, comparer deux périodes et appliquer les mêmes seuils à chaque passage. Dans votre terminal, Claude lance l'export, exécute le script de tri et lit les fichiers de votre site avant de proposer une modification.
Les limites de l'interface Search Console
L'export de l'interface s'arrête à 1 000 lignes. L'API Search Analytics renvoie jusqu'à 25 000 lignes par requête et 50 000 lignes par jour, par site et par type de recherche, selon l'article de Google sur les filtres et limites des données de performance. Notre export du 26 septembre 2026 comptait 5 988 lignes requête × page pour 4 622 requêtes distinctes. Avec l'interface, vous en auriez vu un sixième.
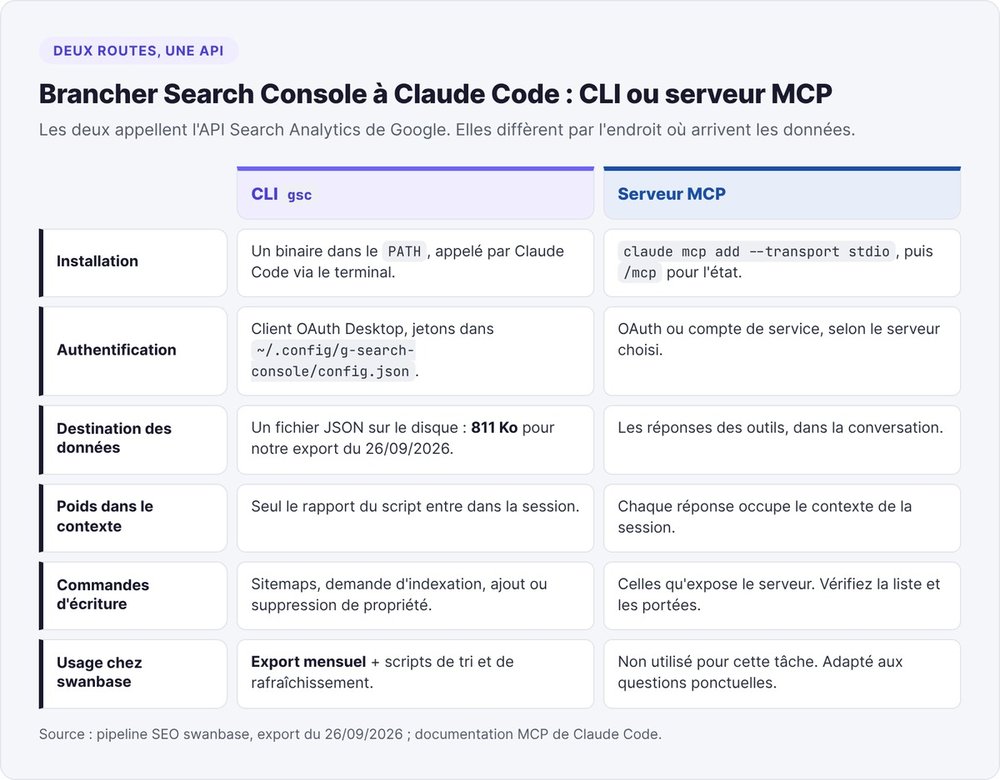
CLI ou serveur MCP : deux routes vers la même API
- Un serveur MCP expose l'API sous forme d'outils que Claude appelle pendant la conversation. Pratique pour une question ponctuelle (« quelles pages ont perdu des clics cette semaine »). Les réponses entrent dans le contexte de la session.
- Une CLI écrit l'export dans un fichier. Claude Code lance un script sur ce fichier et ne lit que le rapport. Notre export du 26/09 pèse 811 Ko de JSON : nous le gardons sur le disque, hors du contexte.
Nous utilisons la CLI gsc, un binaire Go qui couvre l'analyse, l'inspection d'URL, les sitemaps et l'API Indexing. Si vous découvrez le protocole, lisez d'abord notre guide Claude Code MCP.
Connecter Search Console à Claude Code en cinq étapes
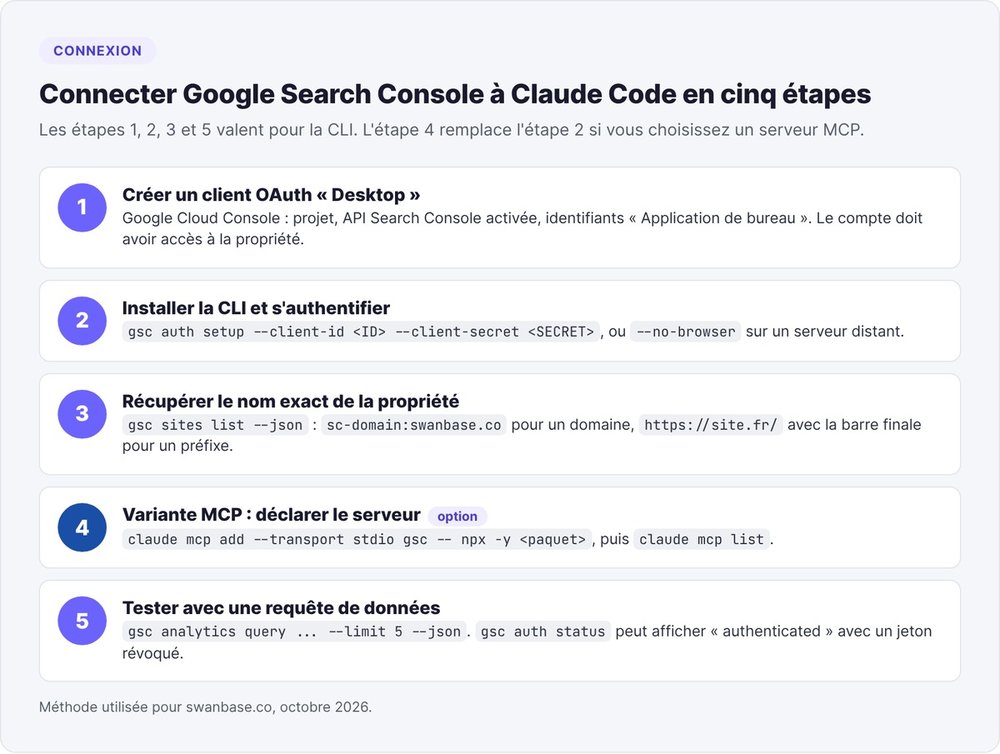
Les étapes 1, 2, 3 et 5 valent pour la CLI. L'étape 4 remplace l'étape 2 si vous préférez un serveur MCP.
Étape 1 : créer un client OAuth « Desktop » et activer l'API
Dans Google Cloud Console, créez un projet, activez « Google Search Console API », puis créez des identifiants OAuth de type « Application de bureau ». Vous récupérez un client_id et un client_secret. Le compte Google qui autorisera l'accès doit être propriétaire ou utilisateur de la propriété Search Console.
Étape 2 : installer la CLI gsc et lancer l'authentification
gsc auth setup --client-id <ID> --client-secret <SECRET>
# serveur distant sans navigateur :
gsc auth setup --credentials credentials.json --no-browser
Sous Linux, la CLI stocke les jetons dans ~/.config/g-search-console/config.json. Ce fichier contient votre refresh token : gardez-le hors de votre dépôt Git.
Étape 3 : récupérer le nom exact de la propriété
gsc sites list --json
Copiez la chaîne telle quelle. Une propriété de domaine s'écrit sc-domain:swanbase.co, une propriété préfixe d'URL https://swanbase.co/ avec la barre finale. Avec une chaîne approximative, vous obtenez une erreur de permission.
Étape 4 (variante MCP) : déclarer le serveur avec claude mcp add
Pour un serveur MCP communautaire, une commande suffit, selon la documentation MCP de Claude Code :
claude mcp add --transport stdio gsc \
  --env GOOGLE_APPLICATION_CREDENTIALS=/chemin/vers/cle.json \
  -- npx -y <paquet-du-serveur>
claude mcp list
Claude Code transmet au serveur tout ce qui suit --. Dans une session, /mcp affiche l'état de chaque serveur.
Étape 5 : tester avec une requête de données
gsc auth status ne suffit pas, la section suivante explique pourquoi.
gsc analytics query --site "sc-domain:swanbase.co" \
  --start 2026-09-01 --end 2026-09-07 --dimensions query --limit 5 --json
Si cinq lignes de requêtes reviennent, la connexion fonctionne.
Réparer un jeton OAuth expiré (invalid_grant)
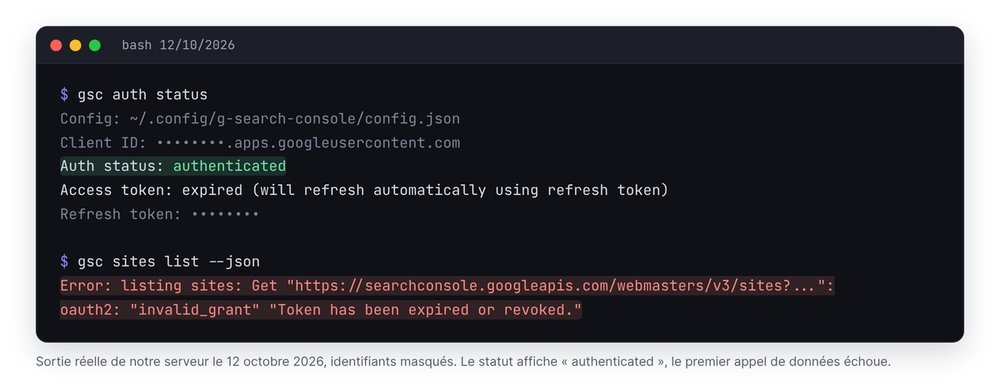
Nous avons vécu ce piège trois fois. Le 14 avril 2026, nous avons refait un rapport de suivi entier, produit avec un jeton expiré. Le 23 septembre, le dernier jeton datait du 5. Le 12 octobre, en préparant cet article, gsc sites list a renvoyé l'erreur pendant que la commande de statut affichait « authenticated ».
Le symptôme : « authenticated » au statut, invalid_grant à l'appel
$ gsc auth status
Auth status: authenticated
Access token: expired (will refresh automatically using refresh token)

$ gsc sites list --json
Error: listing sites: oauth2: "invalid_grant" "Token has been expired or revoked."
La commande de statut ne teste pas le refresh token auprès de Google. Vous apprenez la révocation au premier appel de données. Si votre agent ne vérifie que le statut, il vous rend un rapport vide ou périmé : c'est ce qui nous est arrivé en avril.
La réparation en deux appels, sans navigateur sur le serveur
gsc auth setup ouvre un navigateur ou attend un rappel sur localhost:8080, ce qui casse sur une machine distante. Nous passons par un petit script en deux appels :
python3 gsc_reconnect.py urlimprime une URL d'autorisation Google (access_type=offline,prompt=consent, redirectionhttp://localhost:8080, portéeswebmastersetindexing).- Vous ouvrez l'URL dans votre propre navigateur et autorisez le compte propriétaire. La page
localhostne charge pas, c'est normal : copiez l'URL complète de la barre d'adresse, qui contientcode=. python3 gsc_reconnect.py exchange "<URL collée>"échange ce code contre un nouveau jeton et réécritconfig.json, puis vous relancezgsc sites list.
Le cœur de l'échange :
data = urllib.parse.urlencode({
    "code": code, "client_id": cid, "client_secret": csec,
    "redirect_uri": "http://localhost:8080",
    "grant_type": "authorization_code",
}).encode()
tok = json.load(urllib.request.urlopen(
    urllib.request.Request("https://oauth2.googleapis.com/token", data=data)))
cfg["refresh_token"] = tok.get("refresh_token", cfg["refresh_token"])
Avec prompt=consent, Google renvoie un refresh token neuf. Sans ce paramètre, vous récupérez parfois un jeton d'accès seul, valable une heure.
Le correctif durable : sortir l'application du mode Test
Google accorde un refresh token valable 7 jours quand l'écran de consentement OAuth reste en mode « Testing » pour des utilisateurs externes, selon la documentation OAuth 2.0 de Google. Publiez l'application (Testing vers Production) dans Google Cloud Console : vos jetons durent alors jusqu'à révocation, et votre analyse mensuelle n'exige plus de réparation.
Exporter les données page × requête sur 90 jours
La commande d'export
SITE="sc-domain:swanbase.co"
END=$(date -d "2 days ago" +%F)     # Search Console publie avec ~2 jours de retard
START=$(date -d "92 days ago" +%F)
gsc analytics query --site "$SITE" --start "$START" --end "$END" \
  --dimensions query,page --limit 25000 --json > data/gsc-raw-$(date +%Y%m%d).json
gsc analytics query --site "$SITE" --start "$START" --end "$END" \
  --dimensions page --limit 25000 --json > data/gsc-raw-page-$(date +%Y%m%d).json
Le croisement requête × page vous dit quelle page Google montre pour quelle requête, à quelle position. Le deuxième export, par page seule, sert à mesurer les requêtes masquées. Pour comparer deux périodes, relancez la première commande sur les 90 jours précédents : notre suivi du 26/09 comparait le 26/06-24/09 au 27/03-25/06.
La forme du JSON et ses clés absentes
{"responseAggregationType": "byProperty",
 "rows": [{"clicks": 188, "ctr": 0.61, "impressions": 308,
           "keys": ["swanbase", "https://swanbase.co/"], "position": 1.22}]}
Les keys suivent l'ordre de --dimensions. Piège : les lignes sans clic n'ont ni clicks ni ctr. Dans notre export du 26/09, 5 853 lignes sur 5 988 n'avaient pas ces clés. Un script qui lit r["clicks"] plante au premier passage (nous l'avons fait le 12 octobre). Lisez toujours r.get("clicks", 0).
Dépasser la limite de lignes
--limit va de 1 à 25 000, avec 1 000 par défaut. Au-delà, paginez avec --start-row 25000, dans la limite de 50 000 lignes par jour. Notre export par page comptait 580 lignes : un site de quelques centaines de pages tient dans une seule requête.
Pourquoi vos totaux par requête ne collent pas
Additionnez les impressions de l'export requête × page et comparez au total du site : il en manque la majorité. Google retire de ses tableaux les requêtes « anonymisées » : des requêtes tapées par quelques dizaines d'utilisateurs au plus sur deux à trois mois. Il les compte pourtant dans les totaux.
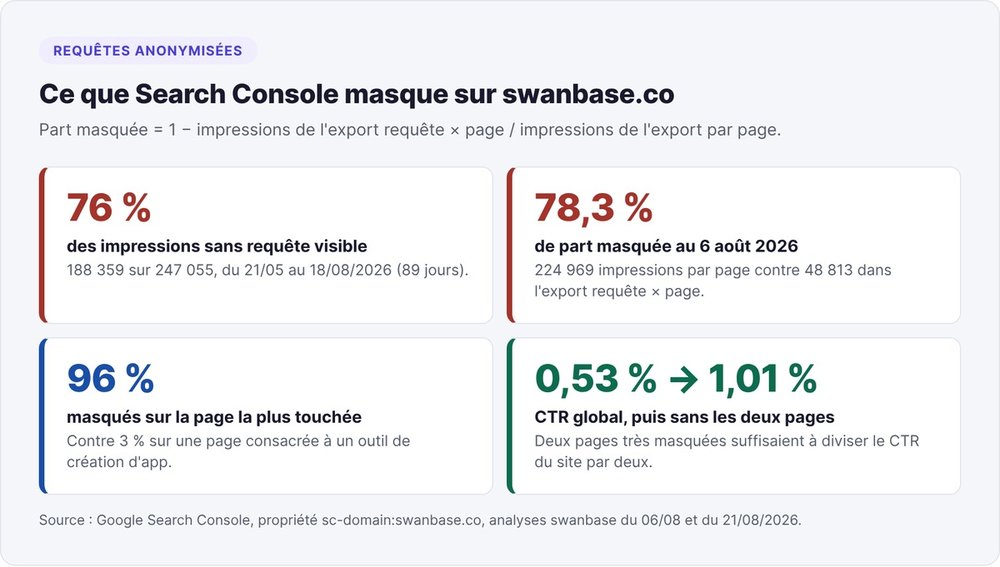
76 % des impressions sans requête visible
Sur swanbase.co, du 21 mai au 18 août 2026, 188 359 impressions sur 247 055 ne correspondaient à aucune requête visible, soit 76 %. Le 6 août, sur une autre fenêtre, la part masquée atteignait 78,3 %. Google masquait 96 % et 97 % des impressions de nos deux pages sur le BSA AIR, et 3 % seulement sur une page consacrée à un outil de création d'app.
Notre CTR global affichait 0,53 %, et 1,01 % sans ces deux pages. Avant de conclure qu'un titre ne fonctionne pas, regardez quelle part de la page vous voyez.
Mesurer votre part masquée
python3 - <<'EOF'
import json
tot = lambda f: sum(r.get("impressions", 0) for r in json.load(open(f))["rows"])
qp, p = tot("data/gsc-raw-20260926.json"), tot("data/gsc-raw-page-20260926.json")
print(f"requêtes visibles : {qp} / {p} impressions, masquées : {1 - qp / p:.0%}")
EOF
Refaites le calcul page par page. Sur notre page BSA AIR la plus touchée, 54 % des impressions nommées venaient de requêtes de 8 mots ou plus, pour 0 clic. Des formulations comme « bsa air investisseur pas actionnaire avant conversion » ressemblent à des sous-questions écrites par une machine. Nous l'avons noté comme hypothèse : la dimension searchAppearance de l'API ne renvoie que VIDEO pour notre propriété, donc l'API ne permet pas d'isoler les aperçus IA.
Ancres et variantes de slash dans les compteurs
Google compte comme des pages distinctes les liens vers une section (/blog/lovable/#faqs). Sur 89 jours, nous avions 461 lignes « page » pour 347 URLs réelles : 114 URLs à ancre, 17 071 impressions, 0 clic. Dans l'export du 26/09, 722 lignes requête × page portaient une ancre, et « trouver un cofondateur » remontait parmi les quick wins sur #comment-valuer-un-cofondateur-avant-d....
Excluez les URLs contenant # de tout calcul de CTR. Fusionnez aussi les variantes avec et sans barre finale : une de nos pages comptait 6 impressions, dont 5 sur l'URL sans slash.
Les six règles chiffrées pour trier vos requêtes Search Console
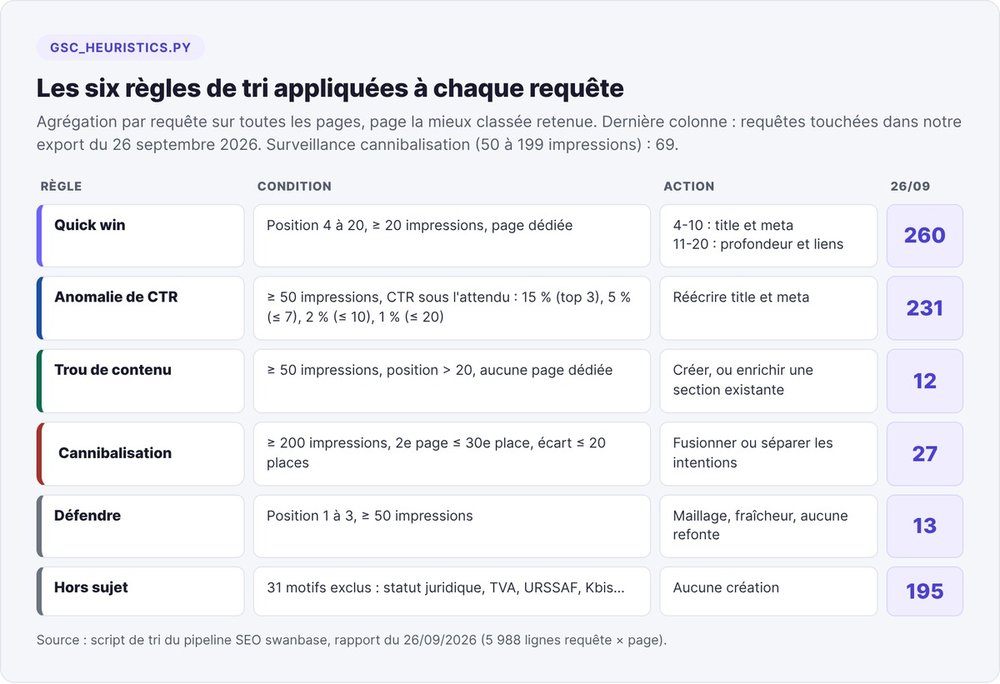
Notre script gsc_heuristics.py agrège l'export par requête, sur toutes les pages qui la portent, et garde la page la mieux classée. Nous appliquons ensuite six règles à chaque requête.
Quick win : position 4 à 20, au moins 20 impressions
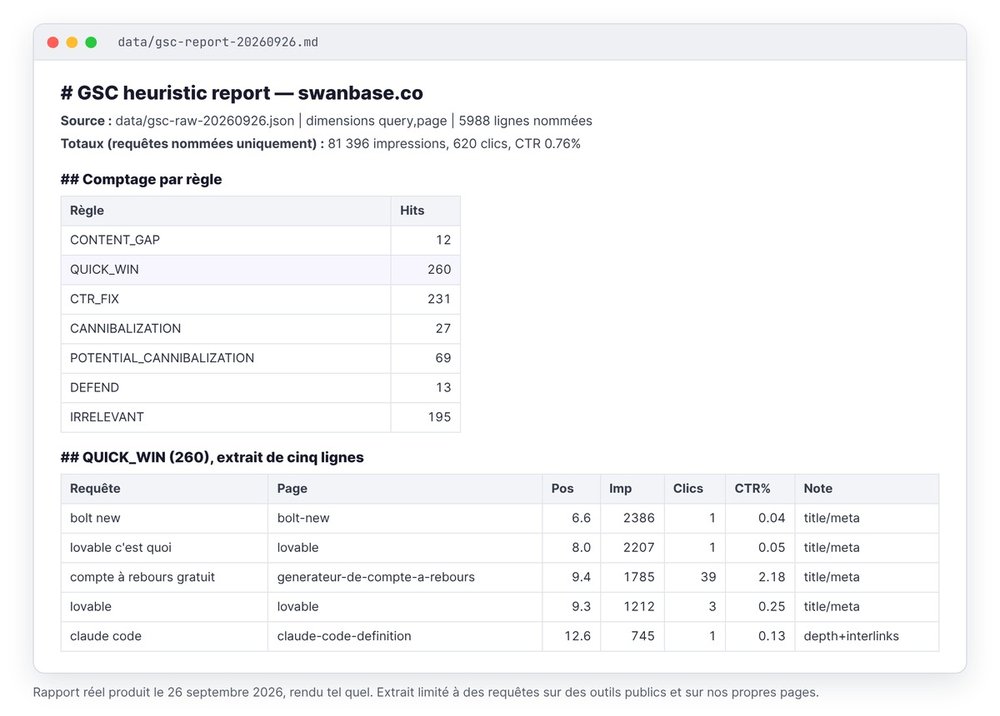
Une requête entre la position 4 et 20, avec au moins 20 impressions et une page dédiée, devient un quick win. Entre 4 et 10, vous retravaillez le title et la meta description. Entre 11 et 20, vous ajoutez de la profondeur et des liens internes. Le 26 septembre, 260 requêtes passaient ce filtre.
La notion de « page dédiée » repose sur une heuristique grossière : au moins la moitié des mots de la requête (plus de deux lettres) figurent dans le slug. Le même jour, « webstorm annuel prix » ressortait ainsi en trou de contenu, rattaché à notre article de définition de Claude Code.
Anomalie de CTR : le CTR attendu par tranche de position
EXPECTED_CTR = [(3, 0.15), (7, 0.05), (10, 0.02), (20, 0.01)] # au-delà : 0,5 %
Avec au moins 50 impressions, une requête sous le CTR attendu de sa tranche part en réécriture de title et de meta : 15 % jusqu'à la 3e place, 5 % jusqu'à la 7e, 2 % jusqu'à la 10e, 1 % jusqu'à la 20e. Le 26/09, nous en comptions 231.
Une incohérence nous a coûté une relecture : notre documentation écrivait 20 % pour le top 3, le script appliquait 15 %. Gardez une seule source pour les seuils, le code que vous exécutez.
Trou de contenu : 50 impressions au-delà de la position 20
Au moins 50 impressions, une position au-delà de 20 et aucune page dédiée : le sujet mérite peut-être un article. La priorité se calcule en impressions divisées par la position. Vérifiez d'abord qu'aucune section d'un article existant ne traite déjà le sujet : dans ce cas, vous enrichissez la page au lieu d'en créer une.
Cannibalisation : 200 impressions et deux pages proches
Deux pages se disputent une requête quand celle-ci totalise au moins 200 impressions, que la deuxième page se classe à la 30e place ou mieux et que l'écart entre les deux ne dépasse pas 20 places. Entre 50 et 199 impressions, avec une deuxième page dans le top 20, la requête passe en surveillance. Si toutes les pages sont au-delà de la 40e place, ignorez-la.
Écartez deux faux positifs à la main : les URLs à ancre, et les paires français/anglais. Sur notre site, les doublons FR/EN du rapport venaient de requêtes de marque tapées depuis plusieurs pays, avec des balises hreflang en place.
Défendre le top 3 et écarter le hors-sujet
Une requête en position 1 à 3 avec au moins 50 impressions passe en défense : maillage, fraîcheur, aucune refonte. La sixième règle exclut 31 motifs de toute création (statut juridique, TVA, URSSAF, Kbis, fiscalité). Le 26/09, 195 requêtes tombaient dans ce filtre, dont une série de « convertisseur tva » arrivée sur notre calculateur HT/TTC.
Lancer le tri et lire le rapport
python3 scripts/gsc_heuristics.py data/gsc-raw-20260926.json \
  --period-a data/gsc-raw-period-a-20260926.json \
  --out data/gsc-report-20260926.md --trend-out data/gsc-trend-20260926.md
Le rapport liste, règle par règle, les 40 requêtes les plus vues. Le fichier de tendance classe chaque couple requête × page à au moins 20 impressions : en hausse au-delà de 3 places gagnées, en baisse au-delà de 3 places perdues, perdu s'il avait 50 impressions sur la période précédente et a disparu. Le 26/09 : 56 en baisse, 33 en hausse, 210 stables, 317 nouveaux, 2 perdus.
Les prompts à donner à Claude Code
Sans consigne, un agent passe d'une position à un diagnostic du contenu en une phrase. Nous lui donnons deux prompts.
Le prompt d'export et de tri
Exporte Search Console pour sc-domain:swanbase.co sur les 90 derniers jours
(fin = aujourd'hui - 2 jours), dimensions query,page, puis la même fenêtre en
dimension page. Calcule la part d'impressions masquées. Lance
scripts/gsc_heuristics.py avec la période précédente en --period-a.
Exclus les URLs contenant # de tout calcul de CTR.
Rends-moi les 10 quick wins avec le plus d'impressions, sans rien modifier.
Le prompt de diagnostic page par page
Nous avons écrit ces consignes dans notre orchestrateur SEO après un rapport qui décrivait des intros et des FAQ jamais ouvertes :
Aucun verdict sur le contenu d'une page sans avoir lu le fichier en entier.
Les signaux GSC disent « cette page sous-performe », jamais « l'intro est narrative ».
Tague chaque reco [mesuré] ou [hypothèse à vérifier].
Zéro chiffre inventé : un chiffre vient de GSC, ou tu montres la formule.
Ajoutez une vérification en production avant de marquer une action « non faite » : curl -s https://votre-site/url/ | grep -E "title|canonical". Le 19 avril, notre file de réécriture marquait « non déployées » quatre réécritures déjà en ligne.
Choisir les pages à rafraîchir
Pour choisir la page à reprendre en premier, nous regroupons l'export par page et gardons, pour chacune, sa requête la plus vue.
Le score : impressions × distance au top 3
opportunite = impressions * max(0, position - 3)
score = opportunite * (1.3 if page_en_baisse else 1.0)
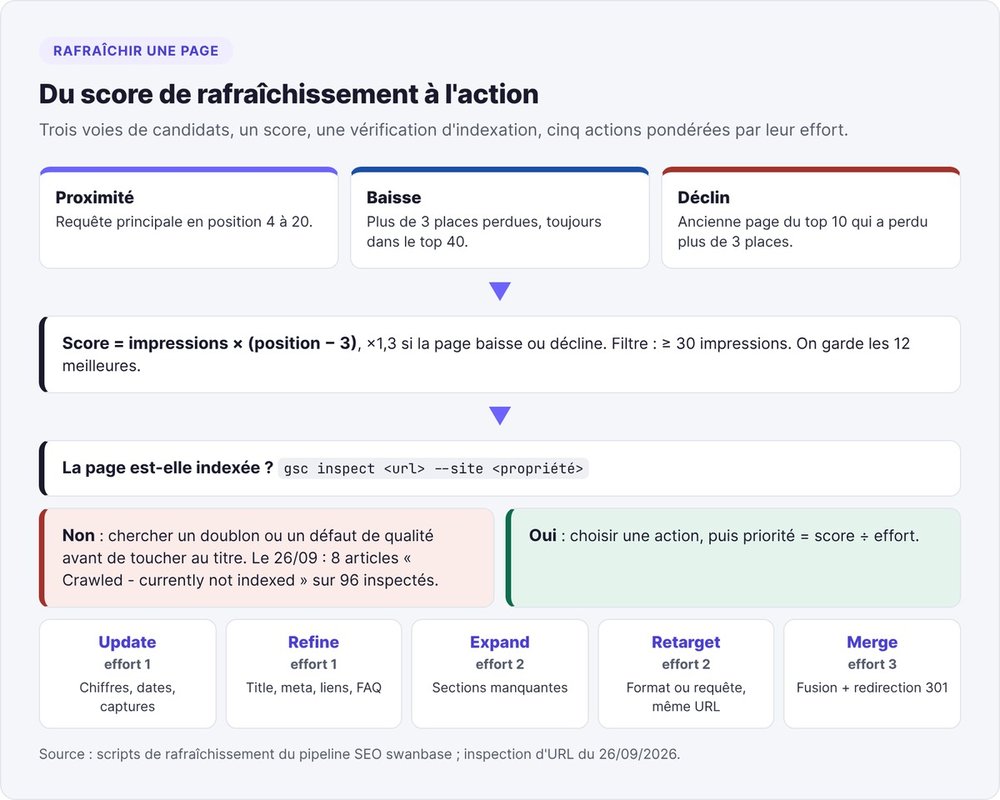
Trois voies alimentent la liste : la proximité (position 4 à 20), la baisse (plus de 3 places perdues, toujours dans le top 40) et le déclin (ancienne page du top 10 qui a perdu plus de 3 places). Nous écartons les pages sous 30 impressions et gardons les 12 meilleures :
python3 refresh_candidates.py --current data/gsc-raw-20260926.json \
  --baseline data/gsc-raw-period-a-20260926.json \
  --site https://swanbase.co --min-impressions 30 --top 12 --output-dir data/
Cinq actions, cinq coûts
Vous divisez le score par l'effort de l'action choisie pour obtenir la priorité finale :
- Update (effort 1) : chiffres, dates et captures périmés, sans toucher la structure.
- Refine (1) : title, meta, liens internes et FAQ, pour une page entre 4 et 10 au CTR faible.
- Expand (2) : sections manquantes face aux pages concurrentes.
- Retarget (2) : format ou requête à changer, en gardant l'URL.
- Merge (3) : deux pages sur une même intention, fusionnées avec une redirection 301.
Ne changez la date de mise à jour que pour Expand, Retarget ou un Update qui touche plusieurs sections. Pour les articles disputés, nous visons une reprise tous les 90 à 120 jours.
Vérifier l'indexation avant de réécrire
Une page absente de l'index ne remontera pas avec un meilleur titre. Le 26 septembre, nous avons passé gsc inspect sur nos 96 articles à moins de 100 impressions :
gsc inspect "https://swanbase.co/blog/<slug>/" --site "sc-domain:swanbase.co" --json
Résultat : 84 indexés, 8 « Crawled - currently not indexed », 1 « Discovered - currently not indexed », 3 inconnus de Google. Parmi les huit figurent notre panorama des outils IA pour startups et notre guide du growth marketing, qui reçoit pourtant 17 liens internes. Pour ces pages, nous cherchons un doublon ou un défaut de qualité avant de toucher au titre.
Résultats de la méthode sur swanbase.co
Trois résultats tirés de notre journal des gains :
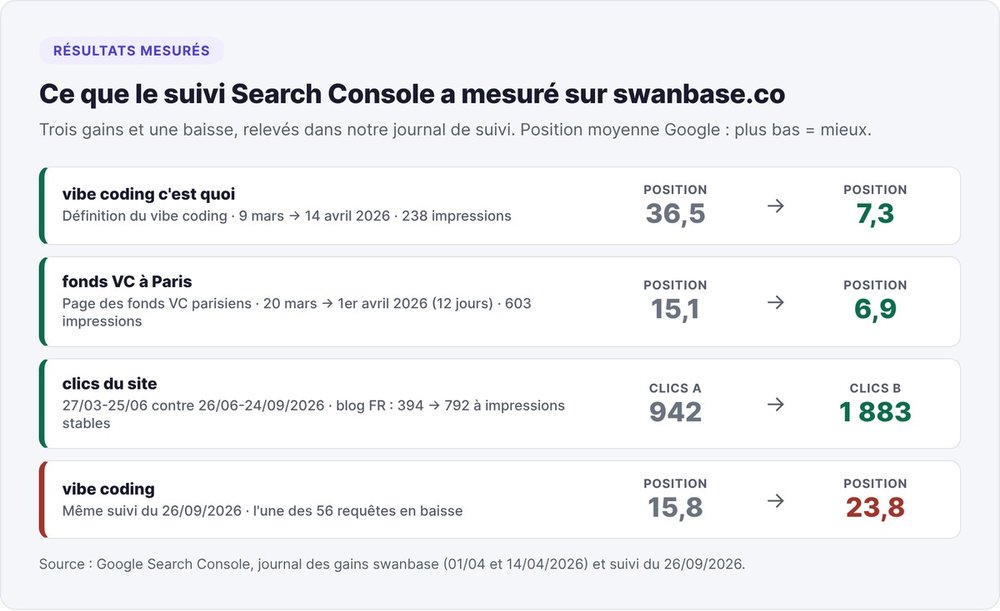
- Notre définition du vibe coding est passée de la position 36,5 à 7,3 sur « vibe coding c'est quoi » entre le 9 mars et le 14 avril 2026, sur 238 impressions.
- Notre page des fonds VC à Paris est passée de 15,1 à 6,9 entre le 20 mars et le 1er avril, en douze jours, sur 603 impressions.
- Entre deux périodes de trois mois (27/03-25/06 puis 26/06-24/09), les clics du site sont passés de 942 à 1 883. Sur le blog français, les impressions sont restées stables (157 019 puis 160 239) et les clics ont doublé (394 puis 792).
Le même suivi du 26/09 comptait 56 requêtes en baisse, dont « vibe coding » passé de 15,8 à 23,8. Aucune règle ne garantit une position. Avec des seuils écrits, vous savez chaque mois où regarder.
Pour transformer ces commandes en compétence réutilisable, lisez notre guide des skills Claude Code. Pour enchaîner plusieurs agents, voyez nos agents IA marketing. Si vous découvrez l'outil, commencez par notre définition de Claude Code.
FAQ
Existe-t-il un serveur MCP Search Console officiel ?
Les serveurs MCP Search Console répandus, comme mcp-gsc ou mcp-server-gsc, sont des projets communautaires. Ces serveurs appellent la même API Search Analytics que n'importe quelle CLI. Vérifiez le code et les portées OAuth demandées avant de leur confier votre compte.
Compte de service ou OAuth : lequel choisir ?
Nous utilisons un client OAuth de type Desktop lié au compte propriétaire de la propriété. Un compte de service évite l'expiration du jeton, à condition d'ajouter son adresse e-mail dans les utilisateurs de la propriété Search Console. Avec OAuth, publiez l'application pour sortir des jetons de 7 jours.
Combien de lignes peut-on exporter de Search Console ?
L'interface exporte 1 000 lignes. L'API renvoie 1 000 lignes par défaut, jusqu'à 25 000 par requête avec rowLimit, et 50 000 par jour, par site et par type de recherche, en paginant avec startRow. Ces limites viennent de Google Search Central (octobre 2022).
Pourquoi manque-t-il des impressions dans le total des requêtes ?
Google retire des tableaux les requêtes anonymisées, tapées par quelques dizaines d'utilisateurs au plus sur deux à trois mois, mais les compte dans les totaux. Sur swanbase.co, elles représentaient 76 % des impressions sur 89 jours en 2026. Mesurez votre part en comparant l'export par page à l'export requête × page.
Peut-on faire la même chose avec ChatGPT ?
Oui pour l'analyse : l'export est un fichier JSON et les règles tiennent dans un script Python, utilisables par tout assistant capable de lire un fichier ou de lancer une commande. Claude Code ajoute l'accès à votre terminal et aux fichiers de votre site, et vous pouvez lui faire lire une page avant de la juger.
Claude Code peut-il modifier ma Search Console ?
Oui si vous lui en donnez les moyens : la CLI gsc sait soumettre ou supprimer un sitemap, ajouter une propriété et demander une indexation. Pour une analyse seule, demandez uniquement la portée webmasters.readonly. Claude Code vous demande aussi une autorisation avant chaque nouvelle commande.
À quelle fréquence relancer l'analyse ?
Nous lançons le suivi une fois par mois, sur 90 jours glissants comparés aux 90 jours précédents. Search Console publie ses données avec environ deux jours de retard. Pour les pages reprises, nous prévoyons une nouvelle passe tous les 90 à 120 jours.