Pour faire une étude de marché avec Claude sans verbatims inventés, vous séparez quatre tâches. Des scripts collectent les messages publics par API (Reddit via l'archive Arctic Shift, Hacker News, Stack Exchange, forums Discourse, avis App Store). Claude lit chaque message et l'étiquette : pertinent ou non, qui parle, quelle douleur. Un script Python calcule ensuite tous les chiffres, et un dernier script retrouve chaque citation mot pour mot dans le corpus stocké avant de l'admettre dans le rapport.
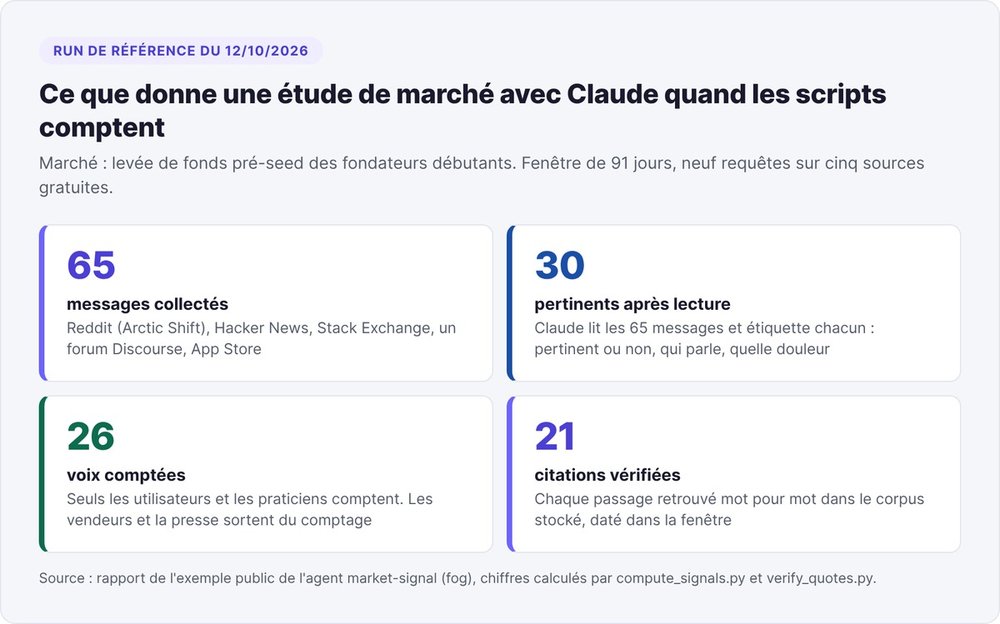
Le modèle ne tape jamais un chiffre et ne recopie jamais une citation. Nous l'appliquons dans l'agent open source market-signal de fog, sur des données publiques et sans clé API. Son run de référence du 12 octobre 2026, sur la levée de fonds pré-seed, a collecté 65 messages, en a gardé 30 après lecture et a vérifié 21 citations.
Étude de marché avec Claude : les limites d'un prompt seul
La plupart des guides proposent un prompt long qui demande au modèle le persona, les concurrents, les tendances et les avis clients. Le modèle répond vite, avec un ton assuré, et vous ignorez d'où viennent ses phrases.
La réponse type à « fais-moi une étude de marché »
Sans corpus, le modèle écrit des citations « représentatives » sans source, donne des pourcentages de sentiment sans comptage et cite des articles existants sans date : vous ne savez pas s'ils décrivent le marché de cette année ou celui d'il y a huit ans.
Avec la recherche web activée, le modèle lit des extraits et les reformule. Une citation reformulée ne va ni sur une landing page, ni dans une pub, ni dans un deck.
Notre run d'avril 2026 : une citation sur douze tenait
Le 28 avril 2026, nous avons lancé une première version de l'agent sur les accélérateurs en France. La synthèse reposait sur Exa et Firecrawl : 15 sources scrapées, puis un rapport rédigé par le modèle. Le rapport affichait un sentiment « estimé à partir du texte et du cadrage » : 27 % positif, 53 % négatif, 20 % mixte ou neutre. Personne n'avait compté.
Nous avons rejoué ses citations contre ses propres scrapes avec le script de vérification. Résultat : 11 blocages sur 12. Plusieurs citations venaient de textes de 2018 et 2020 alors que la fenêtre couvrait 90 jours. D'autres avaient perdu une majuscule, collé deux passages avec des points de suspension ou n'existaient dans aucune page. La ligne « Frustrations (their language) » du rapport ne correspondait à aucun texte collecté.
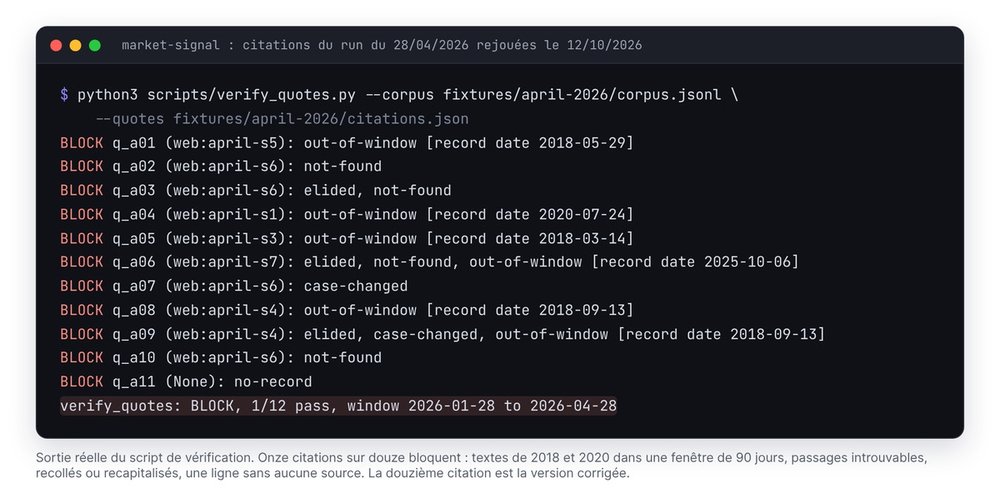
Ce run sert maintenant de test de régression : le script de vérification doit le bloquer à chaque nouvelle version de l'agent.
La méthode en six étapes
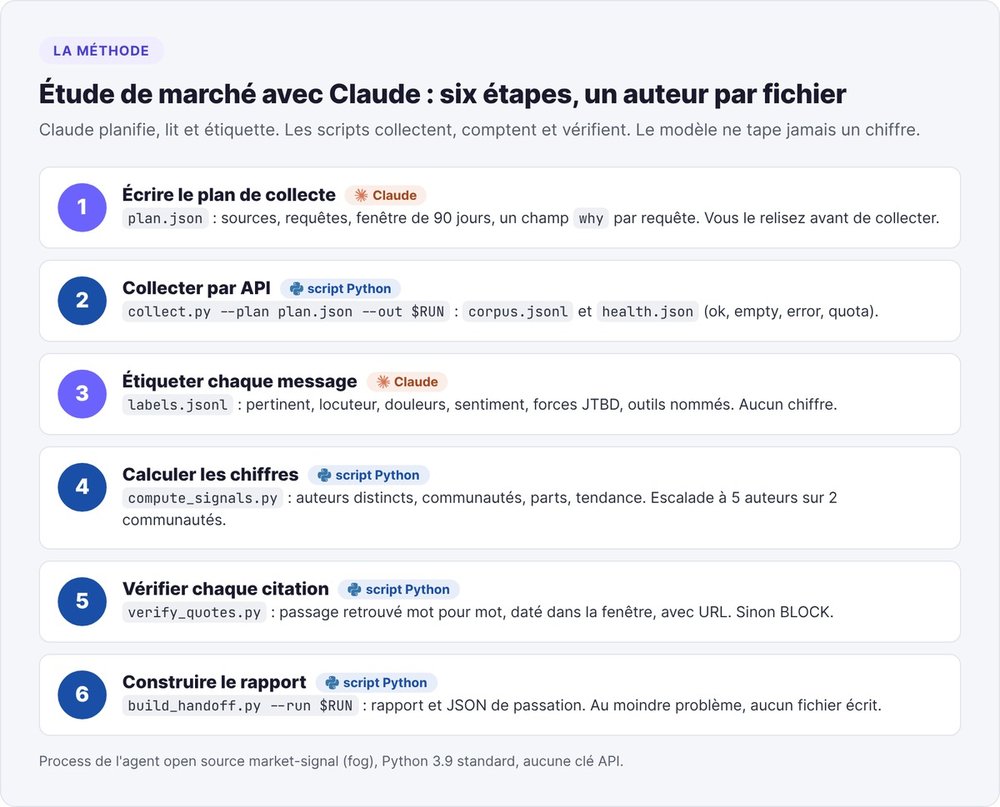
Chaque étape produit un fichier, et chaque fichier a un auteur unique : le modèle ou un script.
- Plan de collecte (
plan.json), écrit par Claude : les sources, les requêtes, la fenêtre, une raison par requête. - Collecte (
corpus.jsonl,health.json), par des scripts Python qui appellent des API publiques. - Étiquetage (
labels.jsonl), par Claude, qui lit chaque message. - Comptage (
stats.json), parcompute_signals.py. - Vérification des citations (
quotes-check.json), parverify_quotes.py. - Rapport et fichier de passation (
.mdet.json), parbuild_handoff.py.
Les scripts n'utilisent que la bibliothèque standard de Python 3.9 : rien à installer, aucune clé API, aucun appel payant. Avant votre premier run, lancez le test hors ligne depuis le dossier de l'agent :
cd agents/market-signal
python3 scripts/selftest.py
# selftest: 50/50 checks pass  (7,9 secondes sur notre serveur le 12/10/2026)
Étape 1 : écrire le plan de collecte
Vous donnez à Claude le marché en une phrase, la langue et la zone, Claude écrit le plan, et vous le relisez avant toute collecte : une requête mal visée vous coûte une vague entière.
Viser les forums d'entraide de votre client
Cherchez les endroits où votre persona pose des questions, en plus de la communauté de votre catégorie : pour un SaaS de facturation destiné aux freelances, le subreddit des freelances compte davantage que celui des logiciels de facturation.
Couvrez quatre familles de requêtes : les mots de la douleur, le changement d'outil (« switched », « alternative », « instead of »), l'hésitation (« I tried but », « what stopped me ») et les avis sur les outils concurrents.
Une ligne par source et par requête
Une ligne réelle du plan du 12 octobre 2026 :
{
  "id": "reddit-startups-warm-intro",
  "source": "reddit",
  "why": "access to investors through introductions",
  "args": {"subreddit": "startups", "query": "warm intro", "kind": "comments"},
  "limit": 12
}
Le champ why oblige Claude à justifier chaque requête. Les mots de la requête ne comptent jamais comme langage du marché : compute_signals.py les retire de la banque d'expressions, sinon vous retrouveriez vos propres mots-clés dans le rapport.
Fenêtre de 90 jours et plafonds
La fenêtre par défaut couvre 90 jours, et vous ne gardez que des citations datées dedans. Trois profondeurs fixent les plafonds par requête : quick (10 messages, 2 pages), standard (25 messages, 3 pages), deep (50 messages, 5 pages). Un collecteur plafonné garde les messages les plus récents. Le rapport affiche alors le volume comme minimum (lower_bound) et la tendance comme inconnue.
Étape 2 : collecter par API, sans scraper
Lancez la collecte en une commande : un process par requête, les sources en parallèle, les requêtes d'une même source à la suite.
python3 scripts/collect.py --plan $RUN/plan.json --out $RUN
Les cinq sources gratuites
| Source | Accès | Limite à connaître |
|---|---|---|
| archive Arctic Shift | quelques heures à quelques jours de retard, textes supprimés absents | |
| Hacker News | API Algolia | pas de score public sur les commentaires |
| Stack Exchange | API officielle | 300 requêtes par jour et par IP, plusieurs sites fermés |
| Forums Discourse | /search.json du forum |
recherche par mots, beaucoup de bruit |
| App Store | flux RSS des avis | pas de filtre de date, 10 pages de 50 avis au plus |
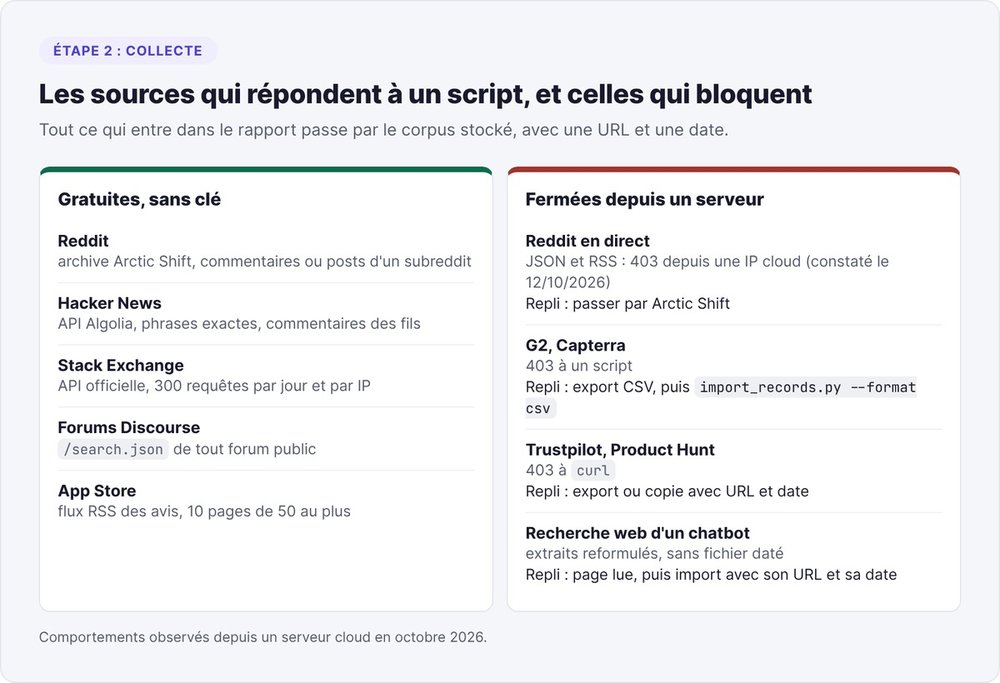
Reddit passe par l'archive publique Arctic Shift, Hacker News par l'API de recherche Algolia. Pour les avis G2 ou Capterra, vous exportez vous-même un CSV (url,date,text au minimum) et vous l'importez :
python3 scripts/import_records.py --input g2-export.csv --format csv --source g2
Les sources bloquées depuis un serveur
Reddit répond 403 aux adresses IP de cloud et de datacenter, en JSON comme en RSS. Nous l'avons encore constaté le 12 octobre 2026 depuis notre serveur. G2, Capterra, Trustpilot et Product Hunt répondent aussi 403 à un curl. Sur un serveur distant, un agent mal conçu vous rend alors un rapport plus maigre sans rien signaler.
Deux autres pièges reviennent. Arctic Shift répond « Timeout. Maybe slow down a bit » aux requêtes lourdes sur les gros subreddits : gardez une requête par job et de petits plafonds. Le site startups de Stack Exchange n'existe plus et renvoie une erreur 400.
Lire l'état de chaque source avant de lire un avis
Le collecteur écrit un état par requête dans health.json : ok, empty, error ou quota. Ouvrez ce fichier avant le corpus.
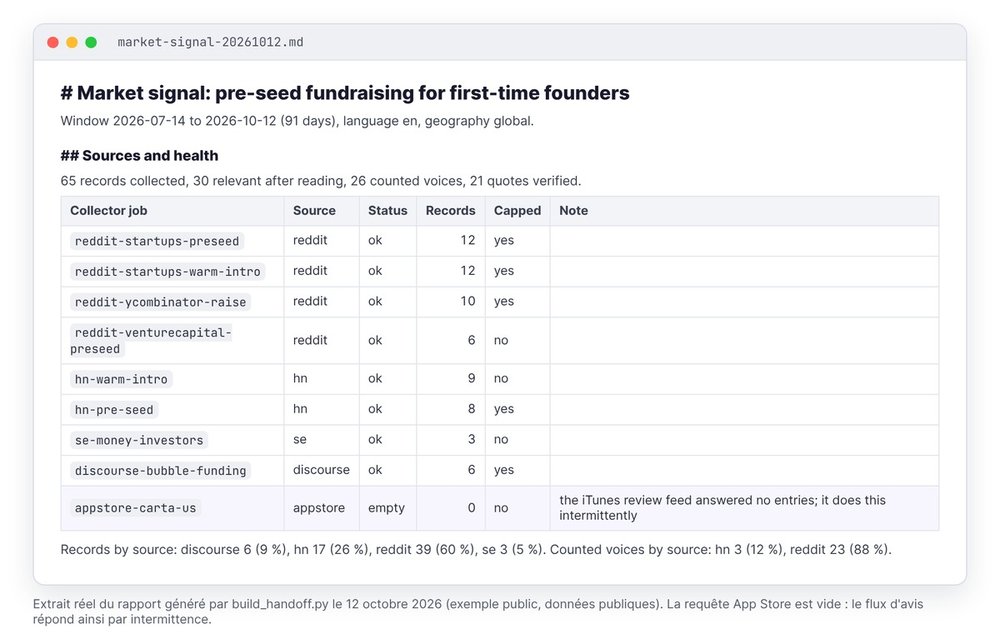
Traitez un statut empty comme une alerte : une source vide ne prouve pas le silence du marché. Changez les mots ou la communauté une fois, puis notez la source dans sources-rejected.md avec la date et la raison si elle reste vide. Le 12 octobre, le flux d'avis App Store a répondu vide, comme il le fait par intermittence. Arrêtez-vous après deux vagues de collecte et listez ce qui manque dans les limites du rapport.
Étape 3 : faire étiqueter chaque enregistrement par Claude
Un corpus de quelques centaines de messages tient dans le contexte de Claude : il lit tout avant de nommer la moindre douleur, puis étiquette chaque message.
Le codebook des douleurs
Claude écrit d'abord la liste des douleurs dans analysis.json, chacune avec un identifiant stable (pain_investor_access), une phrase sans chiffre, une force JTBD (push, pull, anxiety, habit) et un stade de conscience. Séparez deux douleurs quand les gens agiraient différemment face à chacune. Fusionnez-les quand les mêmes personnes disent les deux dans la même phrase.
Le prompt d'étiquetage
La consigne d'étiquetage tient en quelques règles, reprises du skill de l'agent :
Lis chaque enregistrement de corpus.jsonl, puis écris une ligne par
enregistrement dans labels.jsonl :
- relevant : true seulement si le message parle du marché étudié.
- speaker : user (parle de sa propre situation), practitioner (conseil
  de quelqu'un qui l'a fait), vendor (vend son produit), press, other.
- pains : seulement les douleurs que le message exprime (une simple
  mention ne compte pas).
- sentiment, forces, awareness, competitors (outils et statu quo nommés,
  toujours écrits pareil).
N'écris aucun compte, aucune part, aucune tendance.
Une étiquette réelle du 12 octobre (identifiant masqué) : {"record_id": "hn:…", "relevant": true, "speaker": "vendor", "note": "tool launch: warm intro investor map"}. Ce message est pertinent, mais son auteur présente son propre outil : il ne compte pas comme voix. Seuls user et practitioner comptent.
Les faux positifs à exclure
Sur une étude de septembre 2026 consacrée à la levée de fonds, nous avons codé 655 messages : 432 pertinents, 216 hors sujet, 7 doublons. Les hors-sujet venaient de collisions : « VC » au sens de voice chat, « series » au sens de série télé, des fils de jeux vidéo. Le 12 octobre, les six messages d'un forum no-code remontés par « funding » ne parlaient pas de levée de fonds : Claude les a tous marqués non pertinents.
N'éditez jamais corpus.jsonl à la main : un message faux sort par son étiquette relevant: false, et votre choix reste tracé.
Étape 4 : faire calculer les chiffres par un script
Claude n'écrit aucun nombre. Vous lancez :
python3 scripts/compute_signals.py --corpus $RUN/corpus.jsonl \
  --labels $RUN/labels.jsonl --analysis $RUN/analysis.json --out $RUN/stats.json
Vous obtenez, pour chaque douleur, les auteurs distincts, les communautés, la part par source, les dates extrêmes, la tendance et l'escalade.
Le seuil : 5 auteurs sur 2 communautés
Une douleur entre dans les conclusions à partir de 5 auteurs distincts sur au moins 2 communautés, et un auteur qui poste cinq fois compte une fois. Si vous changez le seuil (--min-authors, --min-communities), gardez la même valeur d'un run à l'autre.
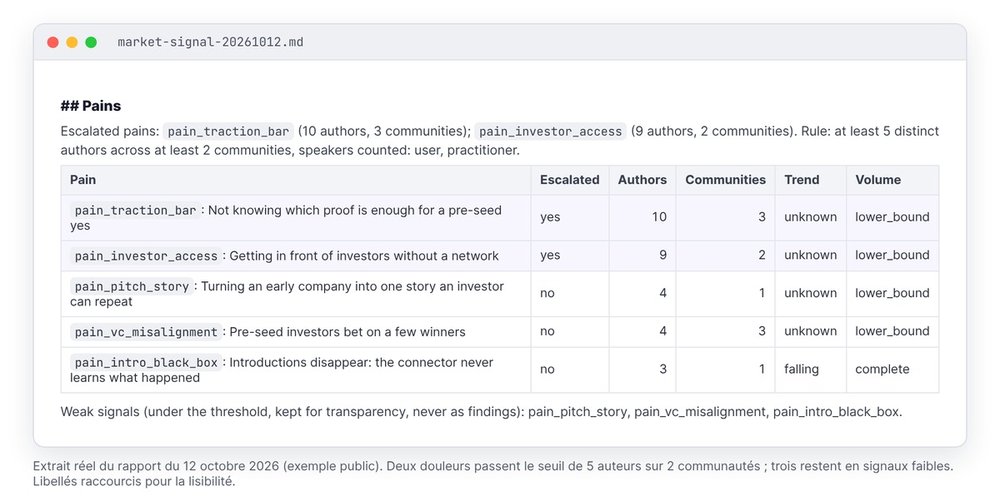
Sur le run du 12 octobre, deux douleurs passent le seuil : ne pas savoir quelle traction suffit pour un pré-seed (10 auteurs, 3 communautés) et accéder aux investisseurs sans réseau (9 auteurs, 2 communautés). Trois autres restent en signaux faibles, à 4, 4 et 3 auteurs, affichés à part. Le rapport liste aussi une douleur rejetée : les « warm intros » pour trouver des clients ou recruter, mêmes mots, autre marché.
Volumes plafonnés et tendances inconnues
Un collecteur plafonné a gardé les messages récents et laissé les anciens : comparer les deux moitiés de la fenêtre fausserait la tendance, d'où le unknown. Le 12 octobre, cinq des neuf requêtes ont atteint leur plafond, volontairement, pour garder un exemple léger. Pour des volumes, passez en deep.
Regardez aussi la répartition par source. Le 12 octobre, Reddit pesait 60 % des messages et 88 % des voix comptées : une douleur portée par une seule famille de sources mérite une seconde vague ailleurs avant que vous ne la croyiez.
Étape 5 : vérifier chaque citation mot pour mot
Claude choisit les citations, et un script retrouve chacune d'elles dans le corpus.
Citer par identifiant et passage
Une citation s'écrit avec l'identifiant du message (masqué ici) et un passage copié tel quel :
{
  "quote_id": "q_no_interviews",
  "record_id": "reddit:t1_…",
  "passage": "My start-up has a real product with real revenue and I am having trouble even getting VC interviews.",
  "pain_id": "pain_investor_access",
  "usable_as": ["headline", "hook"]
}
Le passage garde la casse, la ponctuation et les fautes de l'original. Pas de points de suspension, pas de [...] : un long message devient plusieurs citations. Les citations restent dans leur langue d'origine, et vous traduisez au moment de l'usage.
python3 scripts/verify_quotes.py --corpus $RUN/corpus.jsonl --quotes $RUN/analysis.json
Les dix motifs de blocage
Le script tolère trois différences : les espaces, les guillemets droits ou courbes, la composition Unicode. Tout le reste bloque :
no-recordetrecord-not-in-corpus: la citation n'a pas de source dans le corpus.not-found: le passage n'existe pas dans le message.case-changed: le passage existe seulement si l'on ignore les majuscules.elided: le passage colle deux morceaux avec des points de suspension.out-of-windowetno-date: le message sort de la fenêtre ou n'a pas de date.no-url,removed,metadata-mismatch: pas d'URL, texte supprimé, ou URL et date différentes de celles du message.
Corrigez un blocage avec un autre passage ou un autre message, jamais en modifiant le corpus, et retirez la citation après trois tours sans succès. Vous pouvez citer un vendeur ou un journaliste en le présentant comme tel, jamais comme la parole de votre client.
Étape 6 : livrer un rapport sans retouche à la main
python3 scripts/build_handoff.py --run $RUN
Le script valide les fichiers, recalcule stats.json, revérifie les citations et cherche les chiffres nus dans la prose de Claude. Au moindre problème, il affiche chaque raison et n'écrit aucun fichier : corrigez analysis.json ou labels.jsonl, puis relancez.
Le rapport contient l'état des sources, les douleurs avec leurs comptes, les citations vérifiées avec date et lien, les objections, un persona décrit par un titre (jamais une personne inventée) et des recommandations, chacune avec l'observation qui la contredirait. Vos agents de copywriting lisent ensuite le fichier JSON de passation. Pour transformer ces douleurs en positionnement, notre guide du product market fit détaille la suite, et celui sur les 10 premiers clients montre comment les contacter.
En mode veille, vous relancez le même plan à intervalle régulier : diff_runs.py liste les douleurs nouvelles, en hausse, en baisse ou disparues depuis le run précédent.
Faire une étude de marché avec ChatGPT : les règles à garder
Vous pouvez faire une étude de marché avec ChatGPT si vous lui fournissez le corpus et lui retirez les chiffres. Dans le navigateur, ChatGPT n'exécute pas vos scripts locaux : vous collectez et vérifiez à part, et vous lui confiez la lecture.
Un prompt d'étude de marché pour ChatGPT
Collez vos messages avec un identifiant, une date et une URL par ligne, puis donnez cette consigne :
Voici N messages publics, un par ligne : [id] date url texte.
1. Classe chaque message : pertinent ou non pour [marché], et qui parle
   (utilisateur, praticien, vendeur, presse).
2. Liste les douleurs exprimées, chacune avec les id des messages.
3. Pour chaque douleur, donne au plus trois citations au format
   [id] "passage copié sans aucune modification".
N'écris aucun pourcentage et aucun total. Ne reformule aucune citation.
Ensuite, comptez les auteurs distincts par douleur dans un tableur et cherchez chaque passage dans vos fichiers avec Ctrl+F. Nous avons confié ce contrôle, long à la main, à un script.
ChatGPT, Claude.ai ou Claude Code
ChatGPT et Claude.ai suffisent pour étiqueter un corpus que vous avez déjà. Claude Code, Codex CLI, Cursor ou Gemini CLI lancent en plus les collecteurs et la vérification dans la même session : l'agent market-signal tourne sur les quatre. La recherche web d'un chatbot ne vous laisse aucun fichier daté à vérifier.
Créer un skill Claude d'étude de marché
Un skill Claude Code est un dossier qui contient un fichier SKILL.md : un en-tête YAML qui dit à Claude quand l'utiliser, puis les instructions. Vous le placez dans .claude/skills/<nom>/ pour un projet ou dans ~/.claude/skills/<nom>/ pour tous vos projets, et vous l'appelez avec /nom. La documentation officielle des skills Claude Code détaille les options, et notre guide des Claude Code skills montre comment les organiser.
L'agent market-signal découpe son travail en quatre skills, un par étape où le modèle intervient :
skills/
  scanning-market-signals/SKILL.md          # plan + collecte (étapes 1 et 2)
  coding-the-corpus/SKILL.md                # codebook + étiquettes + comptage
  extracting-psychographic-profile/SKILL.md # citations, persona, angles
  watching-the-market/SKILL.md              # mode veille
L'en-tête du skill d'étiquetage ressemble à ceci :
---
name: coding-the-corpus
description: Reads every record of the market-signal corpus and labels it,
  so scripts can count. [...] The model never writes a count.
allowed-tools: Read Write Bash
---
Gardez cette répartition dans vos skills : les instructions disent à Claude quoi lire et quel fichier écrire, et chaque nombre sort d'une commande.
Les pièges relevés sur nos dix études
Entre mars et septembre 2026, nous avons mené dix études avec un agent plus ancien : le modèle comptait les mentions et choisissait 15 à 20 citations par flux à partir de recherches Exa. Leurs erreurs ont donné la méthode ci-dessus.
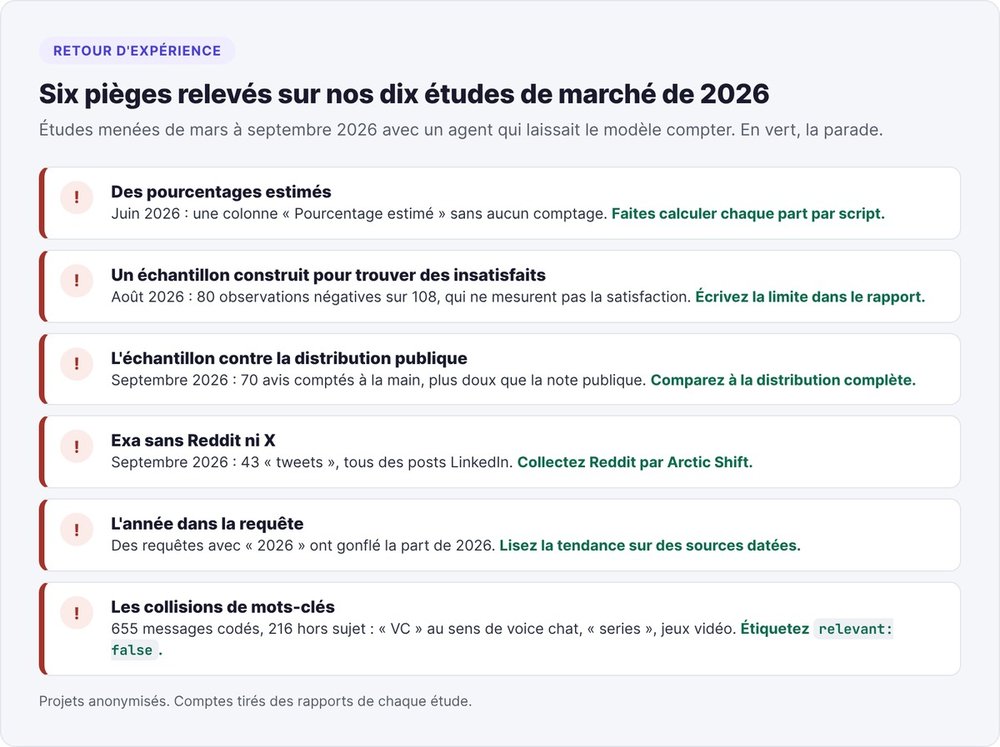
- Des pourcentages estimés. En juin 2026, l'étude d'une marque de boisson fonctionnelle titrait sa colonne de sentiment « Pourcentage estimé », sans aucun comptage derrière.
- Un échantillon construit pour trouver des insatisfaits. En août, une étude sur des outils d'agents IA comptait 80 observations négatives sur 108. Ce corpus ne mesurait pas la satisfaction des clients : écrivez cette limite dans chaque rapport.
- L'échantillon contre la distribution publique. Pour un e-shop alimentaire, en septembre, les comptes faits à la main sur 70 avis donnaient une image plus douce que la distribution publique des notes sur Trustpilot. Comparez toujours votre échantillon à la distribution complète quand elle existe.
- Exa sans Reddit ni X en septembre 2026. À cette date, Exa n'indexait plus Reddit et avait supprimé sa catégorie tweet : les 43 « tweets » d'une étude étaient tous des posts LinkedIn.
- L'année dans la requête. Des requêtes contenant « 2026 » ont gonflé la part des messages de 2026 et faussé la tendance. Lisez les tendances sur Reddit et Hacker News, qui datent chaque message.
- Les collisions de mots-clés. « VC », « series » ou « funding » remontent du bruit hors marché : prévoyez l'étiquette
relevant: falsedès le premier passage.
Un dernier réflexe vaut pour toutes les études : quinze bonnes citations valent mieux que trente faibles.
Le code de l'agent market-signal est open source et se télécharge depuis fog-agents.com. Notre article sur fog et ses agents IA marketing présente le reste du stack.
FAQ
Quelle est la meilleure IA pour faire une étude de marché ?
Choisissez un outil capable de lancer des scripts et de lire des fichiers : Claude Code, Codex CLI, Cursor ou Gemini CLI. Vous y collectez les messages par API, les faites étiqueter, puis lancez les scripts de comptage et de vérification. Un chatbot seul sert à étiqueter un corpus fourni, jamais à produire les chiffres.
Le prompt Claude est-il efficace pour réaliser des études de marché ?
Un prompt seul produit des citations et des pourcentages invérifiables. Sur notre run d'avril 2026, construit sur une synthèse du modèle, 1 citation sur 12 a passé la vérification mot pour mot. Le prompt devient efficace quand il porte sur un corpus stocké, avec des citations par identifiant et des chiffres calculés par script.
Peut-on faire une étude de marché gratuite avec l'IA ?
Oui. Les collecteurs de l'agent market-signal utilisent des API publiques sans clé (Hacker News Algolia, Arctic Shift, Stack Exchange, Discourse, flux App Store) et les scripts tournent en Python standard. Vous payez seulement l'abonnement de l'outil IA qui lit le corpus.
Peut-on citer des messages Reddit dans une étude de marché ?
Oui, s'ils sont publics, datés et cités mot pour mot. Gardez le passage dans sa langue d'origine, ne l'attribuez jamais à une personne ou à une entreprise, et ne le présentez pas comme un témoignage sur votre produit. Dans un document public, retirez le pseudo et le lien vers le fil.
Quels sont les 3 types d'études de marché ?
On distingue l'étude documentaire (données existantes : rapports, statistiques, articles), l'étude qualitative (entretiens, discussions, verbatims) et l'étude quantitative (questionnaires et comptages sur un échantillon). La méthode de ce tuto relève du qualitatif. Elle compte des auteurs distincts et ne mesure pas la taille d'un marché.
Combien de messages faut-il pour une étude de marché fiable ?
Comptez en auteurs distincts plutôt qu'en messages. Une douleur entre dans nos conclusions à partir de 5 auteurs sur 2 communautés. Le 12 octobre 2026, 65 messages collectés sur 91 jours ont suffi pour faire ressortir deux douleurs.