Bienvenue sur swanbase, vous trouverez ici le fonctionnement de Jev, son prix et les erreurs à éviter.
Mis à jour le 21 septembre 2026 à 12 h 27, depuis Paris. Jev AI reçoit un état, évalue des questions fermées et renvoie des décisions typées avec des probabilités. Jev ne rédige pas de texte : il classe, score, route ou bloque une action dans un logiciel.
Jev complète un LLM génératif plus qu'il ne le remplace. Vous pouvez lui confier la décision « quel traitement lancer ? », puis laisser un modèle comme Claude ou GPT produire le contenu. Son principal risque est clair : une réponse conforme au type demandé peut rester fausse.
Jev AI, c'est quoi ?
TypeSafe AI a présenté Jev le 15 septembre 2026 comme son premier modèle « System One », disponible en early access. La société l'a entraîné pour répondre à des questions structurées, avec une méthode qu'elle nomme Reinforcement Learning for Calibrated Decisions, ou RLCD. Le billet de lancement de TypeSafe AI détaille cette approche et attribue à Jev ses premiers résultats de vitesse et de coût.
Un moteur de décision, pas un chatbot
Un chatbot transforme une entrée en chaîne de caractères. Jev transforme un état en valeurs que votre code connaît à l'avance. Vous ne lui demandez pas « réponds à ce client ». Vous lui demandez si le message est urgent, à quelle équipe il appartient et quel niveau de risque il présente.
Cette différence retire une étape fragile du pipeline. Avec un LLM classique, votre application demande souvent du JSON, récupère du texte, tente de le parser puis vérifie les champs. Avec Jev, la question fixe la forme de la réponse. Le résultat entre directement dans un if, un routeur ou une file de revue.
Le type ne garantit pas la justesse. Il garantit seulement que votre programme reçoit la forme attendue.
Le modèle System One selon TypeSafe
Le nom fait référence au système rapide et intuitif décrit par Daniel Kahneman. TypeSafe réserve Jev aux jugements courts : reconnaître une intention, choisir une catégorie, estimer un niveau ou décider si une condition s'applique. Décomposez une question qui exige plusieurs étapes, ou confiez-la à un autre modèle.
Jev reçoit un state, sous forme de texte ou de données structurées, puis plusieurs questions. Chaque question lit le même état ; TypeSafe les traite séparément et en parallèle.
Jev est un modèle de décision typée : il lit un contexte et renvoie des choix, des scores ou des probabilités exploitables par le code, sans générer de prose.
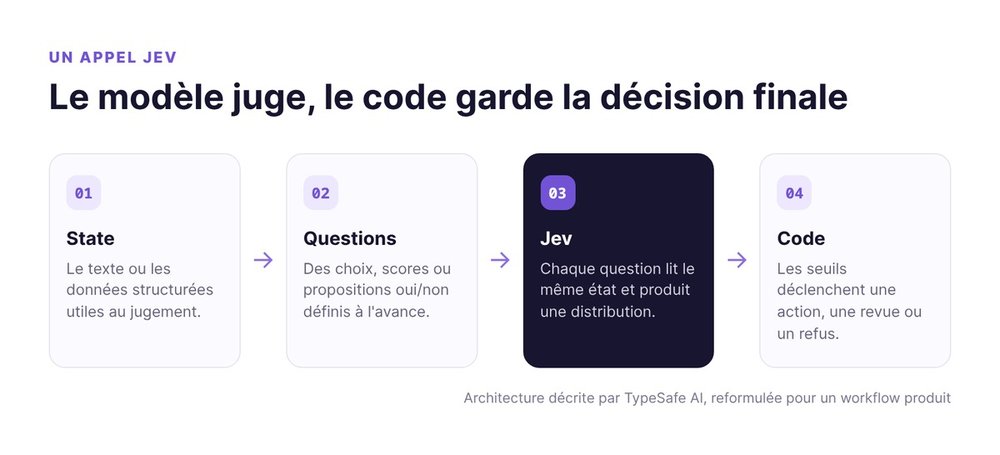
Comment Jev transforme un état en décision typée
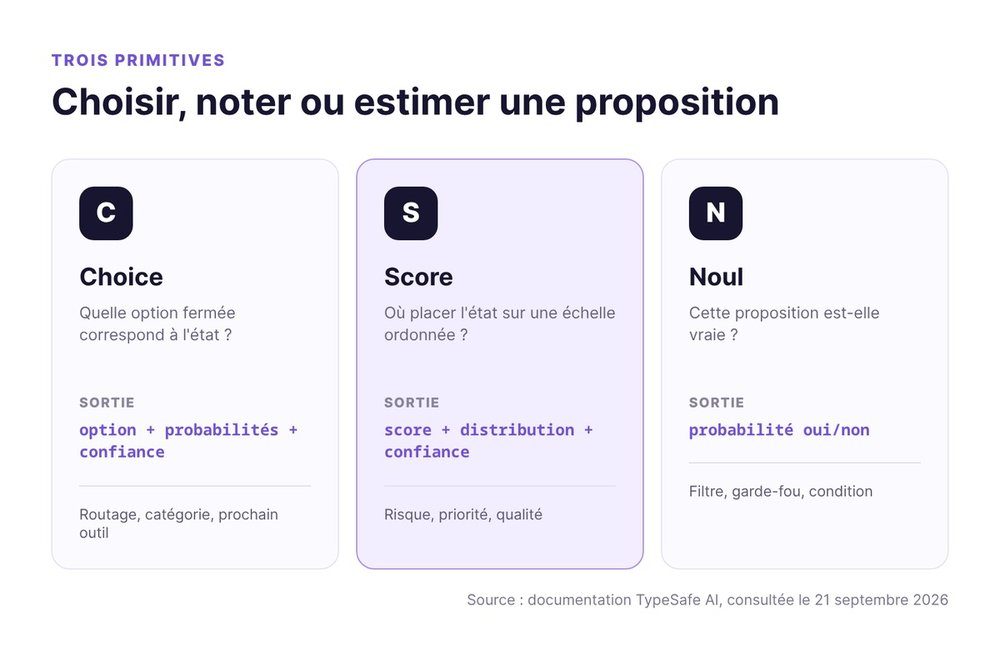
L'API Jev expose trois primitives. Le bon type dépend de ce que votre logiciel doit faire après la réponse.
Choice choisit dans une liste fermée
choice convient lorsque les sorties autorisées sont connues : billing, support, sales ou spam, par exemple. Jev renvoie l'option gagnante, la probabilité de chaque option et un score de confiance lié à la dispersion de ces probabilités.
Utilisez-le pour router un ticket, sélectionner un modèle ou choisir le prochain outil d'un agent. Ajoutez une option « autre » quand la taxonomie ne couvre pas tout. Sinon, vous forcez le modèle à choisir une mauvaise réponse.
Score place une entrée sur une échelle
score sert aux niveaux ordonnés : risque faible, moyen ou élevé ; lead peu qualifié ou prioritaire ; réponse hors sujet ou solide. Le résultat comprend un score, la distribution sur les niveaux et une confiance.
Décrivez des situations observables. « Bon, moyen, mauvais » donne peu de prise au modèle ; « le besoin et l'échéance sont explicites » fournit un critère vérifiable.
Noul estime une probabilité oui ou non
noul répond à une proposition binaire. Il renvoie la probabilité que cette proposition soit vraie. Vous pouvez demander si un message contient une demande de remboursement, si un appel d'outil est dangereux ou si un passage contredit une source.
Noul ne doit pas devenir une règle métier déguisée. Calculez les conditions exactes en code. Utilisez le modèle quand la décision dépend du sens d'un texte, pas pour comparer deux montants ou compter des éléments.
Où brancher Jev dans une startup
La meilleure place de Jev se trouve entre une donnée floue et une branche de code. Si votre équipe demande à un LLM de répondre par un label, Jev mérite un test. Si un humain doit lire la sortie, gardez un modèle génératif.
Trier et router les demandes
Une boîte support reçoit du texte libre, alors que l'organisation fonctionne avec des files précises. Jev peut choisir la file, évaluer l'urgence et signaler un risque dans le même appel. Votre code affecte ensuite le ticket, applique les SLA et demande une revue quand la probabilité est trop faible.
Le même motif fonctionne pour des leads, des retours utilisateurs ou des candidatures. Le travail important n'est pas l'appel API, mais la taxonomie : quelles catégories existent et quelle erreur coûte le plus cher ?
Filtrer les appels d'outil d'un agent
Un agent veut supprimer un fichier, envoyer un email ou modifier une facture. Avant l'exécution, Jev peut estimer si l'action est destructive, cohérente avec la demande et suffisamment documentée. Le code décide ensuite d'autoriser, de bloquer ou d'escalader.
Ce filtre ne transforme pas un agent en système sûr. Les permissions, validations déterministes et journaux restent nécessaires. Pour comprendre cette architecture, consultez notre guide des agents IA en production.
Choisir un modèle avant une tâche
Toutes les demandes ne justifient pas le même modèle. Jev peut envoyer une correction locale vers un modèle rapide, une migration vers un modèle robuste et une opération sensible vers un humain.
Ce routeur devient utile quand les règles accumulent les exceptions. Si quelques conditions déterministes suffisent, un if reste plus lisible et plus fiable.
Garder le code maître du workflow
Le modèle donne un jugement ; le code conserve les calculs, les autorisations, les limites de dépenses et les effets irréversibles.
C'est aussi la différence entre Jev et un orchestrateur. Paperclip coordonne plusieurs agents ; Jev répond à une décision dans cette orchestration. Jev ne planifie pas le projet et ne suit pas son état à votre place.
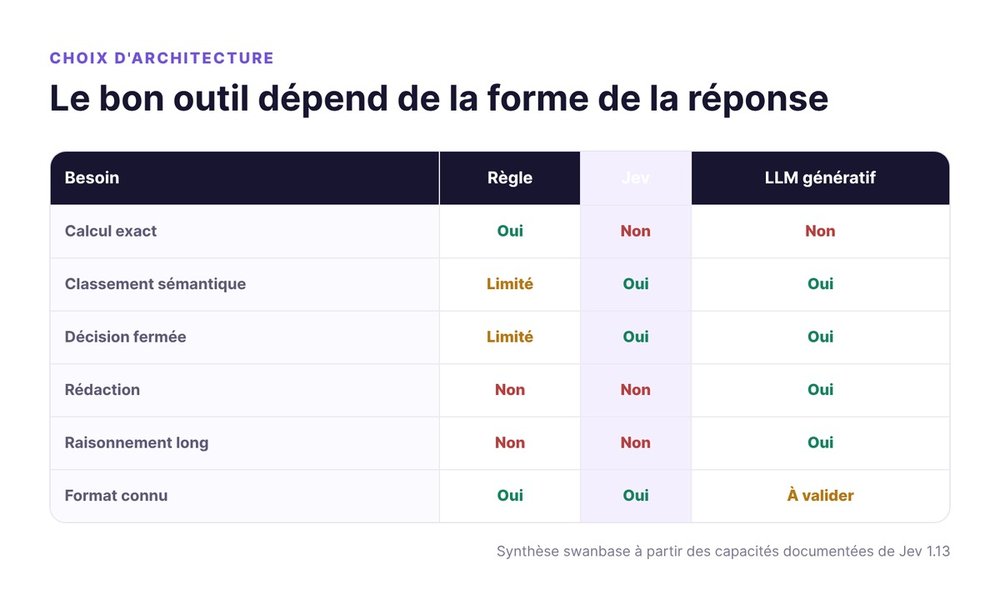
Jev AI ou LLM génératif : quel moteur pour quelle tâche ?
Jev AI ne gagne pas contre un LLM sur le même terrain. Il change de terrain.
| Besoin | Règle déterministe | Jev | LLM génératif |
|---|---|---|---|
| Calcul exact | Oui | Non | Non |
| Classement sémantique | Limité | Oui | Oui |
| Score ou décision fermée | Limité | Oui | Oui |
| Rédaction | Non | Non | Oui |
| Raisonnement long | Non | Non | Oui |
| Format connu à l'avance | Oui | Oui | À valider |
Moins de parsing et de reprises
Jev retire la génération de texte, le parsing d'une réponse libre et une partie des reprises liées au format. Jev fournit aussi la distribution des probabilités pour séparer les cas nets des cas ambigus.
La confiance mesure la netteté de la distribution produite par le modèle. Vérifiez sur vos données si les cas confiants sont effectivement plus souvent corrects.
La rédaction reste au LLM
Un LLM reste nécessaire pour écrire, résumer, produire du code ou explorer une question ouverte. Le LLM crée une sortie absente de la liste initiale. C'est précisément ce que Jev abandonne.
Une règle simple évite les erreurs d'architecture. Testez Jev pour un espace de réponses fermé. Utilisez un LLM pour créer la réponse. Écrivez du code pour un calcul exact.
Pourquoi les deux se complètent
Un agent peut recevoir une demande, demander à Jev de choisir une route, laisser un LLM exécuter la tâche, puis soumettre le résultat à un second contrôle typé. Le code conserve les seuils et les conséquences.
Cette séparation intéresse surtout les produits qui répètent le même jugement à fort volume. Avec quelques opérations par semaine, le gain peut rester inférieur au coût de maintenance. Notre sélection d'outils IA pour startup replace Jev dans le reste du stack.
Prix, vitesse et capacité de Jev
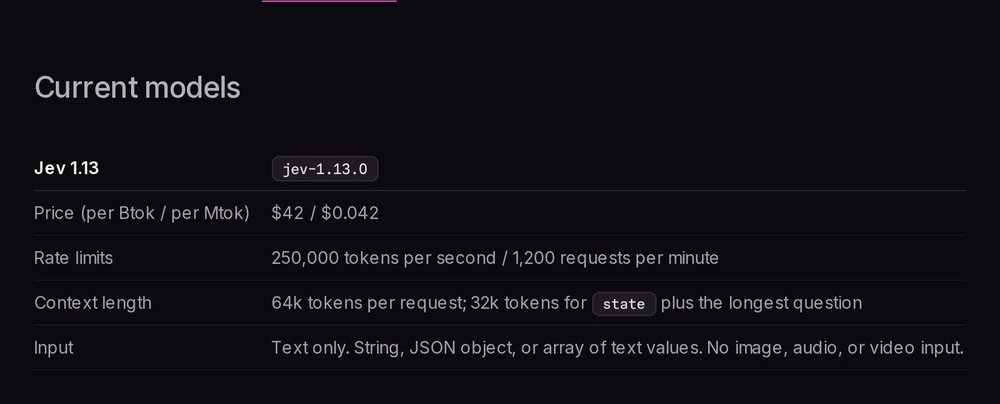
La fiche officielle de Jev 1.13 affiche un prix de 0,042 dollar par million de tokens en entrée. Les tokens de sortie ne sont pas facturés. Le modèle accepte du texte, un objet JSON ou un tableau de valeurs textuelles, mais aucune image, piste audio ou vidéo.
Le tarif officiel de Jev 1.13
Le tarif rend les petites décisions peu coûteuses. Surveillez surtout la taille du state. Envoyer le même dossier complet pour chaque question annule une partie du gain. Regroupez les questions qui lisent le même contexte et filtrez les informations inutiles.
Le prix publié concerne le service TypeSafe. Une passerelle peut appliquer sa propre tarification. Vérifiez le fournisseur appelé, pas seulement le nom du modèle.
Les limites de contexte et de débit
TypeSafe documente une limite de 64 000 tokens par requête, avec un plafond de 32 000 tokens pour le state additionné à la question la plus longue. La page affiche aussi 250 000 tokens par seconde et 1 200 requêtes par minute, tout en précisant que ces limites évoluent pendant l'early access.
L'anglais est la langue d'entraînement principale et la plus précise selon TypeSafe. Jev accepte le français, mais TypeSafe demande un test sur vos contenus. Pour une startup française, ce point compte plus qu'un multiplicateur mesuré sur un corpus anglais.
Comment lire les multiplicateurs annoncés
TypeSafe annonce une latence de 70 à 500 millisecondes et des gains allant de quarante à deux cents fois sur des requêtes en forme de décision. L'entreprise explique aussi que ses plus grands écarts proviennent de ses propres workflows et se situent dans le haut de la fourchette réelle.
Ces chiffres indiquent une direction, pas votre résultat. Mesurez le parcours complet, de la requête utilisateur à l'action du produit.
Les limites à connaître avant la production
TypeSafe documente les défauts de Jev 1.13.
Une sortie typée peut rester fausse
« Zéro hallucination » désigne chez TypeSafe l'impossibilité de sortir du schéma. Jev ne va pas inventer une quatrième catégorie si vous en avez défini trois. Jev peut toutefois sélectionner la mauvaise catégorie avec un objet valide.
Une probabilité n'est pas une preuve. Elle devient utile après calibration sur votre jeu de données : à partir de quel seuil les décisions automatiques atteignent-elles la qualité requise ? Sous quel seuil faut-il demander une revue ? Sans cette mesure, le nombre donne une impression de contrôle, pas du contrôle.
Les tâches exactes et les contextes difficiles
La page officielle sur les limites connues de Jev 1.13 liste la lecture littérale, les calculs, le comptage et les comparaisons de dates. Elle signale aussi les instructions indirectes, les états encombrés et les contenus adversariaux. TypeSafe recommande de conserver les opérations exactes dans le code.
Posez une question atomique avec des critères explicites. Ne mélangez pas l'interprétation avec un comptage. Gardez aussi les dates et la sanction dans le code. Décomposez le jugement, puis assemblez les résultats.
Français, données et disponibilité
Le support du français n'est pas présenté au même niveau que l'anglais. Construisez donc des exemples français, avec vos abréviations, vos fautes réelles et vos cas ambigus. Tester des phrases traduites proprement donnerait une image trop favorable du produit.
TypeSafe indique que Jev n'est pas entraîné sur les requêtes et réponses de ses clients. TypeSafe réserve la rétention zéro aux clients entreprise. Si votre state contient des données sensibles, validez les conditions contractuelles avant l'intégration.
jev-latest est un alias mobile. Épinglez la version testée, journalisez le modèle retourné et choisissez le moment de la migration.
Comment évaluer Jev sur vos propres données
Ne commencez pas par remplacer un modèle en production. Commencez par rejouer des décisions déjà prises.
Construire un jeu de cas annotés
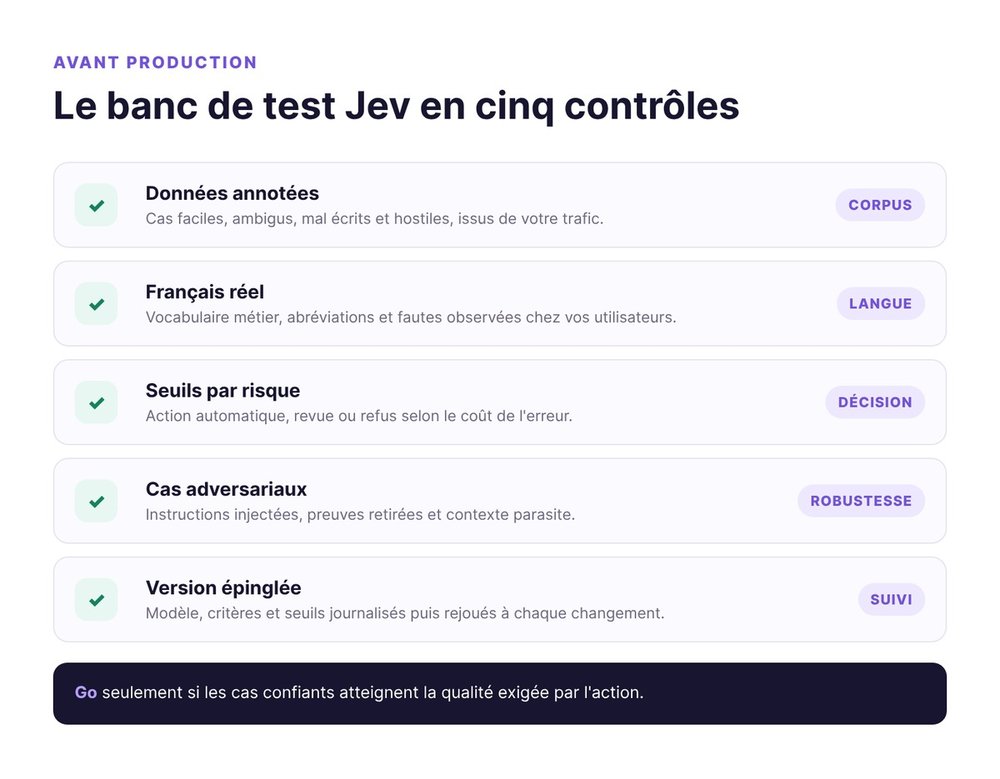
Prenez des entrées réelles et anonymisées. Faites-les annoter selon la taxonomie que votre produit utilise déjà. Gardez des cas faciles, ambigus, mal écrits et hostiles. Une démo composée uniquement d'exemples évidents mesure surtout votre capacité à choisir de bons exemples.
Séparez les données de réglage et d'évaluation. Améliorez les instructions sur le premier lot, puis mesurez le second.
Mesurer la qualité par seuil de confiance
Ne calculez pas seulement une précision moyenne. Triez les réponses par confiance et observez la qualité de chaque tranche. Votre objectif est de découvrir une zone où le système peut agir seul, une zone qui exige une vérification et une zone qu'il doit refuser.
Le seuil dépend du coût de l'erreur. Router un écran vers le mauvais onglet est réversible. Autoriser un remboursement ou exécuter une commande destructive ne l'est pas. Le même score ne peut pas gouverner ces deux actions.
Tester les cas adversariaux et les changements de version
Placez dans le state des phrases qui tentent de modifier les instructions, puis inversez les formulations. Ajoutez des informations inutiles et retirez la preuve nécessaire. Évaluez le modèle sur le trafic réel, pas seulement dans le playground.
Versionnez les critères, les seuils et le modèle. Rejouez le banc de test à chaque changement. Cette discipline coûte moins qu'une mauvaise décision répétée automatiquement.
Exemple d'appel API pour router un ticket
L'appel HTTP tient dans un objet. La difficulté se trouve dans la qualité des catégories et dans le traitement après la réponse.
Requête HTTP minimale
La procédure de démarrage officielle utilise l'endpoint /v1/systemone et le modèle jev-latest.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "Le paiement est passé deux fois et je veux un remboursement.",
    "questions": {
      "route": {
        "type": "choice",
        "instructions": "Quelle équipe doit traiter ce message ?",
        "criteria": {
          "billing": "Paiement, facture ou remboursement",
          "technical": "Bug, panne ou intégration",
          "other": "Aucune des catégories précédentes"
        }
      },
      "urgent": {
        "type": "noul",
        "instructions": "Ce message exige-t-il une intervention immédiate ?"
      }
    }
  }'
Décider dans le code après la réponse
Votre application lit answers.route.choice, sa distribution de probabilités et answers.urgent.noul. Le code applique les seuils mesurés, vérifie les permissions et conserve une route de revue au lieu d'exécuter aveuglément l'option gagnante.
Le routage, l'urgence et le risque sont des jugements distincts. Des questions séparées rendent les erreurs observables et les critères modifiables.
Notre verdict sur Jev de TypeSafe AI
Jev apporte une primitive utile à un endroit où beaucoup d'équipes surdimensionnent leurs LLM : les décisions fermées et répétitives. Son intérêt ne tient pas au slogan « moins cher ». Il tient à une interface conçue pour le code, avec des sorties connues et une incertitude exploitable.
Quand lancer un prototype
Testez Jev si votre produit classe du texte à volume régulier, force déjà un LLM à répondre en JSON ou a besoin de décider quand escalader vers un humain. Le prototype doit partir d'un historique annoté, en français si vos utilisateurs écrivent en français.
Jev peut aussi servir de brique dans une entreprise automatisée, aux côtés des outils décrits dans notre test de NanoCorp. Jev ne fournit ni l'orchestration complète, ni la mémoire, ni la génération. C'est un réflexe, pas un cerveau central.
Quand rester sur des règles ou un LLM
Restez sur des règles si la décision est exacte et stable. Gardez un LLM si la réponse doit être créée, expliquée ou construite en plusieurs étapes. Conservez une revue humaine lorsque l'erreur touche de l'argent, des droits, des données sensibles ou une action irréversible.
Notre verdict : Jev mérite un banc de test ciblé, pas une migration générale. Son contrat typé supprime une classe d'erreurs. Votre évaluation doit encore prouver qu'il prend les bonnes décisions dans votre contexte.
Questions fréquentes sur Jev AI
Jev remplace-t-il ChatGPT ou Claude ?
Non. Jev choisit, score ou estime une probabilité dans un espace de réponses défini. ChatGPT ou Claude restent adaptés à la rédaction, au dialogue, au code et au raisonnement ouvert. Les deux moteurs peuvent fonctionner dans le même workflow.
Jev peut-il générer du texte ?
Non. Jev 1.13 n'est pas entraîné pour générer des chaînes de texte. Pour une réponse client, utilisez Jev pour décider de la route ou du ton, puis un modèle génératif pour rédiger.
Jev fonctionne-t-il en français ?
Jev accepte le français, mais TypeSafe indique que l'anglais reste sa meilleure langue. Avant production, évaluez-le sur des messages français réels, avec votre vocabulaire et vos erreurs courantes.
Combien coûte Jev ?
TypeSafe affiche 0,042 dollar par million de tokens en entrée pour Jev 1.13, sans facturation des tokens de sortie. Une passerelle tierce peut appliquer un tarif différent.
Jev peut-il prendre une mauvaise décision ?
Oui. La réponse respecte le type demandé, mais le choix ou la probabilité peut être incorrect. Mesurez la qualité sur vos données, appliquez des seuils adaptés au risque et prévoyez une revue pour les cas incertains.
Prenez vingt décisions déjà tranchées par votre équipe, anonymisez-les et transformez-les en premier banc de test Jev. Notez chaque erreur avant de décider si le modèle mérite une place dans votre produit.